直面行业三大合规与成本痛点,提供自主可控的底层算力支撑
核心业务数据不上云,已成为政企市场的刚性铁律。我们提供 100% 纯私有化运行环境,从物理层面杜绝录音数据外泄与云端大厂“数据裹挟”风险,满足公检法、金融机构严苛的合规审查,让安全不再是业务的绊脚石。
告别按时长、按调用次数计费的云端 API 无底洞。一次性买断本地算力,即可享受无限次的语音转写与大模型推理。业务量越大,边际成本越低,帮助企业彻底砍掉每年数十万甚至百万级的公有云订阅费。
专为涉密机房、矿山、军工等无法连接公网的物理隔离环境设计。在完全断网的状态下,依然保持极高的语音识别率与大语言模型分析能力,确保业务在任何极端网络条件下都能持续、稳定运转。
在普通服务器上跑通的千亿级大模型,释放语音数据真实价值
即使在嘈杂的多人会议或审讯环境中,也能精准捕捉语音并转化为高质量逐字稿。系统自动声纹识别并剥离不同说话人(如说话人1、说话人2),附带精确到毫秒的时间戳,让每一句核心对话都有据可查,完美应对长音频挑战。
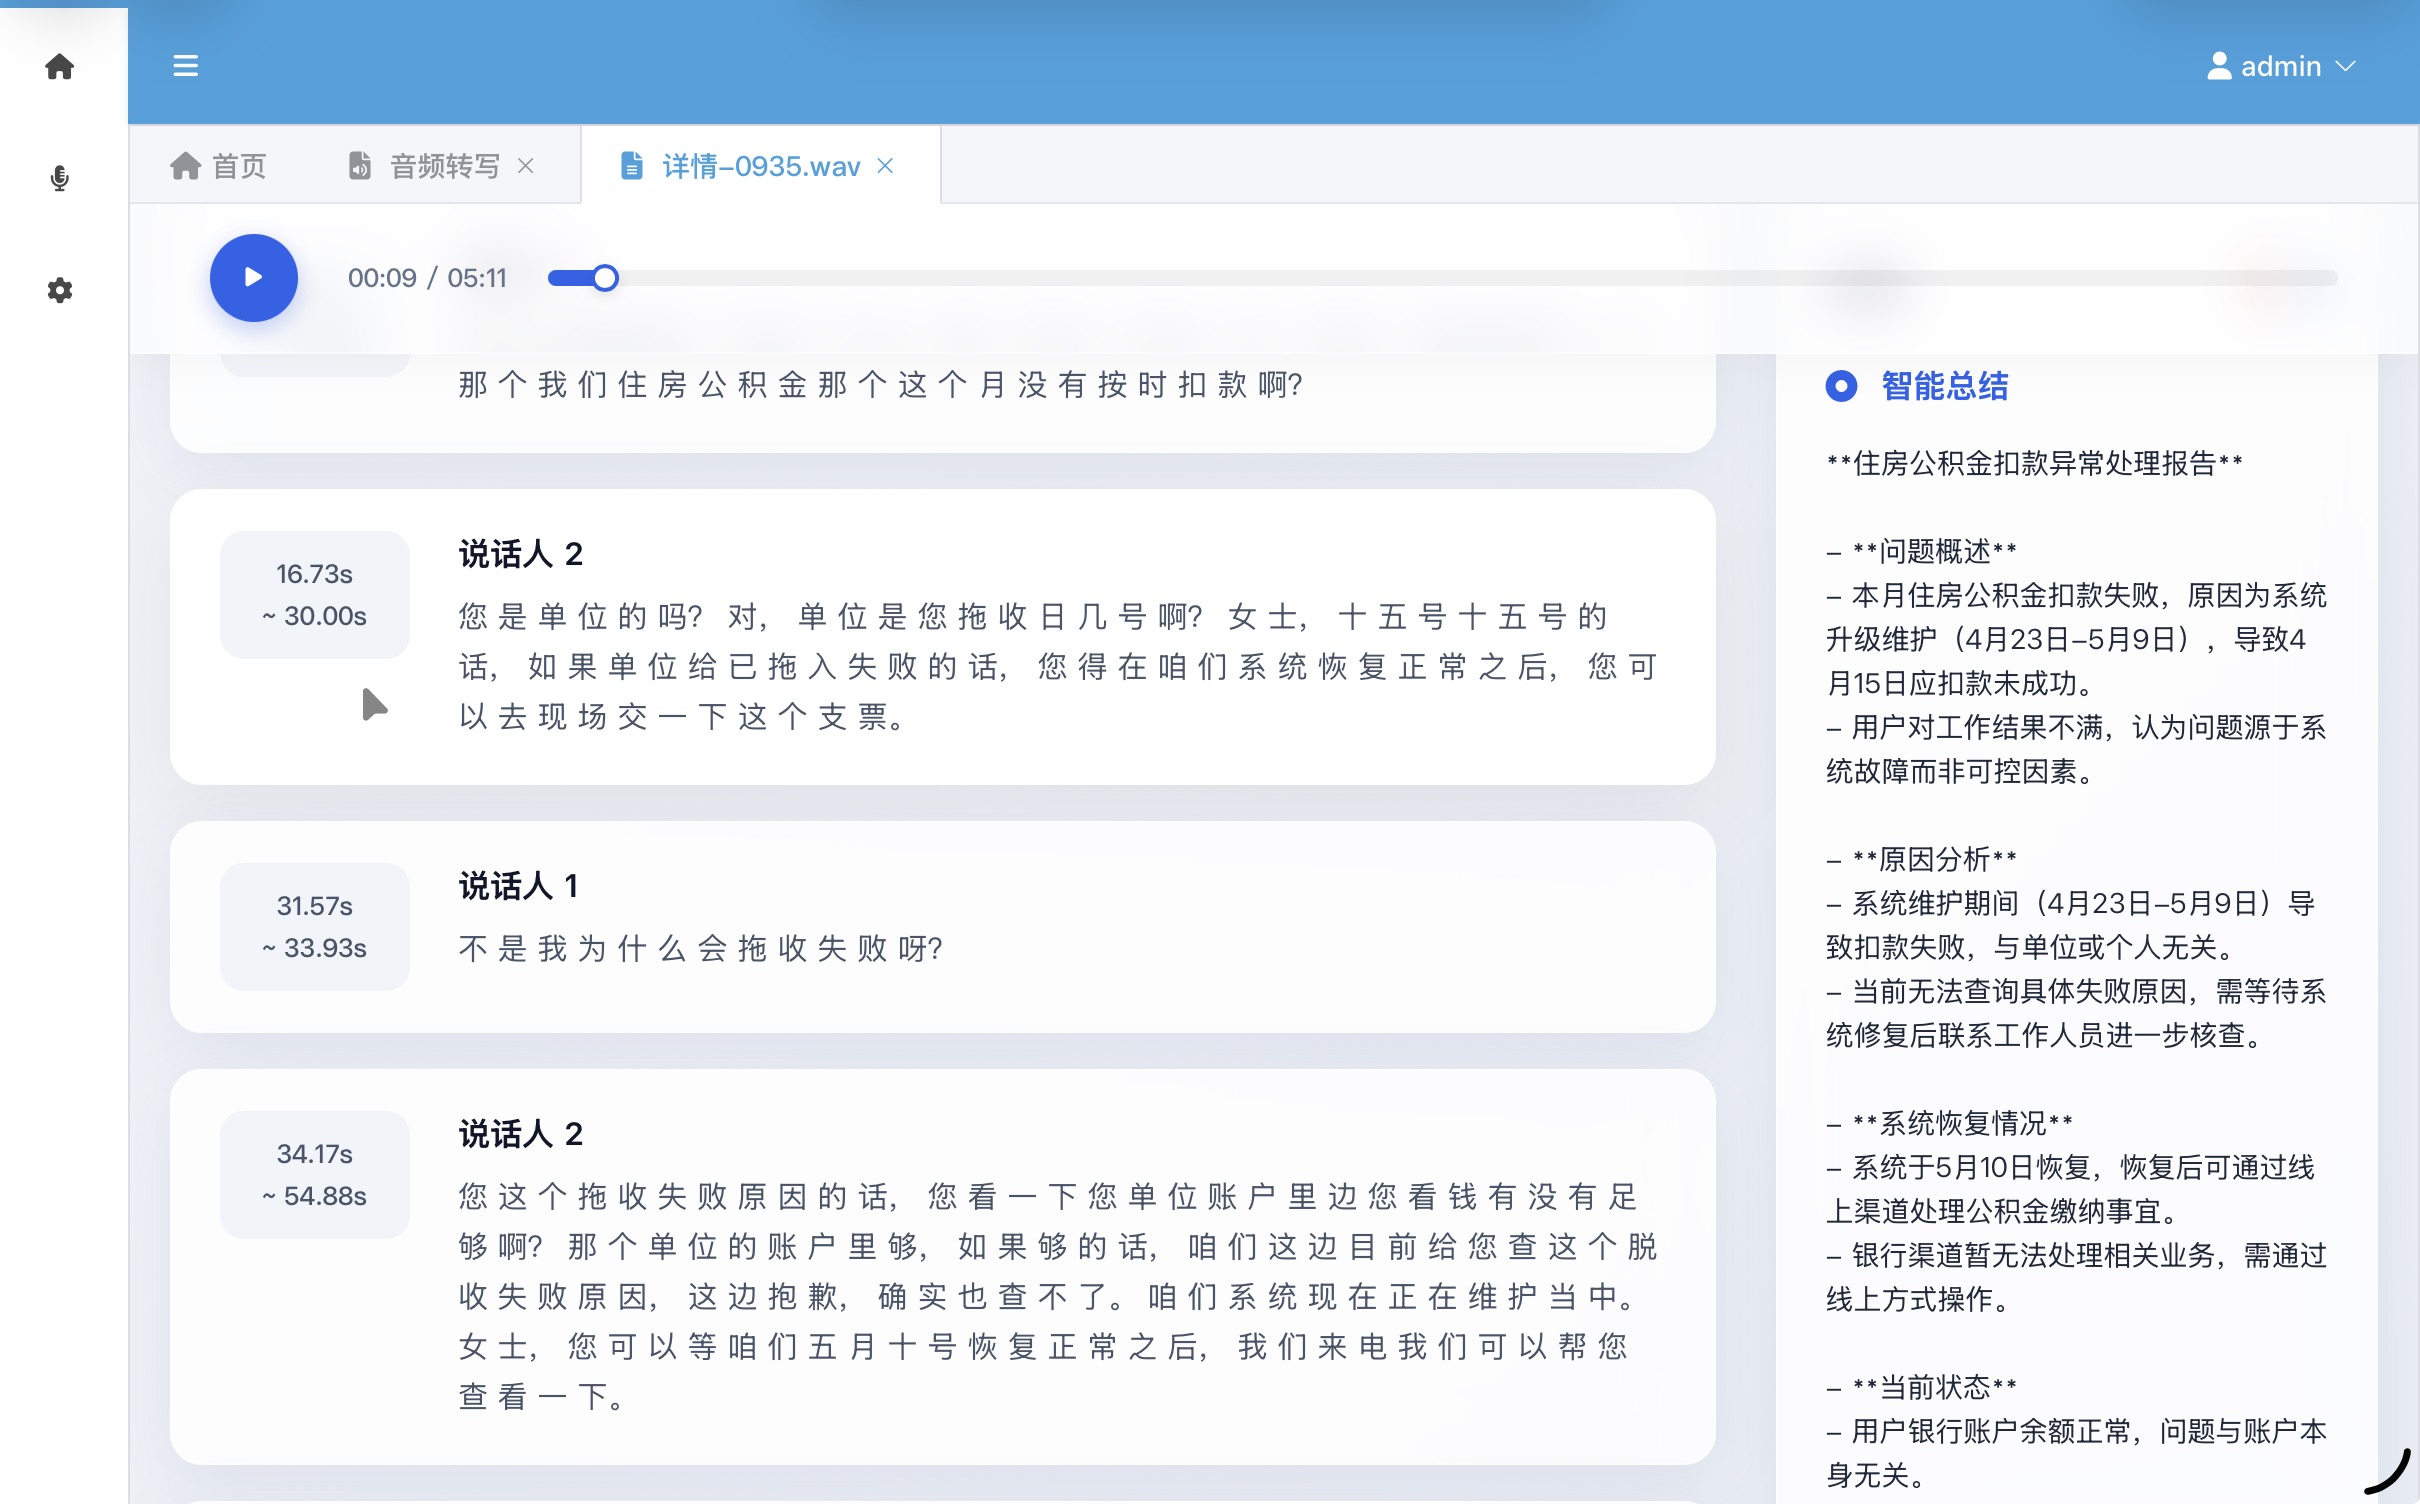
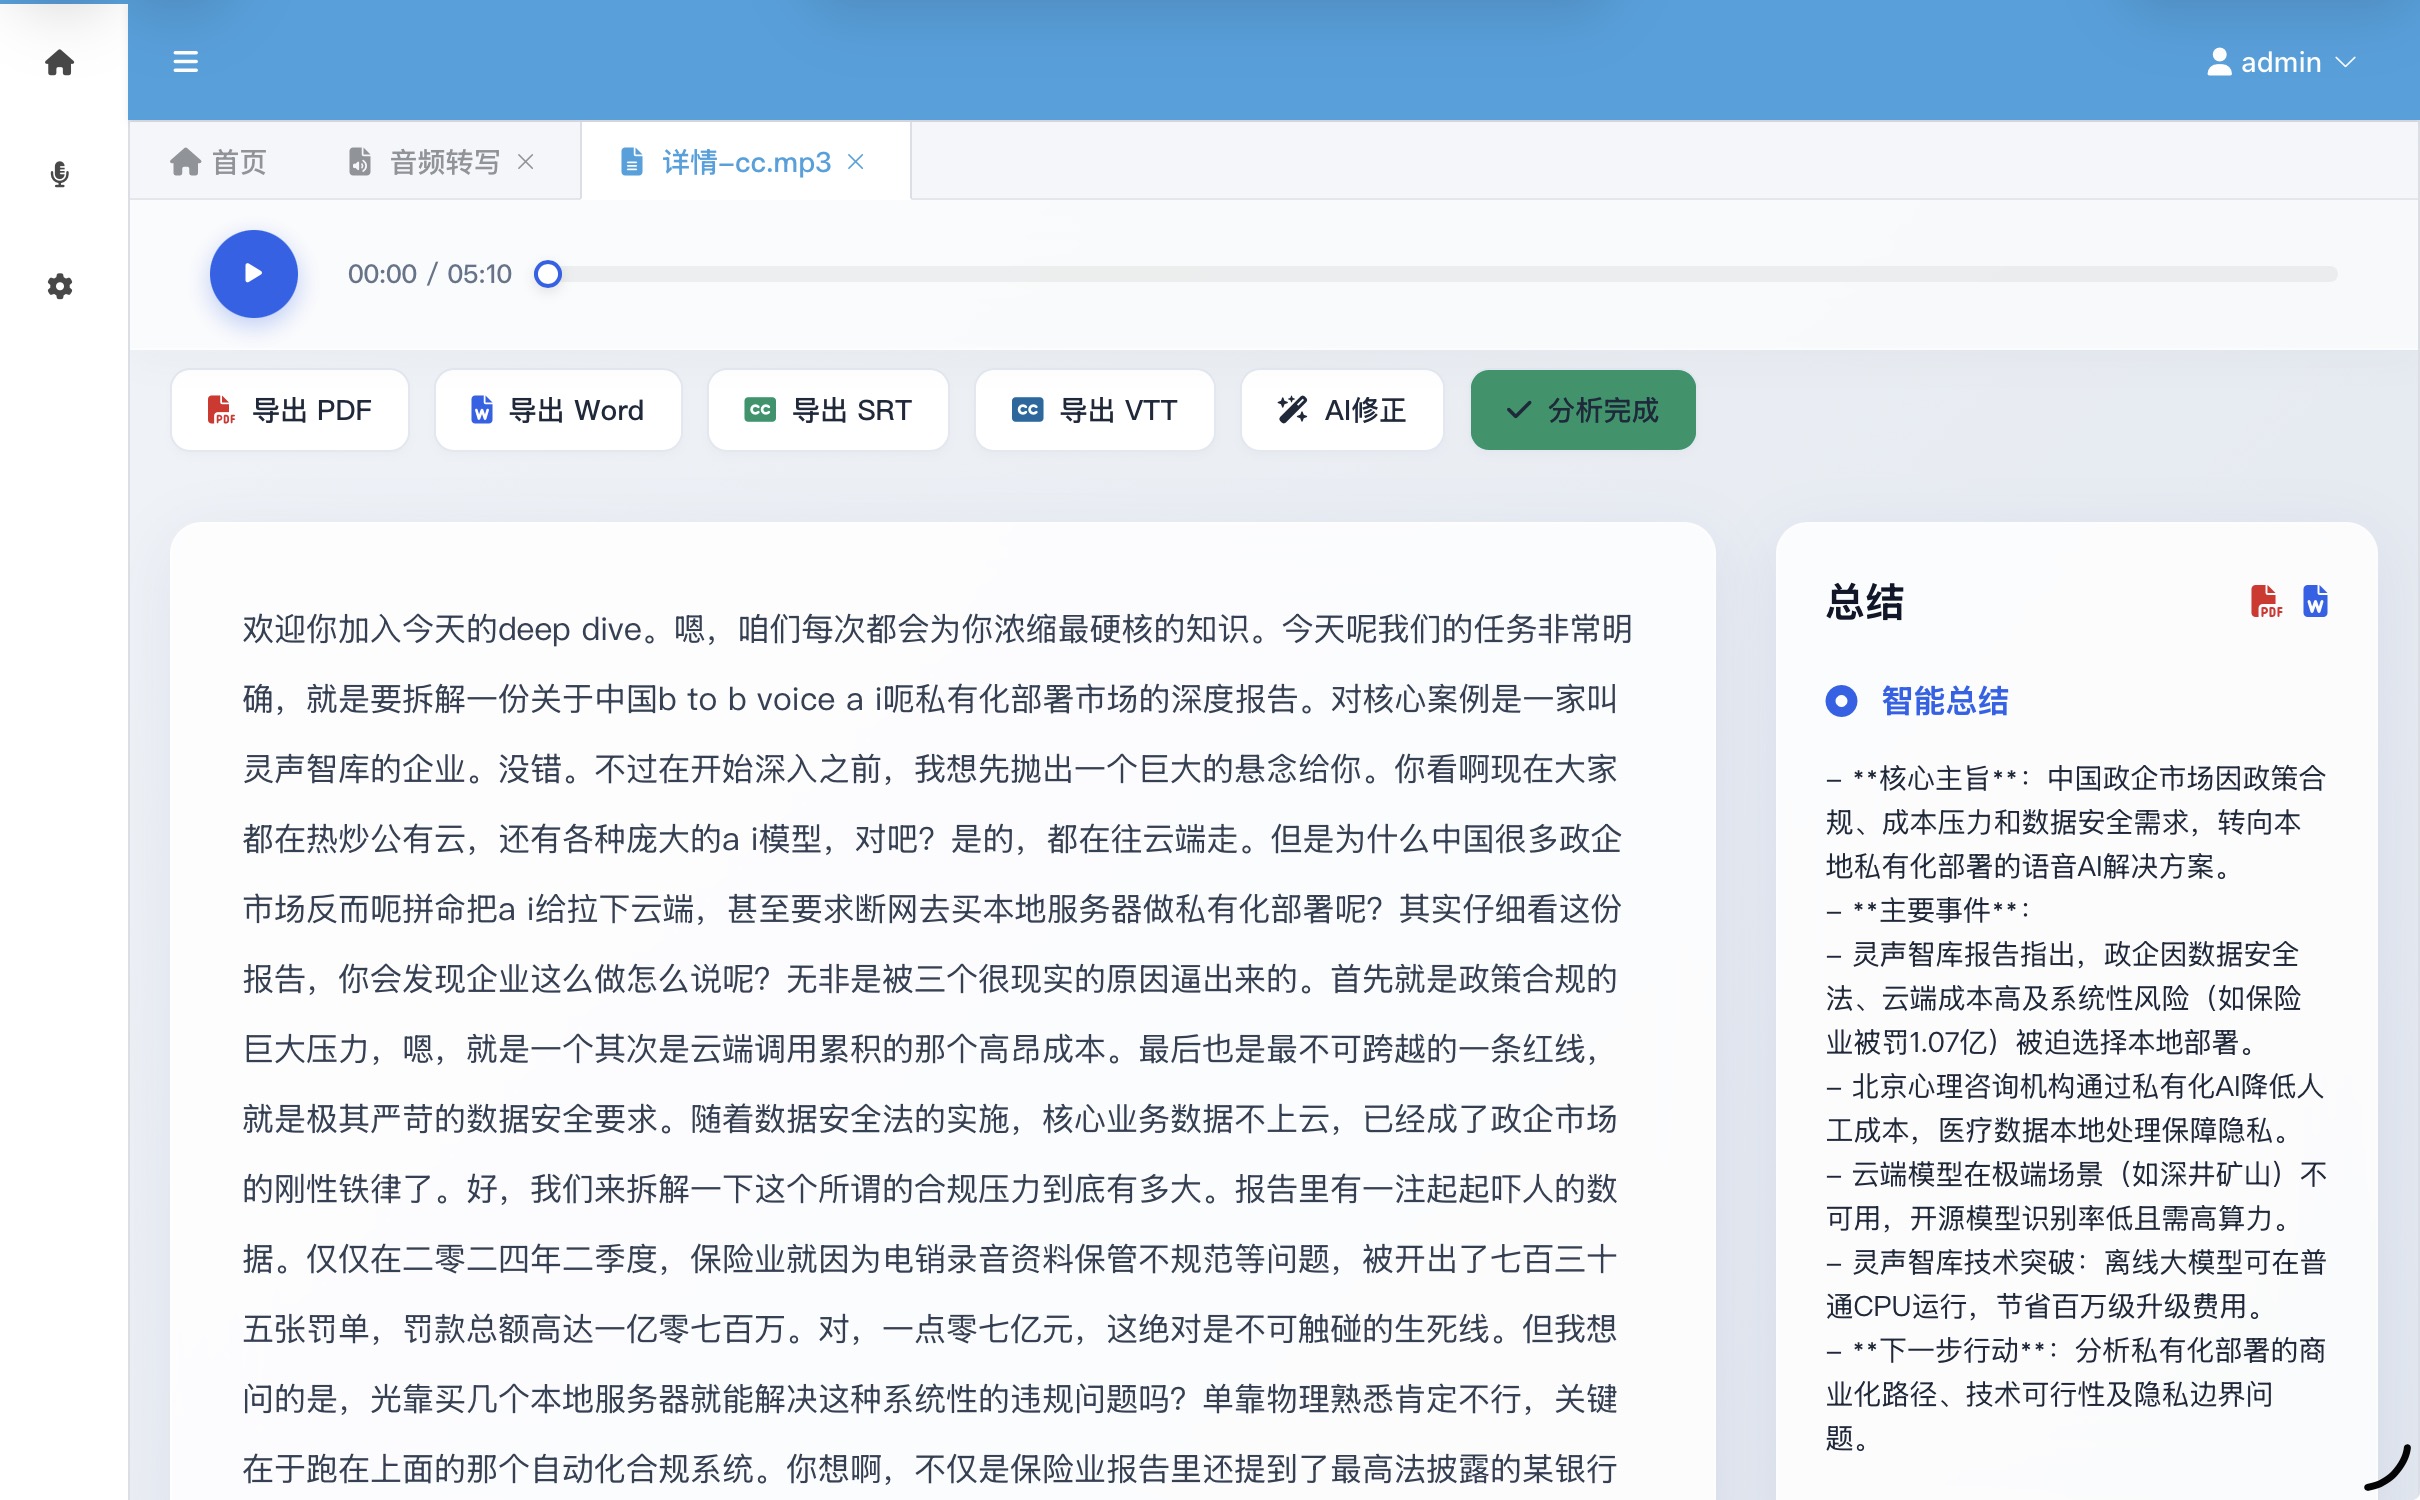
告别耗时的人工提炼。内置针对政务与商务场景深度优化的离线大语言模型。系统可自动在侧边栏生成结构化报告,精准提取“核心主旨、问题概述、原因分析及下一步行动”,将几小时的长录音瞬间浓缩为高价值的业务决策情报。
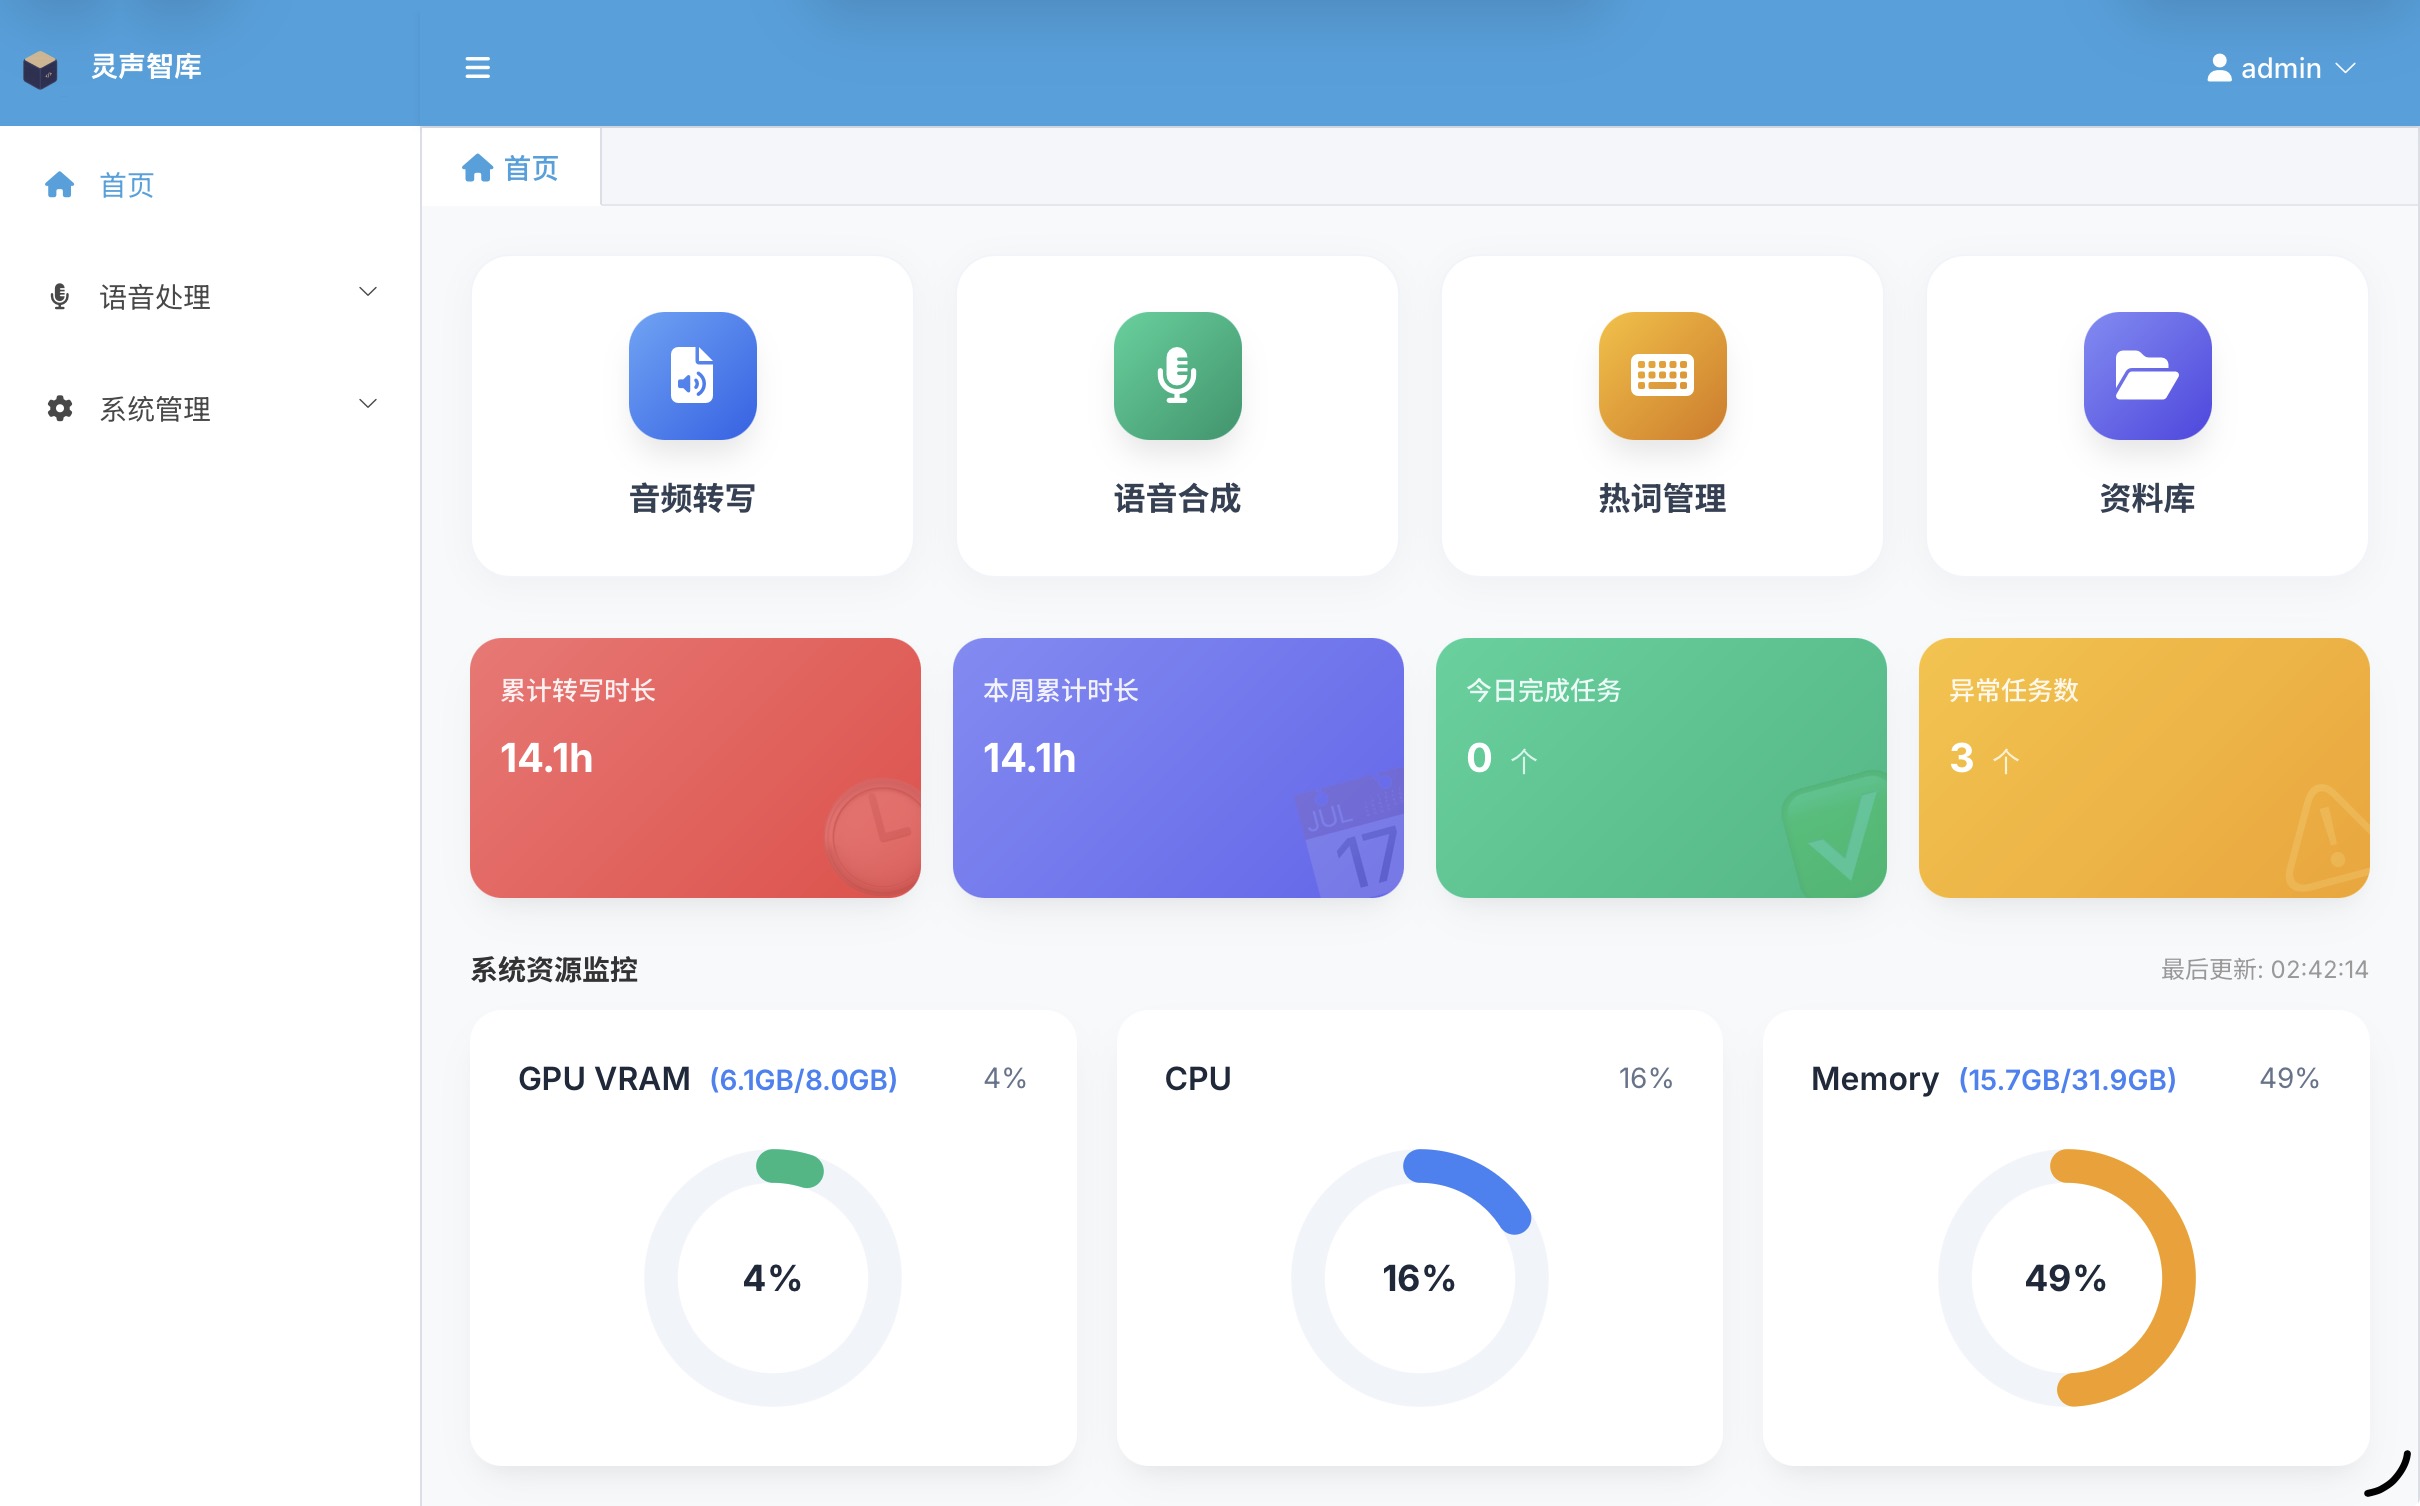
突破传统大模型对顶级高端显卡的依赖。经过深度的底层算力优化,可在普通 CPU 服务器或极其有限的 GPU 显存(如 8GB VRAM)下流畅运行。提供直观的可视化监控看板,实时掌握算力负载,让本地运维降本增效。
围绕本地部署、信创适配、RAG 知识库与断网场景建立专题聚合,帮助搜索引擎更快理解站点主题,也方便客户集中阅读。
持续更新私有化大模型、信创适配、断网部署与 RAG 知识库相关实践,帮助搜索引擎和访客快速发现网站核心内容。
探讨投机解码(Speculative Decoding)与声学草稿模型双轨协同流水线,解构树状注意力并行验证机制在百亿参数级端到端ASR大模型推理吞吐翻倍实操。
剖析时序连续声学神经编解码器结合时空掩码图聚类的多说话人盲源分离架构,在强混响与多人重叠交叠声场下实现千小时级政企会议高保真离线声学解析的工程实操。
深入解构Mamba-Attention混合状态空间拓扑与动态稀疏KV Cache在原生全双工端到端语音大模型中的工程实测,剖析信创算力下亚50ms超低时延与万路高并发流式语音会话的底层突破。
深入剖析基于可信执行环境(TEE)与全同态加密结合的涉密专网语音处理架构,解构在物理隔离环境下从采集、传输、推理到持久化归档的声学全生命周期零信任防护。
解构基于纯整数加法脉动阵列与FP4/INT4混合精度的边缘端侧声学计算架构,在-15dB极端强噪与极低功耗限制下实现全离线语音唤醒与指令识别的实测突破。
解构多头潜在注意力(MLA)低秩联合压缩算法,剖析在128k超长上下文与多轮会议转写中解耦Key-Value显存占用的底层工程架构。