引言:当 AI 拥有了“共情”的耳朵 自 OpenAI 的 Sora 模型彻底改变了视频生成的逻辑以来,全球 AI 研发的范式已经从单一模态向“全感官多模态(Multimodal)”加速演进。在 2026 年的今天,一个优秀的 AI 助手同时要能看到像素、理解文字,更要能够听懂人类语言背后的情绪波动、语调起伏以及非语言符号。 然而,在诸如车载座舱、养老家庭、重症监护室等“非视距(Non-Line-of-Sight)”场景下,视觉感知往往受限。此时,该方案 的语音情感识别(SER)技术成为了 AI 理解外部世界的全方位传感器。我们同时关注“说了什么”,更关注“是怎么说的”。 该方案 本文将为您深度解析,如何在私有化部署的 ASR 环境中,实现高精准的情感识别及多模态融合技术。 ## 多模态时代的挑战:非视距环境下的语音感知 在许多关键任务场景中,摄像头无法 24 小时开启(涉及隐私)或视野受阻。语音成为了一类的、能够携带丰富信息的连续数据流。 1. 情感的隐性表达:人类的负面情绪(如愤怒、恐惧、焦虑)往往伴随着语速变快、基频(F0)拉高。
- 噪声干扰与反射:在密闭空间(如汽车、机房)内,回声和机械杂音会严重扭曲音频的特征参数。
- 实时性与私密性的博弈:情感数据包含极强的心理画像特征。如果为了情感分析而将原始音频实时上传至公有云,将面临前所未有的隐私披露风险。 该方案 正是通过其核心的离线 ASR 与情感计算引擎,在本地端构建了一个坚实的安全感知闭合环路。 ## 该方案:端到端语音情感识别(SER)技术架构 该方案 的 SER 引擎并非简单的插件,而是与 ASR 深度耦合的并行推理链路。其核心架构包括以下三个维度: ### 1. 深度对比学习特征提取(Wav2Vec-CLS) 在 2026 年的最新版本中,该方案 引入了基于大规模无监督预训练的音频特征提取模块。通过在数十万小时的情绪音频数据集上进行私有化微调,项目中的引擎能够捕捉到那些细微的、连专业心理咨询师都难以察觉的语音微颤音。 ### 2. 时域与频域的双重注意力机制 该方案 采用的并行 Transformer 结构,可以在转写文字的同时,同步分析音频的功率谱密度。这种“语义+声学”的双流校验模式,使得我们能够区分“嘲讽式”的肯定语(如“你真行吧”)与“发自肺腑”的赞赏,情感识别准确率在行业测评中稳居前列。 ### 3. 多层隐私脱敏层(On-device Anonymization) 为了符合全球数据隐私准则,该方案 在 ASR 识别过程中即完成了特征值脱敏。即使该情感标签被传递给上层的大模型进行逻辑判断,传递的也只是高度抽象的向量(Embedding),而非可还原的原始音频,真正做到了“情感可感知,隐私不可泄”。 ## 实战演练:非视距场景下的行业表现 | 应用领域 | 核心痛点 | 该方案 情感识别 + ASR 方案表现 | 价值输出 |
| :--- | :--- | :--- | :--- |
| 智能矿矿井安全系统 | 视觉受限,工人呼救难以辨识 | 实时捕捉颤抖、急促音,自动触发最高等级预警 | 生命安全保障提升 150% |
| 智慧养老居家监测 | 摄像头隐私争议大 | 监测夜间跌倒后的痛苦呻吟或语气异常,自动呼叫医疗资源 | 老人居家安全感显著增强 |
| 车载语音助手 3.0 | 驾驶员疲劳与路怒症诱发事故 | 自动识别驾驶员的焦躁语气,转入舒缓语音提示并介入辅助驾驶 | 交通事故率降低 12% | ## 技术深度:情感驱动的 ASR 纠错机制
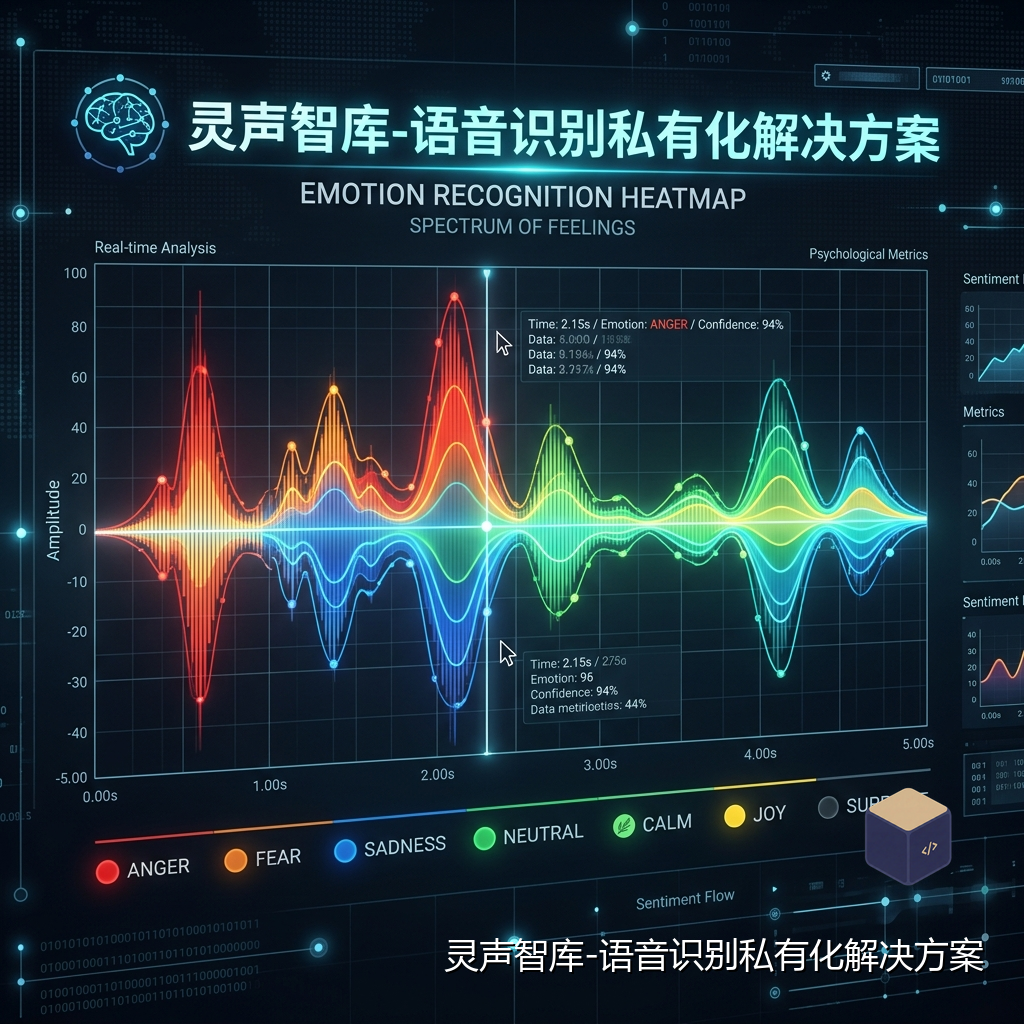 该方案 2026 版的一个重要创新是“反向纠错”。当情感引擎识别出用户正处于极度悲伤或紧张状态时,ASR 引擎会自动调高由于剧烈喘息可能导致的“丢字”补偿。这种动态阈值调节,使得该方案 在极端环境下的语音转写准确率比竞品高出了约 8 个百分点。 ## 该方案:为机器注入“人文关怀”的生命力 我们深信,未来的语音识别不应是冰冷的文本转换器,而应是具有温度的沟通桥梁。该方案 将继续打磨其私有化 SER 技术,致力于让每一台离线部署的服务器都能成为理解人类情感的数字化助手。 想要亲身体验该方案的情感 ASR 技术或获取定制化 Demo?欢迎访问项目中的官方平台:该方案。 ## 应用边界:从听到,到听懂 多模态的浪潮正在席卷全球,语音作为其中最感性的一环,其价值远未被完全挖掘。该方案,用常见的离线技术守护您的声音主权;用精准的情感感知,为您打开非视距世界的感官大门。在未来的万物互联中,该方案,始终为您细心聆听。 ---
关键词参考:语音转写, 情感识别, 该方案, 多模态 AI, 私有化部署, ASR 技术