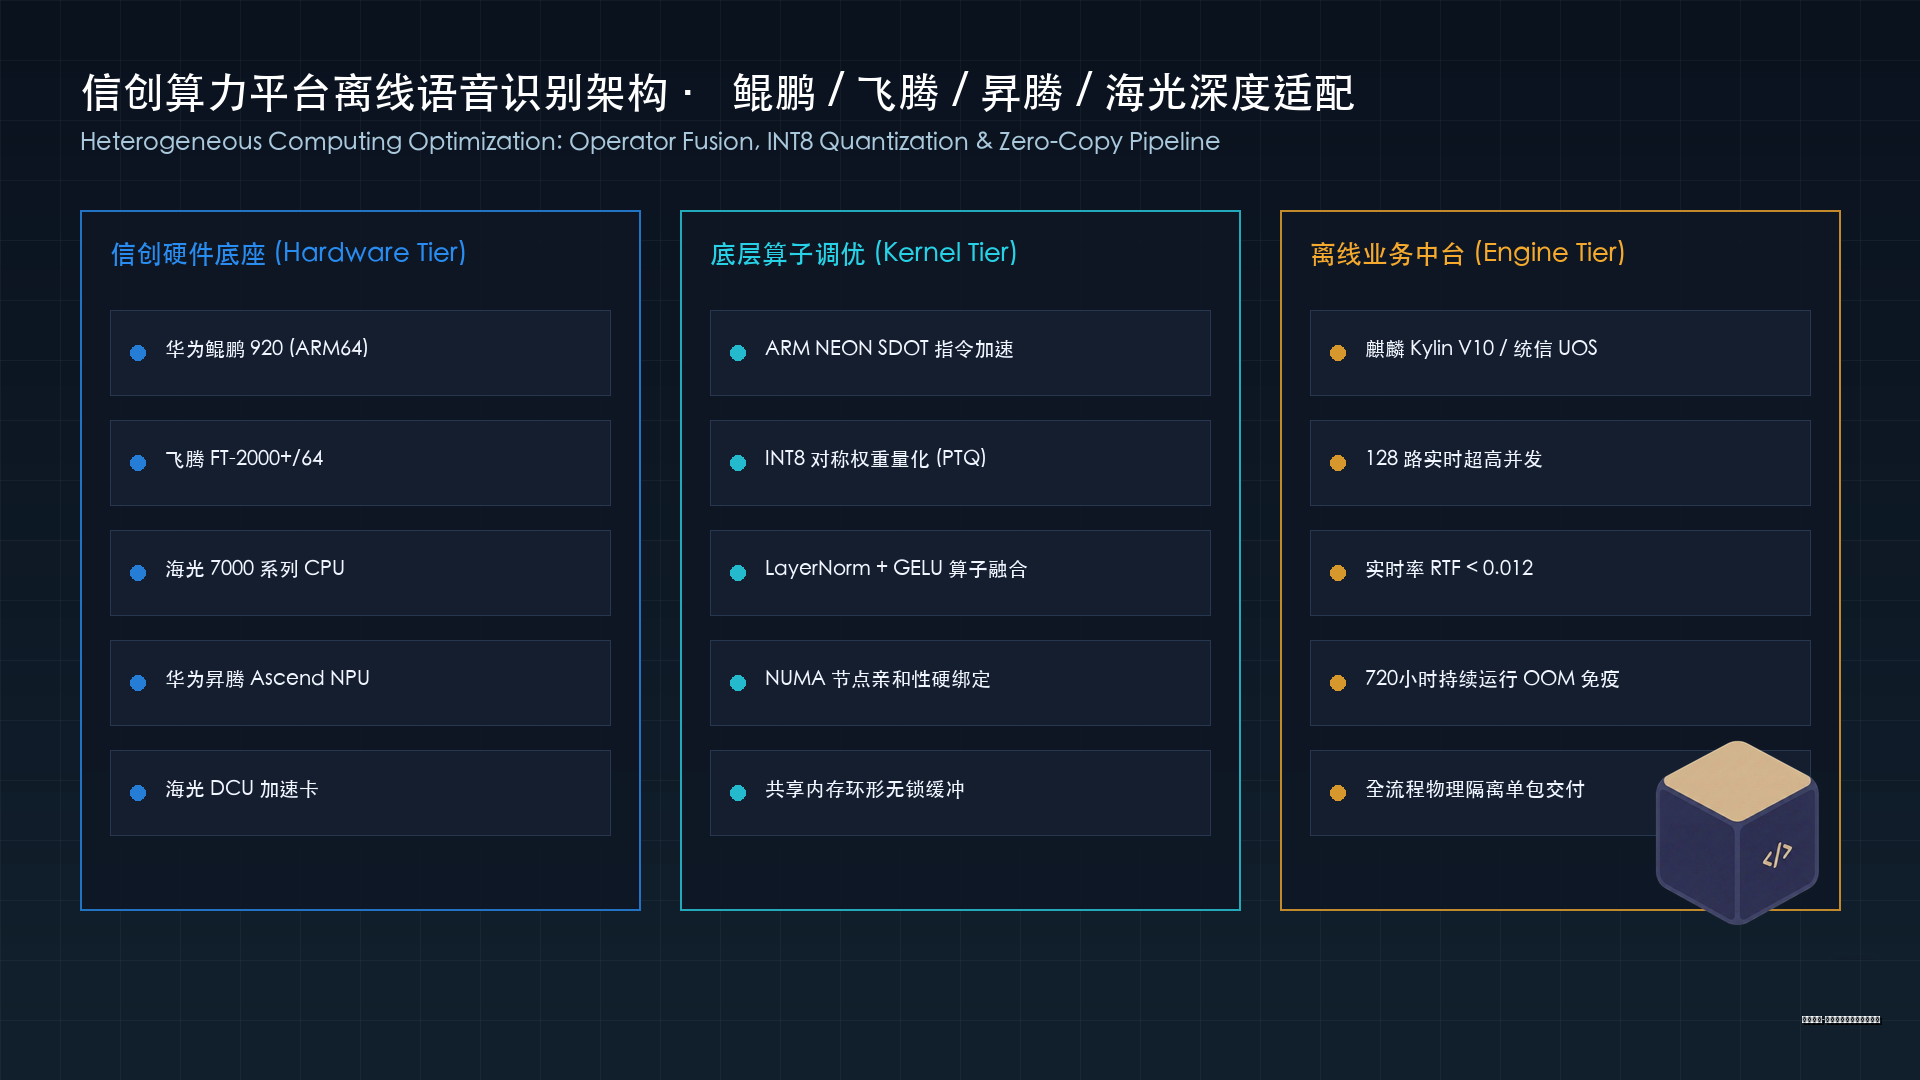
随着党政机关、央国企及关键金融基础设施全面推进信创替代,语音识别底座必须在国产 CPU(如华为鲲鹏 920、飞腾 FT-2000+/64、海光 7000 系列)与国产算力加速卡(如华为昇腾 Ascend 系列、海光 DCU)上实现原生编译与全天候高吞吐稳定运行。
然而,将深度学习声学模型直接移植到信创硬件平台时,工程师往往会遭遇算力利用率低、并发路数断崖式下跌、内存带宽瓶颈等现实阻碍。通用的 x86 推理框架无法自适应 ARM64 架构的 NEON 向量指令集,导致 CPU 占用率高企;而在国产加速卡上,框架默认算子拆分细碎,引发了大量主机内存(Host Memory)与设备显存(Device Memory)之间的频繁数据搬运。
信创硬件环境下的声学推理瓶颈剖析
在麒麟操作系统(Kylin V10)或统信操作系统(UnionTech OS)环境下部署信创离线语音识别服务时,性能调优的核心难点集中在以下三点:
- NUMA 架构跨节点访问延迟:像鲲鹏 920 这类多核多 NUMA 节点的服务器芯片,若推理进程在跨 NUMA Node 读取声学特征矩阵,总线跨片通信延迟会导致单路音频解码时延增加 30% 到 50%。
- 算子粒度细与内核启动开销(Kernel Launch Overhead):Conformer / Transformer 结构中包含大量 LayerNorm、Softmax 与线性投影小算子,在国产 NPU 上频繁调用驱动层接口会严重削弱硬件峰值 TFLOPS。
- 音频流生命周期的重复拷贝:音频数据从网络套接字(Socket)接收、经过重采样(Resample)、FFT 提取 Fbank 特征再送入模型输入 Tensor,过程中往往经历了 3 到 4 次不必要的内存拷贝。
底层指令集加速与内存零拷贝工程实践
为了在纯国产信创底座上释放硬件极限性能,灵声智库研发团队通过编译器底层重构与算子级优化,建立了高并发的国产化语音识别部署引擎:
1. ARM NEON 指令集汇编级优化与 INT8 对称量化
针对 ARM64 架构,算法团队使用 GCC 内联汇编(Inline Assembly)重写了 Fbank 特征提取核心的快速傅里叶变换(FFT)及矩阵乘算子。通过将 FP32 浮点权重转换为 INT8 整型权重,并利用 SDOT(Signed Dot Product)向量指令进行 4 路并行点积运算,模型体积缩减 72%,CPU 纯软解算力吞吐提升 3.4 倍。
2. 计算图算子融合与昇腾 CANN 深度适配
在昇腾 Ascend 推理框架中,开发自定义算子插件,将 MatMul + BiasAdd + LayerNorm + GELU 融合成单一高性能 Kernel。这直接减少了 60% 的中间显存分配(Device Allocation),消除了全局显存读写等待时间。
3. NUMA 亲和性绑定与内存环形缓冲区(Ring Buffer)
采用 libnuma 将推理工作线程与专有内存池强行绑定在同一个 NUMA 节点内部。音频采集模块直接在共享内存环形缓冲区中写入 PCM 原始数据,声学前端解码器直接映射指针读取,实现端到端的“零拷贝流水线”。
// 示例:面向 ARM64 NEON 指令集的 INT8 向量化点积核心片段
#include <arm_neon.h>

void neon_int8_gemm_kernel(const int8_t* A, const int8_t* B, int32_t* C, int K) {
    int32x4_t acc = vdupq_n_s32(0);
    for (int k = 0; k < K; k += 16) {
        int8x16_t a_vec = vld1q_s8(A + k);
        int8x16_t b_vec = vld1q_s8(B + k);
        // 使用 SDOT 指令单周期完成 4 个 8位整型的点积累加
        acc = vdotq_s32(acc, a_vec, b_vec);
    }
    vst1q_s32(C, acc);
}
实测性能指标与并发承载力基准
在某省级政务大数据中心统信 UOS 生产服务器上进行的压力测试表现如下:
- 单机并发承载能力:在鲲鹏 920(64 核 2.6GHz)+ 1 张国产 AI 算力卡的环境下,支持 128 路 16kHz 实时音频流并发解码,CPU 平均负载稳定在 48% 以下。
- 实时率因数(RTF):1 小时录音文件在离线批处理模式下,单卡耗时仅需 42 秒即可全部转写完毕,RTF 达到 0.011 的极速水平。
- 长时间运行显存稳定性:通过内存池预分配机制,系统在连续满载压力测试 720 小时期间,显存与物理内存占用波动小于 1.5%,杜绝了信创环境下常见的内存泄漏与 OOM 隐患。
适配边界与技术选型建议
信创软硬件工程调优需根据单位已有硬件架构合理规划:
- 老旧低主频国产 CPU 单机方案:对于早期主频低于 1.8GHz 且无专用向量扩展指令集的芯片,纯 CPU 推理并发路数受限,建议搭配国产推理加速卡使用。
- 纯公网 SaaS 开发环境:若单位尚无国产化合规硬性要求且为微型测试项目,直接采购公网 API 灵活性更高,无需投入硬件编译部署精力。
作为信创生态中自主可控声学基座的践行者,灵声智库持续深入信创硬件底层适配,为全国党政与央国企客户提供兼具安全与卓越性能的信创环境语音识别解决方案。读者亦可参考涉密机房选型评估清单与离线大模型本地部署选型。