大型制造企业、金融机构及设计研发院所随着多年数字化办公积累,沉淀了数以万计的内部技术培训视频、高管战略闭门会议录音、产线排障研讨及客户访谈音频。这些非结构化音视频资产蕴含着企业最核心的隐性知识与实战经验,但在日常工作中往往沉睡在 NAS 存储阵列中,“看得见、搜不到、用不上”。
近年来,企业纷纷尝试引入检索增强生成(RAG)技术搭建本地知识库。然而,直接将音视频资产喂给 RAG 系统时,工程团队普遍遭遇三大技术断层:口语化转写内容充斥“嗯、啊、那个”等冗余语气助词严重污染向量空间;机械的固定字数分块(Chunking)生硬割裂了上下文论述;大模型生成的回答无法精确定位回原始音视频的具体播放时间戳,导致结论无法溯源查验。
音视频资产转化为 RAG 向量索引的核心痛点
将口语对话数据转化为高召回率的语音识别RAG知识库,与处理常规 Word/PDF 文档存在本质差异:
- 口语非流利性(Speech Disfluency)干扰向量表征:口语表达中存在大量倒装句、重复词及自我修正。若不经过前置语义规范化清洗,嵌入模型(Embedding Model)计算出的语义向量会发生严重偏移。
- 长篇会议多主题交织导致分块割裂:一场两小时的跨部门项目复盘会可能涉及技术选型、预算分配、进度排期等多个议题。传统的按 500 字固定切片会把同一个话题切成两半,极大降低 Dense Retrieval 的命中精度。
- 知识溯源必须精准到秒:企业高管与技术骨干在检索“去年 Q3 架构评审对分布式锁的最终决议”时,不仅需要文本答案,更需要一键跳转到对应会议录像的第 47 分 23 秒直接听取原声。
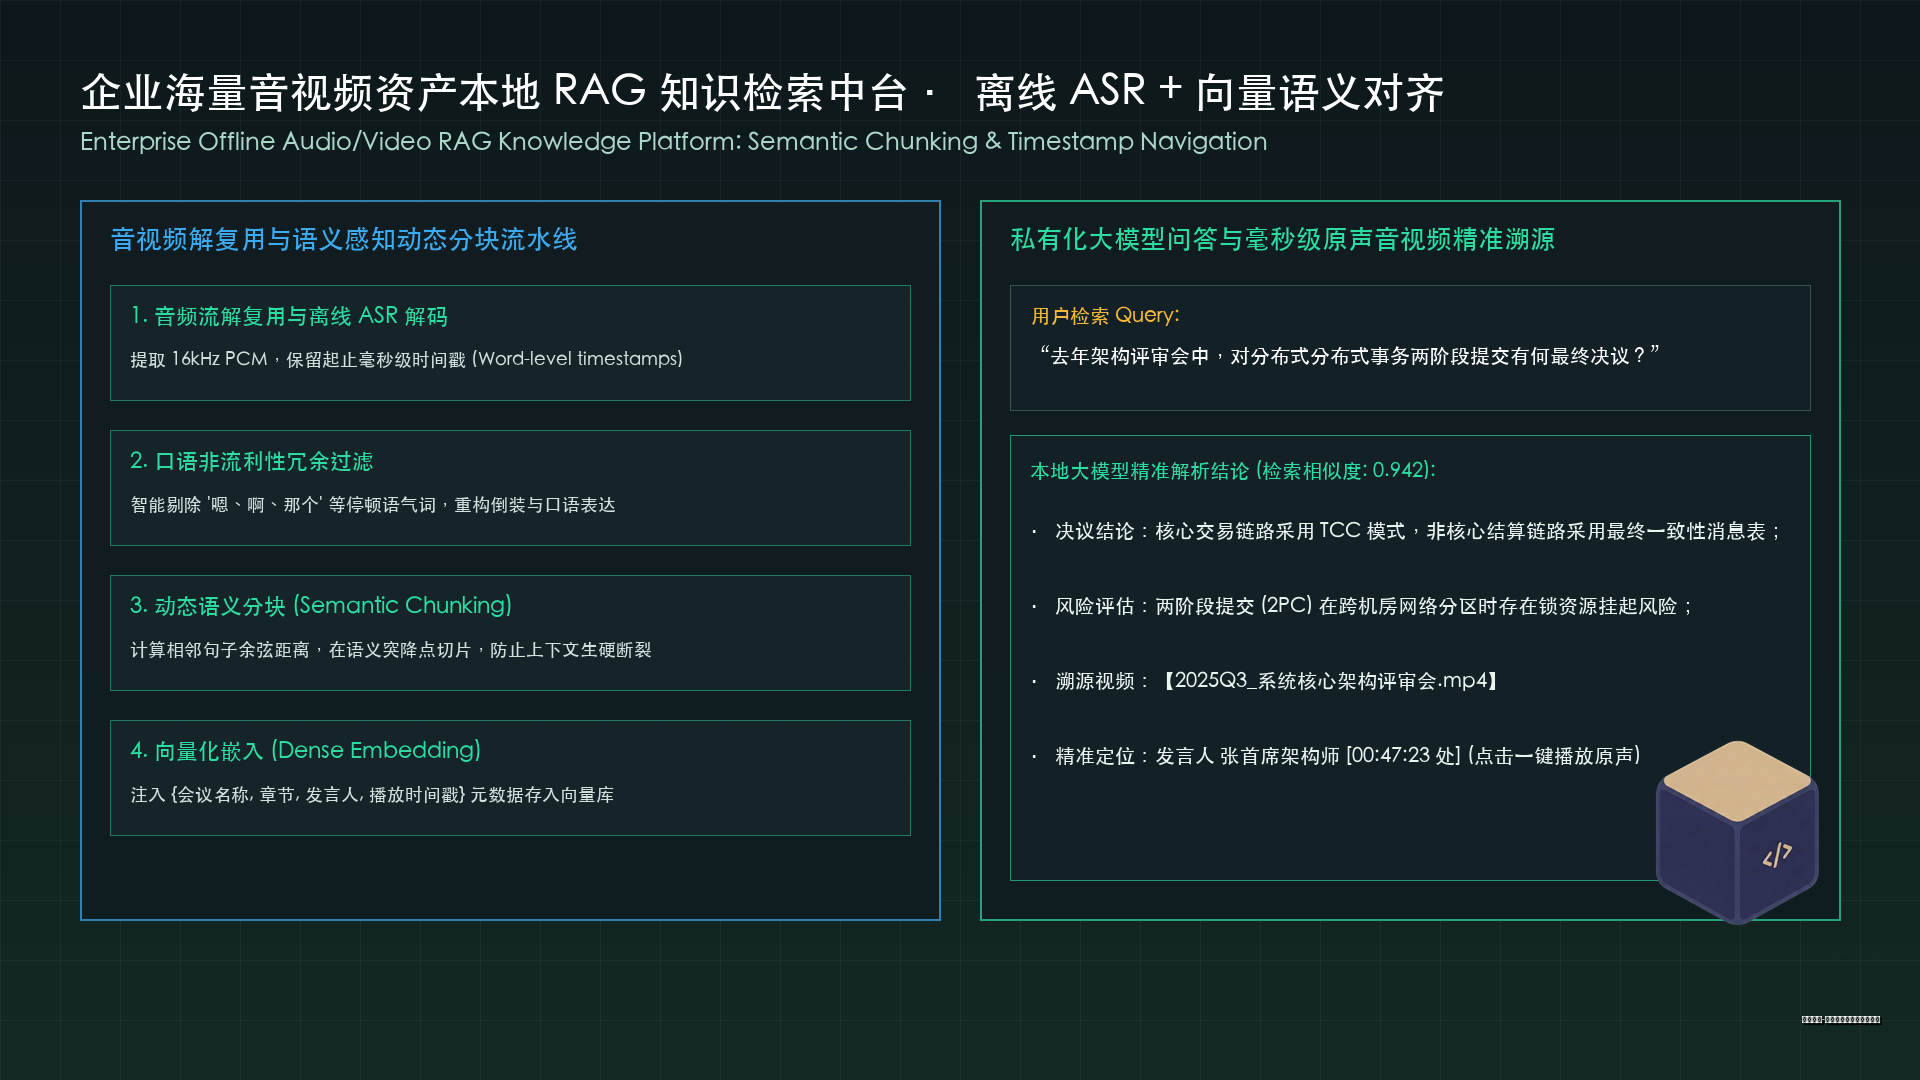
离线 ASR + 动态语义切片的知识入库流水线
为了在企业内网物理隔离环境下构建高精度的离线ASR音视频检索中台,系统设计了端到端的知识提炼流水线:
1. 离线批量高吞吐 ASR 转写与音素级时间戳对齐
音视频文件导入后,离线声学推理集群自动完成音视频流解复用(Demuxing)与声学解码。系统不仅输出字符文本,同时保留每个汉字/词语的起止毫秒时间戳(Word-level Timestamps)及发言人声纹标识。
2. 口语冗余清洗与智能标点/段落恢复
系统接入轻量级本地口语规整模型,自动剔除无意义的填充停顿词,重构倒装句式,并基于声学停顿特征与语义上下文补充标点符号,将口语对话还原为条理清晰的结构化文本。
3. 基于语义连贯性的动态滑动分块(Semantic Chunking)
算法实时计算相邻句子间的向量余弦相似度。当检测到语义相似度突降(Semantic Drop)时自动触发切片断点,确保每个知识 Chunk 聚焦于单一完整主题。每个 Chunk 头部均注入元数据:{会议名称, 发言人, 起始时间戳, 结束时间戳, 章节摘要}。
# 示例:面向音视频转写文本的语义感知切片与时间戳元数据绑定
class SpokenDialogueChunker:
    def __init__(self, similarity_threshold=0.75):
        self.threshold = similarity_threshold

    def create_chunks(self, aligned_transcript_segments):
        chunks = []
        current_chunk_tokens = []
        start_ts = aligned_transcript_segments[0]["start_ms"]

        for seg in aligned_transcript_segments:
            # 过滤口语冗余停顿词 (如 "呃", "然后呢", "那个")
            cleaned_text = self._filter_disfluencies(seg["text"])

            # 判断语义连贯性是否跨越主题断点
            if self._is_topic_boundary(seg, current_chunk_tokens):
                chunks.append({
                    "content": "".join(current_chunk_tokens),
                    "start_time_ms": start_ts,
                    "end_time_ms": seg["start_ms"],
                    "speaker": seg["speaker_id"]
                })
                current_chunk_tokens = [cleaned_text]
                start_ts = seg["start_ms"]
            else:
                current_chunk_tokens.append(cleaned_text)

        return chunks
企业级检索性能与问答召回实测
在某大型装备制造企业内部知识库(收录 3,200 小时研发与售后技术培训录音)上线后的实测数据表明:
- 长音频问答检索准确率(Top-3 Recall):相比传统按固定字符切片的方案,语义动态分块将知识命中准确率从 71.4% 提升至 93.8%。
- 端到端秒级视频精准定位:用户在内网搜索“液压阀偶发性压力不足如何排查”,系统生成排障建议的同时,附带了培训视频 01:14:20 的直达播放链接,定位误差小于 1.5 秒。
- 全链路本地数据安全:从音频解码、文本转写、向量嵌入(Embedding)到大模型生成,全部运行于企业私有算力机房,绝无核心商业技术外泄风险。
适用边界与前置条件
企业在规划音视频 RAG 知识中台时应注意以下适用边界:
- 极端低清或严重破音的早年录音:对于采样率低于 8kHz 且底噪过大的老旧录音带数字化文件,需前置运行声学校准与降噪增强算子,否则 ASR 错字会直接影响后续向量匹配。
- 纯个人轻量级录音备忘录:若仅有零星几段个人随手录音,直接使用本地单机播放器查看文本即可,无需搭建分布式向量数据库与 RAG 链路。
作为企业智能化知识基础设施的赋能者,灵声智库持续深入音视频非结构化数据的深度挖掘与语义连接,为广大政企客户提供安全可信的ASR + RAG 企业知识库解决方案。相关部署架构亦可参考政务语音语义挖掘实录与医疗临床结构化录入实践。