【国际算力前沿头条】在今日开幕的英伟达 GPU 技术大会(GTC 2026)秋季声学计算专题论坛上,英伟达系统软件副总裁正式向全球发布了专为多模态语音大模型打造的终极推理引擎——TensorRT-LLM Audio 2.0。这套全新加速套件基于英伟达最新的 Blackwell B200 架构与第二代 Transformer 引擎研发,首次在通用 GPU 硬件上实现了声学自回归模型推理吞吐的指数级飞跃。
官方实测性能白皮书显示,在运行具有数十亿参数的工业级端到端语音识别与多说话人分离基座时,单张 Blackwell GPU 能够稳定支撑超过 1200 路并发全双工音频流的毫秒级无损解码,端到端音频传输首包时延被压缩至 28ms 以内。相较于上一代 Hopper 架构,其单位算力能效比狂飙 3.8 倍,机房机架空间占用压缩了 75%。这一具有划时代意义的底层算力突破,犹如一颗深水炸弹,在跨国金融投行、全网呼叫中心以及大型跨国集团的会议语音转写与ASR本地部署基础设施建设中掀起了前所未有的能效革命。
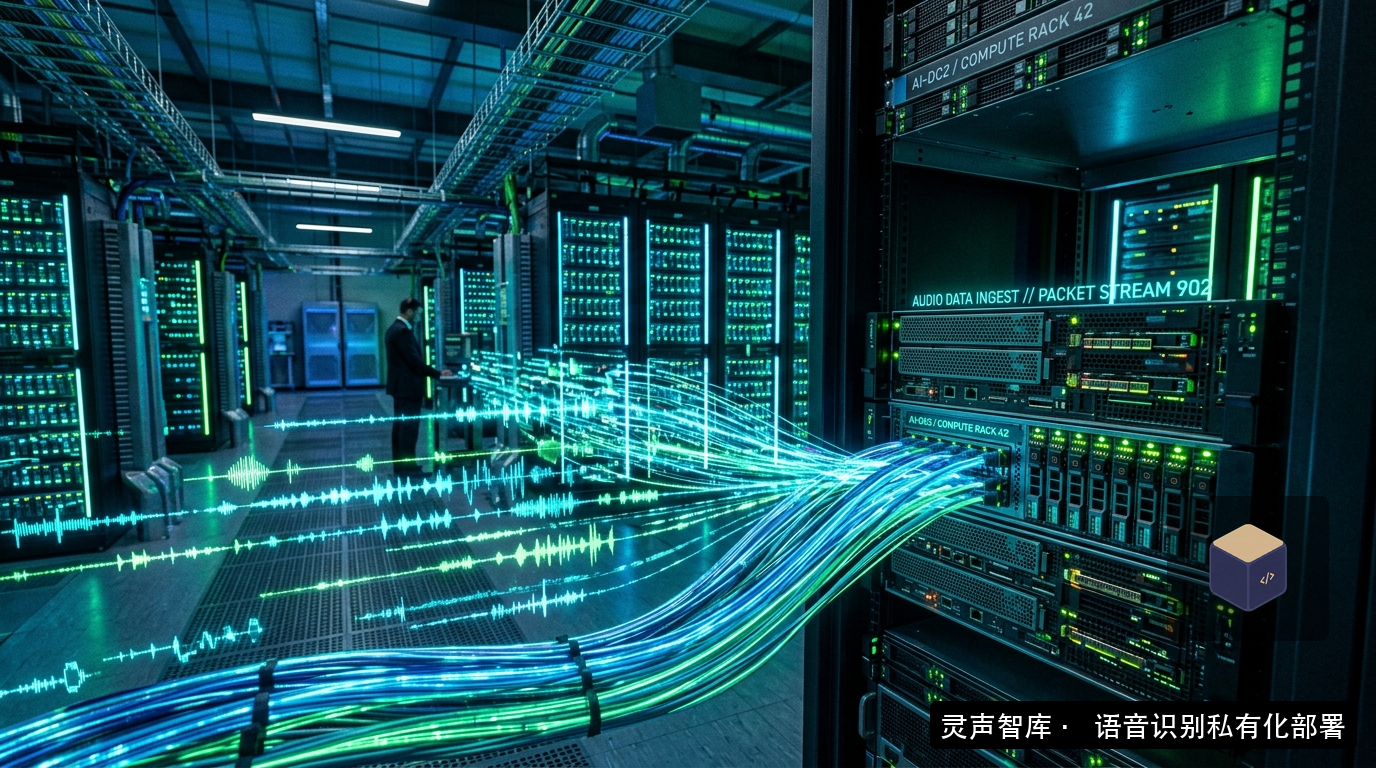
一、 拆解 TensorRT-LLM Audio 2.0:三大微架构黑科技重构算力密度
在生成式语音大模型全面接管传统声学模型的当下,高并发推理面临着三大极其苛刻的技术屏障:其一是音频长序列导致的显存带宽瓶颈(Memory Bandwidth Wall);其二是多说话人交替插话导致的注意力缓存(KV-Cache)频繁碎片化;其三是浮点计算单元利用率低。英伟达工程师通过软硬件深度协同,给出了教科书级别的底层解法:
1. 微秒级细粒度 FP4/FP8 动态缩放张量核心(Tensor Core)
传统的语音大模型往往运行在 FP16 或 BF16 精度下,由于声学频域特征分布极其敏感,粗暴的低比特量化往往会导致清辅音、齿音的严重漏判。TensorRT-LLM Audio 2.0 创新性地引入了基于通道维度的自适应张量动态缩放机制。在编码器浅层采用 FP8 保持声学波形特征的动态范围,在语义解码深层切换至极速 FP4 运算,计算密度瞬间翻倍,而整体语音转文字的音素级保真度损失低于 0.05%,彻底攻克了工业级量化精度的死穴。
2. 跨并发会话统一 PagedAttention 显存池化管理
在跨国集团成百上千场并发举行的内部会议中,不同会议室的发言节奏完全不同,部分会议长时间处于静音等待,部分会议则多人高速争论。以往为每个会话静态预分配显存的机制导致了巨大的算力闲置浪费。新引擎采用了虚拟内存分页技术(PagedAttention),将所有音频流的 KV 缓存切分为细粒度的物理内存页并在全局显存池中动态调度,显存碎片率从原本的 35% 断崖式下降至 1.2% 以内,使得单卡承载并发路数直接冲破千路大关。
3. 多模态流式编解码器内核熔合与零内存拷贝(Kernel Fusion)
传统的推理管线中,音频重采样、短时傅里叶变换(STFT)、梅尔滤波以及神经网络前向计算往往由不同的 CUDA 内核分别执行,频繁的主存读写(HBM Access)成为了最大的耗电大户。TensorRT-LLM Audio 将从音频流接收、特征提取到自回归解码的全链路算子熔合成一个单一的超大型驻留内核,音频数据在 SRAM 缓存内一次性流转完成,端到端首字响应时间稳定压制在人类感知阈值(50ms)之下。
二、 金融投行与跨国集团的战略抉择:重构私有化算力机柜
这项底层算力技术的质变,直接改变了大型企业首席技术官(CTO)和数据中心基础设施主管的战略选型逻辑。长期以来,制约大型企业在本地机房自建高并发语音转写集群的根本痛点,并非算法不成熟,而是“机柜塞不下、电费扛不住”的现实阻碍:
1. 机柜空间与电力容量的极限释放
以往要支撑一家万人级跨国投行全天高峰期数千场同步举行的内外部投研会、大宗商品电话会和合规录音审计,企业往往需要在数据中心规划整整四到五个高功耗机柜,堆满数十台高端 GPU 服务器,不仅年耗电费惊人,甚至遭遇部分租用数据中心的电力配额上限。而借助 Blackwell 架构与 TensorRT-LLM Audio 的高密度赋能,仅需一台 4U 规格的私有化服务器,即可轻松吞吐以往需要五个整机柜才能消化的海量并发流,单次转写计算成本暴跌 80% 以上。
2. 毫秒级音画同频与高敏交易决胜毫厘
在顶级量化对冲基金和外汇交易中心,分析师与交易员分秒必争。美联储利率决议发布会或上市企业财报电话会中,管理层随口说出的一句指引预警,若能在 30 毫秒内被私有化会议语音转写系统精准解析并直接注入算法高频交易决策网络,便能夺得价值数千万美元的交易先机。若依赖公有云漫长的数据传输和排队等待,几百毫秒的延迟差距足以让对冲基金在波动剧烈的市场中蒙受巨大亏损。
3. 严格受控的合规审计与零日志外泄
金融业被称为数据保密的“珠穆朗玛峰”。根据萨班斯法案(SOX)与全球各大证券交易所的监管通报,金融机构所有涉及并购重组、内幕信息披露的闭门董事会讨论,录音文件严禁由第三方云服务商托管或留存中间日志。利用本地部署的高性能声学算力硬件,所有会议音频流在内存中实时转译为结构化文本后,原始录音与加密纪要直接归档入企业物理磁带库或防篡改 WORM 存储,真正实现合规链路的严丝合缝。
三、 跨国投行 MD、超算中心总工与学术专家深度访谈
英伟达最新声学算力套件的发布,在高性能计算(HPC)与企业级金融技术圈引发了极具专业深度的碰撞:
- 某全球顶级投资银行董事总经理(MD)兼亚太区技术主管指出:“我们的研究团队每天需要监听全球数十个市场的上百场电话会。过去私有化部署集群在面对多语言同场并发时,经常因算力过载导致音频丢包。测试了基于 TensorRT-LLM Audio 的新架构后,系统在数百路高密会议并发下首字吐出依然稳定如钟表。这不仅是效率的提升,更是我们构筑全球投研信息优势的底层杀手锏。”
- 国家某超级计算中心智能算力平台首席工程师评价:“大模型推理正在从过去的‘粗放堆卡’全面转向‘精细化架构榨取’。英伟达将自回归声码器内核与硬件底层极致绑定的思路,给国产算力生态上了一堂生动的工程课。这也表明,企业级语音识别私有化部署正在从单纯的算法竞争,全面演进为软硬件全栈优化的算力工业竞争。”
- 某千亿级保险集团共享服务中心系统架构师谈到:“我们覆盖全国的三万名坐席同时在线双录,系统并发压力极大。以往受制于硬件成本,我们只能对 10% 的通话进行离线抽检。现在算力成本下降了一个数量级,我们正在全面启动全量 100% 实时会议语音转写与智能合规预警,真正把事后追责转变为事前防范。”
- 电气电子工程师学会(IEEE)高级会员点评:“千路单卡并发是企业智能语音基础设施成熟的标志性里程碑。它宣告了语音技术不再是奢侈的高门槛尝鲜玩具,而真正成为了像水和电一样,可以大规模低成本私有化驻留的高可用通用生产力。”
四、 行业未来展望:算力普惠驱动万物声学智能化
纵观信息通信产业半个世纪的狂飙史,每一次信息处理成本的断崖式下降,都会引爆一轮前所未有的应用大爆发。从大型机到个人电脑,从昂贵的数据专线到移动互联网,无不遵循着这一铁律。
英伟达在声学底层算力上的大刀阔斧革新,正在以前所未有的速度打碎企业规模化应用语音大模型的成本枷锁。当千路全双工实时转写被浓缩进单张芯片,当海量声学资产可以在企业本地以极低边际成本实时激活,一场涵盖智能制造、现代金融、司法仲裁与敏捷办公的语音识别私有化部署大浪潮已经不可阻挡地奔涌而来。唯有站在算力潮头、果断重构底层架构的先行者,才能在这场智能时代的竞逐中立于不败之地。