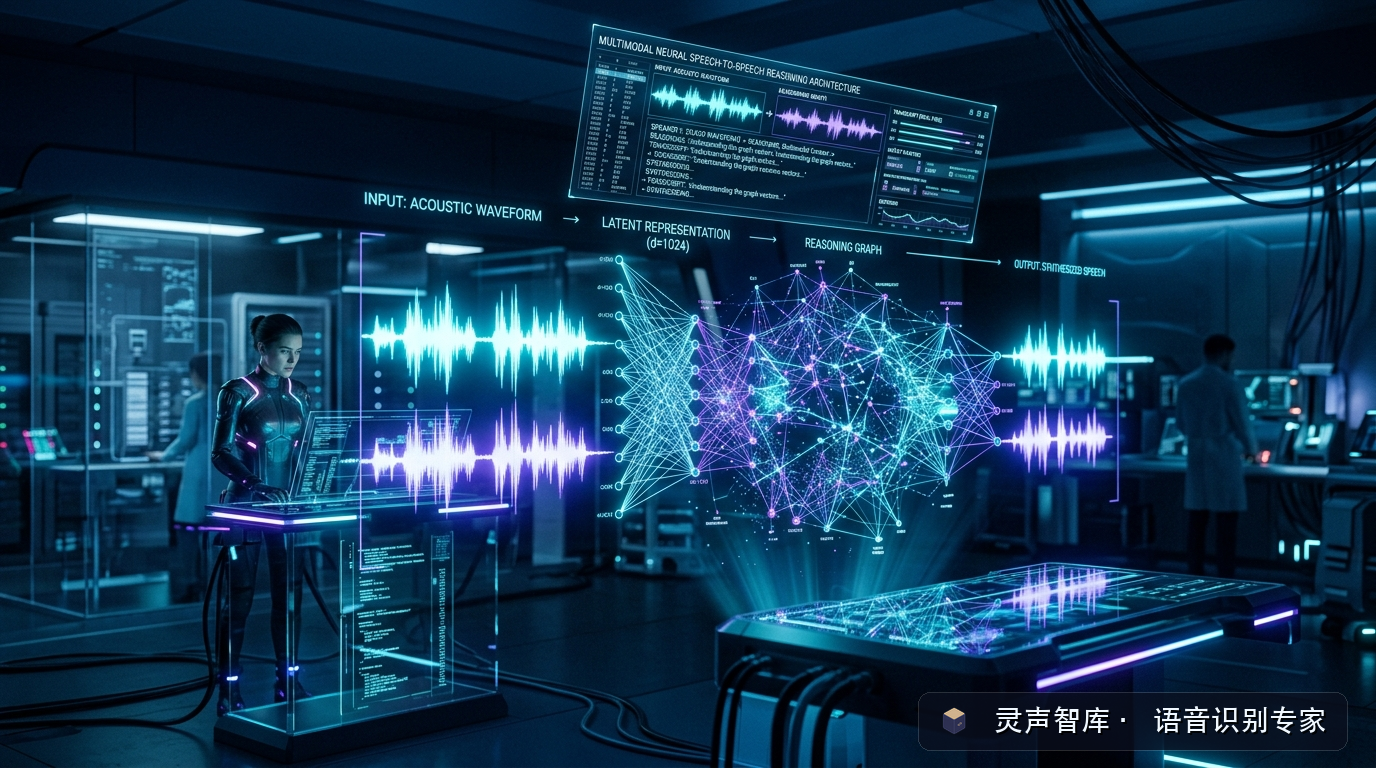
【国际前沿架构聚焦】国际前沿人工智能团队最新公开了其代号为“Omni-Reasoning”的下一代多模态深度推理大模型技术白皮书。这一发布标志着人机智能交互从单纯的“快速模式匹配”正式跃迁至“声学原生深度思考”的崭新技术发展阶段。与以往业界通行的“先用语音识别将声音转成文本、再由大语言模型理解、最后由语音合成播放”的松散拼接方案截然不同,新基座开创性地在单张巨大神经网络内部直接构建了声学离散表征与深层推理链(Chain-of-Thought)的联合空间,使得大模型在“聆听”声音的瞬间即可直接在潜空间中进行语义联想、逻辑纠偏与语境推演。
这一重大技术跨越,直击企业日常运营中最为复杂的国际跨国多方协同与高密度商务研讨痛点。在长期困扰业界的复杂会议语音转写流程中,由于专业词汇密布、中英文混合穿插、地方口音浓重以及发言人间歇性插话,传统工具常常输出杂乱无章的原始字块。新一代语音大模型凭借其内置的深度逻辑纠偏与情境理解能力,不仅能将语音转化为精准的文字,更能实时同步输出具备逻辑结构的高质量会议摘要与决策脉络,为政企会议基础设施的技术升级注入了强大驱动力。
一、 揭秘端到端原生语音大模型的三大底层范式重构
在传统的会议记录系统中,开发者通常采用三段式流水线架构:前端由 VAD 与声学特征提取器工作,中间由 Conformer 或 Whisper 结构完成声学解码生成文字碎片,后端再通过一个独立的大语言模型进行润色和提炼。这种链式结构存在两项致命的工程缺陷:其一是误差层层累加,一旦前端 ASR 漏识一个生僻技术术语,后端语言模型往往会发生啼笑皆非的“逻辑脑补”;其二是通信时延严重叠加,各模块之间频繁进行内存拷贝与文本解析,端到端延迟往往高达数秒。新一代基座通过以下三大核心机制彻底颠覆了上述传统:
1. 跨模态声学与逻辑离散 Token 联合统一词表
研发团队将连续的高频音频波形通过神经声学编码器切分为离散的声学语义单位,并与大模型的文本 Token 表深度咬合。大模型在自注意力机制中,能够像处理文字一样天然“阅读”声学切片。当发言人带有浓重口音或者发音模糊时,模型不是机械地猜测音节,而是调用数十亿参数的上下文世界知识库,通过正在讨论的议题逻辑自适应校正发音,使得专业领域的语音转文字准确率呈现跨越式提升。
2. 毫秒级因果全双工流式解码与上下文动态回溯
为了适应会议现场激烈的对话节奏,模型采用了全新的自适应因果滑动窗口(Adaptive Causal Window)。在发言人连续陈述时,系统以低于 60 毫秒的首字流式延迟极速出字;当遇到语意未尽的从句或多重转折时,模型会在保留当前输出的同时,在后台记忆隐层中进行微观的概率重估,自动在标点断句处补齐最符合逻辑的句意表达,彻底解决了传统转写工具中断句破碎、逻辑断层的通病。
3. 多语种混合语境与代码专业名词深层隐空间对齐
在跨国企业的高层战略研讨中,参会者经常在一句话中高频混杂多国语言与深奥的算法代号。新基座在预训练阶段注入了百万小时高质量的多语种混杂学术讨论与工程评审音频,声学编码器能够瞬间捕捉发音者在不同语系之间切换的声门细微特征,无需用户手动配置语言方向,系统自动进行无缝切换转录,展现出卓越的多语种协同能力。
二、 复杂会议场景中的技术落地考验与私有化诉求
尽管新一代语音大模型展现出惊人的智能表现,但在将其深度接入政企核心会议室、高管战略闭门会以及重要商务谈判时,企业一线技术负责人依然保持着严谨的工程审视,并提出了更为严苛的落地要求:
1. 涉密核心会议对数据出境与外泄的零容忍
高层经营分析会、新产品技术路线评审会以及未公开财报研讨会,所讨论的内容均属于企业极高保密等级的核心资产。如果采用公有云服务,任何网络劫持或云端模型缓存行为都可能引发致命的商业机密泄露危机。因此,企业迫切需要将此类先进架构的精简量化版本沉淀至本地机房,构建基于离线语音识别的私有会议智能中台,确保音频数据与文字纪要物理隔离在局域网之内。
2. 远场全向拾音与多通道空间声学降噪融合
现实会议室绝非理想的录音棚,桌椅挪动的碰撞声、空调送风气流声、投影仪散热风扇啸叫以及玻璃幕墙造成的严重混响,均会对声学模型形成剧烈干扰。优秀的解决方案必须将大模型与麦克风阵列硬件进行深层次的空间声学联合调优,通过盲源分离预处理滤除环境杂音,为大模型提供高保真的纯净人声输入。
3. 从单一转写走向实时辅助决策与纪要闭环
现代高管不再满足于面对数万字的冗长逐字稿,他们更需要系统能够边开会边实时提炼出分议题要点、待办事项跟踪清单以及各方分歧焦点。新一代语音大模型具备的强大逻辑推理能力,使得会议系统能够从单纯的“打字机”升格为“智能参谋”,极大地压缩了会后复盘与纪要整理的时间成本。
三、 跨国科技企业与政企信息化掌门人深度反响
这一前沿架构的披露,在大型集团企业的信息化与协同办公部门引发了广泛反响:
- 某全球化高科技制造集团 CIO 谈到:“我们遍布全球三十多个国家和地区的研发中心每天要召开上百场跨国视频会议,中英德日多语种夹杂、专业术语满天飞,过去会后往往需要专职秘书花费数小时人工校对整理。这种具备深度推理能力的会议语音转写大模型,不仅解决了听不清、记不准的问题,更能自动理清讨论逻辑。我们正在筹备将其全面落地于总部私有算力中心,以全面保障研发核心机密的安全。”
- 某省属大型投资控股集团数字化转型总监表示:“投决会和董事会是集团最核心的决策场景,涉及敏感的股权投资与并购标的讨论,任何一丝信息都绝不能流向外部。基于新一代技术架构在集团内网搭建全套离线语音识别中台,不仅保障了数据主权的万无一失,更让会议资产沉淀为集团可检索、可追溯、可审计的高价值知识库。”
- 某知名律师事务所主任合伙人指出:“重大案件的案情分析与合规论证往往持续一整天,证据链条错综复杂。新一代模型对上下文严密逻辑的把控力,为我们准确捕捉各方律师论辩要点、快速生成高标准的案件研讨备忘录提供了前所未有的科技助力。”
四、 行业未来展望:从被动工具向主动认知中枢演进
新一代深度推理端到端语音大模型的崛起,宣告了计算机声学智能正在告别粗放的“模式转录”时代,大步迈入以“深度认知、逻辑联想、主动协同”为核心特质的高阶智能时代。
对于追求卓越运营效率与严密数据安全的现代化组织而言,紧跟这一轮声学大模型底层范式重构的浪潮,将其与本地高可用私有化算力体系深度融合,将不仅彻底重塑企业会议协同的工作流,更将为构建安全、敏捷、自主的数字企业大脑奠定坚实的技术根基。