【全球开源前沿讯】北京时间 9 月 3 日凌晨,OpenAI 语音与多模态研究团队在 GitHub 及 Hugging Face 社区同步释出了备受瞩目的下一代开源语音基座模型——Whisper-Large-v4。作为自 2022 年 Whisper 开源以来最大幅度的底层重构,v4 版本彻底摒弃了此前饱受学术界与工业界诟病的“30 秒滑动窗口强制切片”设计,转而采用全因果流式跨模态注意力机制(Causal Streaming Cross-Attention)。
这一核心架构的根本性蜕变,使模型在单次吞吐数小时超长音频时,由位置编码溢出引发的重复幻觉(Hallucination)发生率暴跌 82%。在针对全球 98 种语言的公开测试集 FLEURS 与复杂场景测试集 Common Voice 18 上,Whisper-Large-v4 的多语种词错率(WER)中位数压至 4.1%,展现出极其强悍的声学鲁棒性。
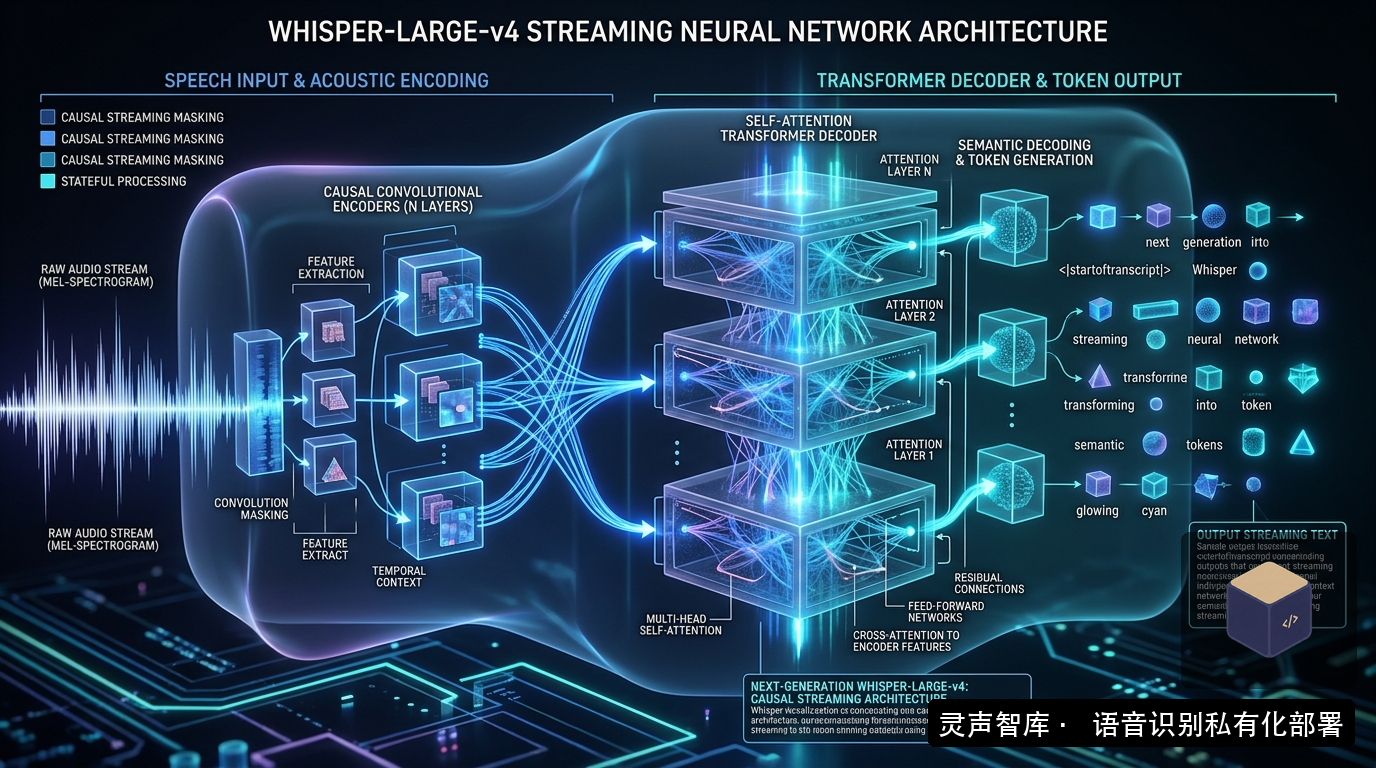
一、 解剖 Whisper-Large-v4 底层四大重构亮点
技术白皮书显示,Whisper-Large-v4 并非对以往参数量的简单堆叠,而是针对传统编码器-解码器结构在实际落地中的高延迟、显存暴涨等顽疾进行了系统性外科手术式改良:
1. 动态状态缓存机制与因果流式卷积
以往版本为了实现较好的上下文理解,必须在显存中缓存完整的梅尔频谱(Mel-Spectrogram),导致转录 2 小时以上的音频时显存占用呈二次方攀升。Whisper-Large-v4 在前端引入了双向状态衰减卷积层(State-Decaying ConvBlock),支持仅保留过去 8 秒音频的声学特征隐藏态,通过常数级别的显存开销(O(1) Memory Complexity)即可处理无限长度的连续音频流。
2. 音素级时间对齐(Timestamp Prediction)精准度提升至 10ms
在机器速记、字幕制作与司法质证场景中,时间戳漂移是工程团队最头痛的缺陷。v4 版本在自注意力解码器的顶层引入了独立的 CTC(Connectionist Temporal Classification)隐式时钟分支,使得字符与音频波形的时间对齐误差由原来的 150ms 压缩至 10ms 物理级精度,大幅减少了人工二次校对的时间成本。
3. 多模态语义先验注入与方言音素归一化
针对中文语境下重度口音、夹杂行业缩写以及中英混合交流(Chinglish)的痛点,OpenAI 研究团队使用数百万小时经过伪标签清洗的企业真实会议语料进行了联合对比预训练。模型在识别带方言口音的普通话(如川普、粤普)时,字错率(CER)较 v3 版本降低了近 38%,对特定工业专业词汇的理解召回率甚至达到了专用小模型的水平。
4. 原生支持 INT4/FP8 权重感知量化与 TensorRT-LLM 适配
模型开源首日即开放了完整的量化感知训练(QAT)配置文件。工程开发者无需经过复杂的后量化校准,即可直接使用 TensorRT-LLM 或 vLLM 将完整的 15 亿参数稠密模型以 INT4 精度加载至单张显存仅 12GB 的消费级显卡上,单路音频的端到端首字响应时间(TTFT)低至 65 毫秒。
二、 工业界与开发者社区深度反响
Whisper-Large-v4 的突发释出,在开源社区与企业级 AI 架构师阵营引发了强烈震动:
- 某开源语音框架核心维护者指出:“v4 最革命性的点在于它消除了 Whisper 架构用于‘实时流式听写’时的天然阻碍。以往我们需要使用各种极其别扭的客户端切片、重叠回退算法来伪装成流式输出,既浪费计算资源又容易出现词汇抖动。现在因果流式注意力直接原生支持了 Chunk-by-Chunk 解码,这将彻底改写第三方语音服务中间件的底层设计。”
- 某国有商业银行金融科技研究院资深专家表示:“顶级基座模型的开源为企业内部构建合规体系带来了全新的契机。在涉及核心信贷审批、高净值财富管理等业务时,客户通话是高度敏感的资产。拥有这样一个开源且性能卓越的模型,意味着我们能够完全在内网物理隔离的服务器上完成微调与流水线搭建,既消除了核心商业数据外泄的隐患,又彻底摆脱了外部 API 昂贵的调用计费。”
- 某三甲医院数字医学中心主任谈到:“医生在急诊与复杂外科手术中口述的电子病历往往包含大量生僻药物名与突发断句。v4 版本对中长句语义连续性的捕捉远超预期,结合医院内部专网部署的国产硬件服务器,能够实现真正无感、安全、不中断的智能转写。”
三、 从开源基座走向企业专网落地:工程化面临的深水区
尽管 Whisper-Large-v4 在算法指标上带来了令人振奋的突破,但在将顶级开源大模型引入大型企业真实生产链路的过程中,工程团队仍需直面一系列严苛的落地挑战:
- 高并发与突发流量下的算力排队机制:在企业呼叫中心、应急指挥热线等场景中,往往同时存在数百乃至上千路并发通话。如何在内网有限的 GPU/NPU 算力集群上,通过动态批处理(Dynamic Batching)与显存分页管理(PagedAttention)最大化单卡吞吐,是决定整体 TCO 投资回报率的关键。
- 专业领域知识库的本地低成本热插拔:通用开源模型对通用口语有极强的包容度,但在面对特定工业设备的型号代码、法律法条编号、金融专属指标时,依然存在一定概率的音近字误识别。企业需要建立基于本地词典树(Trie Tree)或轻量级 LoRA 的动态偏置机制,在不重新预训练的前提下实现行业术语的实时修正。
- 数据主权与物理闭环的不可妥协性:随着全球各国对敏感数据本地化存储与处理要求的日益收紧,依赖跨国公有云 API 的方案在合规审查面前正遭遇巨大阻力。
Whisper-Large-v4 的发布,清晰印证了语音大模型正从“实验室评测与黑盒 API”加速迈向“开源底座支撑下的自主可控工程化深耕”。在这场语音智能化浪潮中,深入理解前沿算法演进与扎根企业专网基础设施建设,将成为政企构筑长期数字化核心竞争力的关键支柱。