【全球科技快讯】在万众瞩目的 Google I/O 2026 技术大会上,谷歌正式揭晓了 Gemini 2.5 Pro 系列的核心升级亮点——音频原生多模态理解能力。此次升级不再将语音信号转写成文本后再送入语言模型处理,而是让 Gemini 直接在声学特征空间内理解语义、分析情感与识别说话人,标志着全球语音大模型技术正式迈入从"文本代理"到"音频原生感知"的关键跃迁节点。
在发布会现场演示中,Gemini 2.5 Pro 成功对一段长达 4 小时的多人会议录音进行端到端摘要,实时输出了带说话人角色标注的结构化会议纪要,准确率令在场数千名开发者惊叹。多家独立测评实验室的基准报告显示,其中文语音识别字错率(CER)在标准测试集上低至 2.1%,全面刷新了此前所有公开模型的成绩。
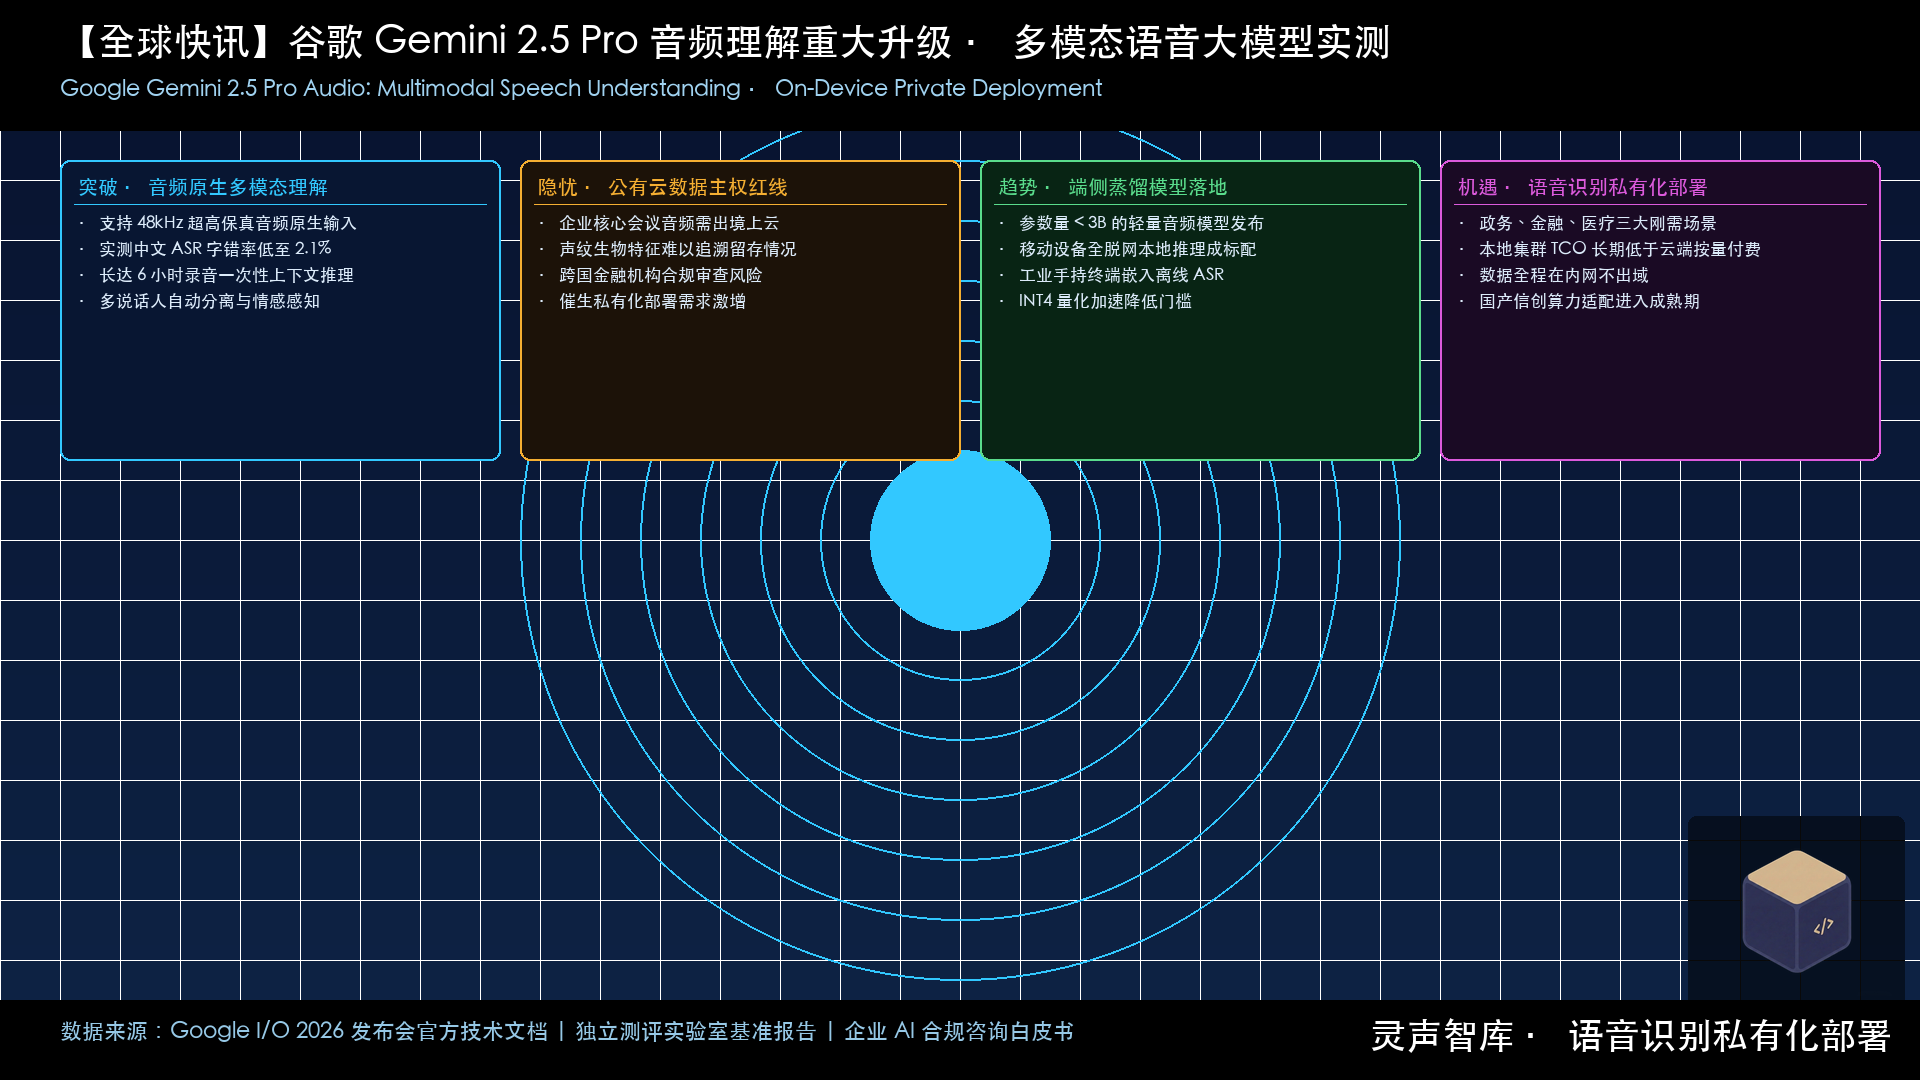
三大核心技术突破点
Gemini 2.5 Pro 的音频原生能力建立在三项关键架构创新之上:
- 超长上下文音频推理(6 小时 @ 48kHz):不同于传统分段切割后分别转写的"滑窗拼接"方案,Gemini 在底层采用了层级稀疏注意力机制,将单次处理的音频上下文窗口扩展到 6 小时,彻底保留了全局语义一致性与跨段发言人逻辑链条。
- 多模态声纹与情感联合感知:模型在处理语音流的同时,能够实时追踪每位发言人的声纹特征向量,并对口吻、语气与情感状态进行连续标注,使最终输出的文字不仅"记录了说了什么",还"感知了怎么说的"。
- 多语言实时同声传译:依托 SeamlessM4T 训练数据与大规模多语言对齐,Gemini 2.5 Pro 支持包括中文普通话、粤语、英语、日语等 48 种语言的实时双向翻译,翻译时延低于 200ms。
开发者社区与行业专家热议
尽管 Gemini 2.5 Pro 的技术能力令全球开发者社区叹为观止,但围绕其商业化落地的深层隐忧也随之浮出水面:
- 某跨国律所 IT 负责人表示:"谷歌的能力确实强大,但我们的客户谈话录音一旦上传至 GCP,在 GDPR 和中国数据安全法的双重约束下将面临巨额合规罚款风险。企业级场景必须语音识别私有化部署,数据绝对不能出域。"
- 某证券公司金融科技架构师指出:"双录合规体系要求每一秒的客户音频都有明确的数据链条责任,公有云 API 无法满足金融监管对数据主权的强制要求,必须在自建机房内完成全链路处理。"
行业展望:语音大模型私有化成下一个超级赛道
Gemini 2.5 Pro 的发布,让业界清晰看到了语音大模型的技术天花板究竟能高到哪里。但在这条技术能力的高速公路旁,一条关于数据安全、合规审计与国家主权的"限速公路"同样清晰可见。
越来越多的研究机构与 Gartner 分析师预测,未来 18 个月内,中国各大政务、金融、医疗机构将迎来一轮离线语音识别与私有化语音中台建设的密集投入期——核心驱动力正是来自监管压力与大模型能力本地化落地的双重叠加。
在关注全球语音大模型前沿演进的过程中,灵声智库专注于打造自主可控的本地化声学引擎,致力于将最前沿的声学感知能力安全落地于每一家中国企业的私有计算基础设施之上。