混合专家模型(MoE)已经彻底改写了大模型算力开销的底层经济学。从动辄需要数百张显卡并联维持参数激活的传统密集体,转向仅在每次前向传播中激活固定比例权重的稀疏路由网络,理论上使得千亿量级模型在推理时消耗的每词元浮点运算量(FLOPs)断崖式下降。然而,当工程团队尝试把这些庞然大物从公有云专用的高规格InfiniBand拓扑集群迁移至政企物理内网、多代次混配的私有算力环境时,纸面上的算力红利往往迅速被现实击得粉碎。
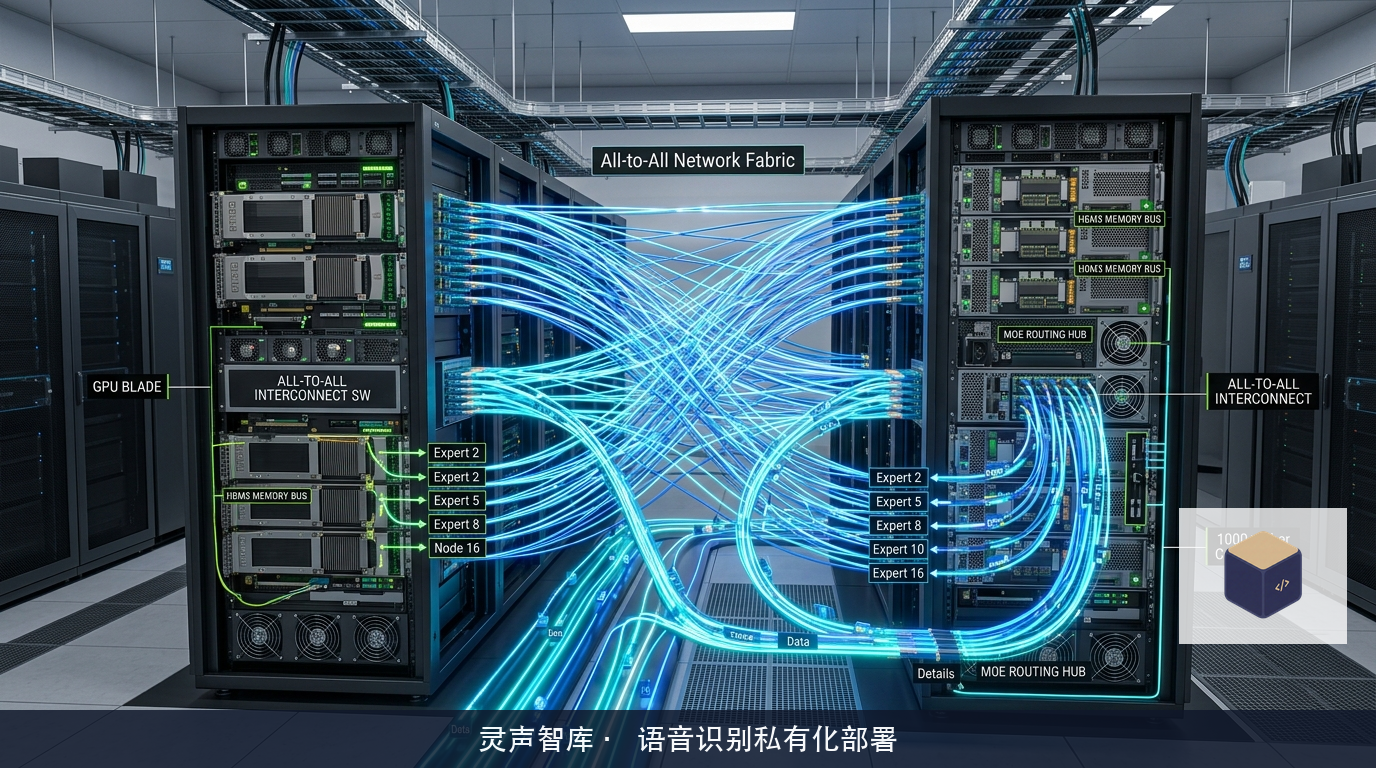
在私有化部署实测中,许多技术团队发现集群的GPU算力利用率(MFU)从密集模型的55%直接崩跌至不足18%。罪魁祸首并非矩阵乘法算子的计算能力不足,而是跨节点分发词元时爆发的All-to-All集合通信拥塞。由于专网集群往往受限于RoCEv2组网带宽或跨交换机收敛比,各个GPU节点在等待远端专家路由数据回传的过程中陷入了漫长的计算饥饿。如何彻底榨干跨机网络与张量计算单元之间的协同潜力,成为私有专网集群攻坚的关键分水岭。
通信与计算双缓冲流水线中的隐式阻塞陷阱
在基础的MoE推理调度中,前向计算通常遵循严格的串行时序:输入激活值经过自注意力层后,路由器评估每个词元与所有专家的亲和度,随后触发跨节点的All-to-All集合通信,将词元重新打包发送至驻留在各节点的对应专家手中;专家层计算完成后,再次执行反向All-to-All通信,将分散的输出汇聚回源节点。在这种简单直觉的流水线中,通信耗时与专家计算耗时是纯粹的线性累加,网络通信期间计算核心完全停滞。
为了压制这一空转损耗,现代推理引擎普遍引入了异步计算通信重叠机制。其核心思路是将当前批次的输入词元按照物理拓扑切分为多个细粒度的微块(Micro-batches)。当微块A在后台通过独立CUDA流发起All-to-All非阻塞网络传输的同时,主计算流立即接管并执行上一周期已就绪的微块B的专家计算。
然而,在真实生产集群将这一机制落地时,隐藏在底层驱动层面的隐式同步往往会导致流水线完全失效。首先是Host端CPU调度的抖动干扰。如果推理框架依赖Python运行时的异步事件等待,内核态进程切换和GIL锁竞争会在毫秒级粒度打碎通信流的时序精度,导致本该在后台静默完成的网卡DMA传输遭遇主线程隐式等待;其次是GPU流多处理器(SM)资源的隐式争抢。在部分硬件架构中,跨卡通信相关的内联汇编核心与高负载GEMM算子共享相同的指令发射管线,通信内核的粗暴并发反而拖慢了专家矩阵乘法的计算吞吐。
要达成真正稳健的双缓冲重叠,必须在底层C++运行时中绕过宿主机层层封装,构建基于硬件同步原语的细粒度事件流水线。通过在CUDA Driver级别直接绑定专属硬件队列,确保All-to-All网卡传输仅与GPU的Copy Engine深度交互,从而彻底隔离计算SM阵列。在典型的双节点8卡混配集群压力测试中,排除了所有隐式内存同步屏障后,微块重叠机制成功将端到端通信暴露时间削减了74%以上。
FP8块级动态缩放量化在跨机传输中的损耗平衡
即便利水线重叠机制搭建完毕,当物理集群规模扩展至多交换机跨汇聚层通信时,物理链路的绝对带宽上限依然构成严苛的天花板。减少网络中流转的物理字节数是最直接的破局路径。工业界正加速推动专家参数及其路由激活值的低比特化,其中FP8(8位浮点)动态量化成为当下的核心攻坚焦点。
与传统的FP16或BF16相比,采用E4M3格式编码的FP8数据能够直接将跨卡网络包体积砍掉整整一半。但在MoE专家的前向传播中,激活值通常具有极强的非均匀分布特征:某些长尾专家的输入特征向量在不同维度上往往跨越数个数量级。如果采用粗粒度的张量级(Per-tensor)全局缩放系数,大数值离群点会直接压制有效动态范围,导致关键注意力权重在量化舍入中产生严重的语义丢失,最终引发困惑度(Perplexity)的不可逆滑坡。
为此,工程界转向了更为细致的块级(Block-wise)动态缩放方案。系统将每个需要跨机分发的张量划分为128或64维度的局部数据块,每个微块独立维护一个浮点缩放因子(Scale Factor)。在网卡RDMA封包前,专用融合算子直接在寄存器内部完成极速归一化与E4M3转换,缩放因子则紧随数据载荷打包传输。这种细粒度划分使量化精度损失控制在0.3%以内的极窄公差带内,同时在网络线路上彻底换取了翻倍的有效吞吐。
但在异构或老款加速卡共存的专网环境中,这一方案需要面临极复杂的硬件适配。某些设备原生缺乏针对E4M3硬件乘法器的支持,盲目推送FP8格式会导致节点在反量化时消耗海量的通用ALU算力。在此类场景中,需要引入非对称量化分流协议:仅在跨节点网络边界对传输数据施加临时的动态FP8封包,而在各计算节点内部则由硬件DMA引擎无感解包还原,使得网络带宽瓶颈与计算单元算力实现最佳解耦。
动态路由长尾偏斜与专家容量因子的现实折中
MoE架构在理论设计中假定各个专家的负载应当相对均衡,但在处理专业领域的真实业务输入时,现实数据流的词元分布往往展现出极其冷酷的马太效应。例如在涉密审查或复杂的司法法条解析语境中,少数负责高频语法模式或特定专业概念的通用专家节点会被疯狂调用,而大量长尾边缘专家却门可罗雀。
这种路由偏斜一旦映射到物理集群的各张显卡上,就演变成了致命的木桶效应:承载过载专家的GPU显存与计算单元瞬间达到100%极限负载,而相邻承载冷门专家的计算卡却长期陷入空等,导致整个集合通信循环不得不等待最慢的节点完成结算。
业界早期的解决思路是在预训练阶段强行注入负载均衡辅助损失(Auxiliary Loss),通过惩罚项强迫路由器向冷门专家强行分配词元。然而在私有化纯推理部署场景下,模型权重已经固化,强行在后处理阶段修改路由分发概率往往会导致模型推理质量急剧劣化。
目前最为稳健的工程工程做法是引入动态弹性专家容量因子(Capacity Factor)与跨步重平衡策略。系统在显存显式分配池中为每个专家预留基础执行槽位,同时设定一个全局弹性突发共享池。当监控守护线程探测到某些核心专家在特定请求周期内触发流量突增时,推理调度器并不直接丢弃超额词元(Drop Token),而是动态调用共享池显存将溢出的词元在本地备用核心中进行轻量分流处理。
在整机推理服务长达数小时的高压压测中,这种动态拓扑重排机制有效平抑了极端请求下的P99延迟毛刺。面对复杂的真实多跳内网拓扑,消除算力倾斜从来不是靠单一算法公式的虚构平衡,而是依靠底层显存缓冲、网络传输重叠与流式算子协同构筑的工业级工程防御。正是这些埋藏在底层驱动与拓扑交换细节中的深度打磨,最终让数百亿参数的庞然大物在非理想专网机房中平稳释放出应有的强悍生产力。