人机声学交互正在经历从单工回合制问答向原生全双工(Native Full-Duplex)连续流式共鸣的历史性跨越。在传统基于级联链路的系统架构中,语音识别(ASR)、文本大模型推理(LLM)与语音合成(TTS)被生硬地拆分为各自独立的串行阶段。即便工程团队通过切片流式传输、首字推流与激进的工程并发优化将端到端时延压缩至数百毫秒,系统在物理机制上依然无法摆脱‘听完才能想、想完才能说’的单向阻塞桎梏。这种阶段式级联不仅累积了数十毫秒乃至数百毫秒的排队延时,更在离散文本转换过程中将说话人微表情、情绪呼吸声与语调重音彻底损耗殆尽。
原生全双工端到端语音大模型彻底颠覆了这种离散流水线。该架构通过统一的连续神经音频编解码器(Neural Audio Codec)与双向流式Transformer骨干网络,将人类发声输入与机器发声输出统一映射至同一高维潜空间流道中。人机之间不再是轮流抛掷句子的机械对答,而是在时间轴上高度重叠、相互影响的连续动态声学波形流。然而,当交互目标被锚定在亚50毫秒(Sub-50ms)的人类听觉生理无感极限时,底层系统必须在网络抖动、因果掩码设计与声学物理回声等多重险境中展开极限时延对抗。
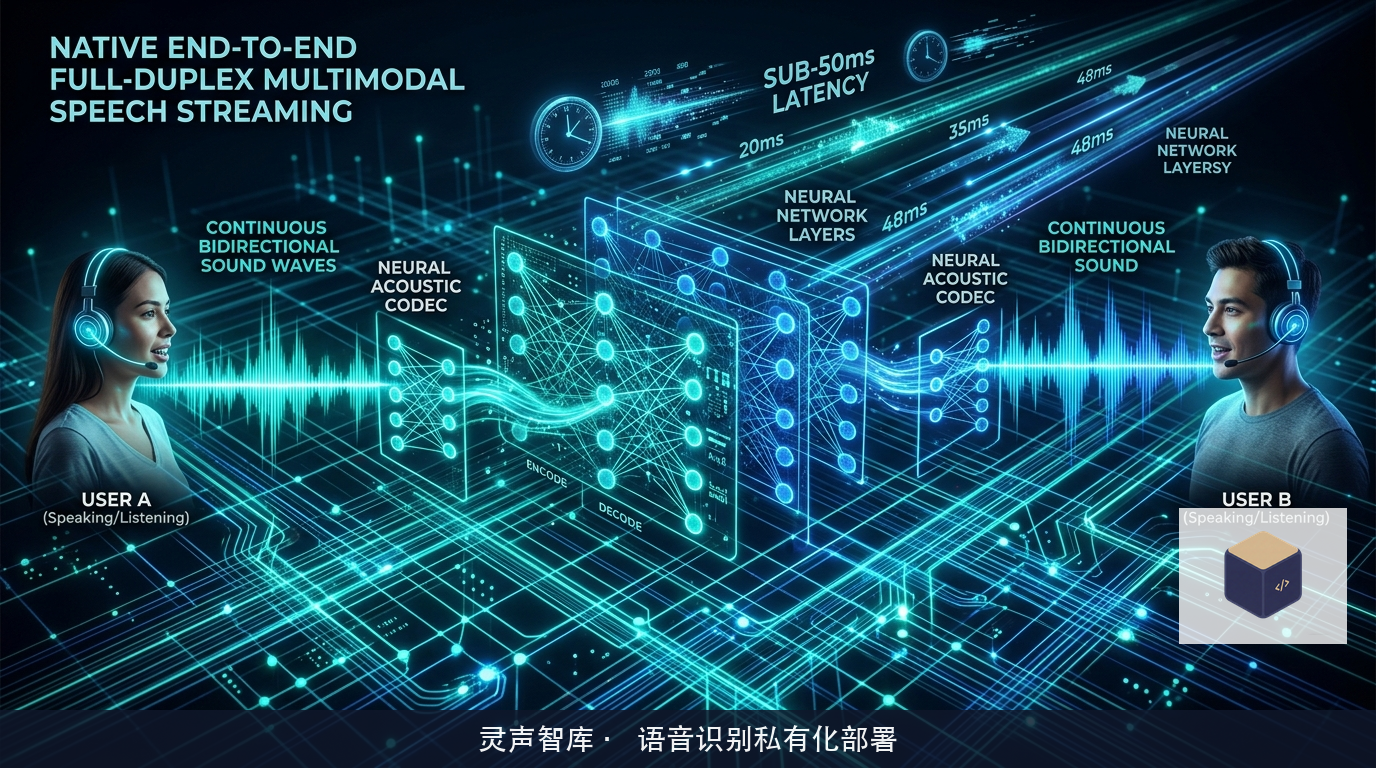
神经编解码连续潜空间与双轨因果掩码设计
在原生全双工架构中,音频信号在进入模型前不再经历离散音素或文本词元的强制转换,而是被深度残差矢量量化(RVQ)网络以40ms为步长连续解构为高维离散潜在特征帧。这些特征帧同时承载着说话人的发音语义、情绪抑扬、呼吸节奏以及背景声场信息:
为了使同一个模型在同一时钟周期内无缝完成‘持续倾听理解’与‘同步自回归发声’,系统设计了非对称双轨因果注意力掩码(Asymmetric Dual-Track Causal Masking);
在掩码矩阵中,输入通道与输出通道被划分为平行的两个潜流。输入通道以滑动时间窗口模式持续摄入外界声学特征,允许其时间步向前窥视局部微小上下文以确保音素特征提取的平滑性;
输出通道在生成机器自身的声学特征帧时,被允许严格因果地关注输入通道当前及所有历史切片的信息,从而以微秒级敏感度捕获用户的语气转折或插话意图;
同时,掩码机制对输出通道施加自注意力正交惩罚,防止模型自身输出的高能量声学标记在注意力矩阵中形成自激放大的伪相关性。此外,为了防止长音频交互过程中因果掩码带来的注意力稀疏漂移,系统在潜空间引入了动态局部感知衰减因子,对远距离历史声学帧实施渐进式软遗忘。这种双轨并行的因果拓扑,使大模型内部形成如同人类大脑听觉皮质与运动性语言中枢协同运作的神经通路,机器在自我表达的同时能够保持全神贯注的实时倾听。
亚50毫秒时钟同步协议与网络抖动因果平滑
在现实物理网络传输中,无论专网光纤还是无线局域网,数据包的到达永远伴随着非确定性的时延抖动(Jitter)与偶发性微丢包。在传统面向块的音频通信协议中,单次丢包通常会导致长达数十毫秒的缓冲区欠载(Buffer Underflow),进而诱发音频播放卡顿与时钟漂移。在全双工亚50毫秒严苛约束下,系统根本没有容纳多次TCP重传或长时间平滑缓冲区的奢侈余量。
现代全双工声学系统构建了基于自适应时间戳预测的超低延迟UDP流式传输协议:
音频传输单元在网络层被解构为带有高精度微秒级物理时钟戳的轻量级无锁数据报文;
接收端部署了前瞻性神经丢包隐蔽网络(Neural Packet Loss Concealment, PLC)。当网络检测到偶发的音频切片丢失时,PLC网络并不等待重传,而是结合大模型潜状态在前序数百毫秒内建立的声学连续动力学流形,在1毫秒内实时自回归预测并补齐缺失帧的声学潜向量;
系统配合自适应时钟漂移补偿算法,根据网络往返时延(RTT)的微观波动,以不可察觉的微秒级步长动态调整本地采样率,彻底消除了声卡缓冲区的时钟累积偏差;
实测表明,在丢包率高达15%的恶劣网络扰动下,该机制依然能够保障音频波形相位谱的严格连续性,使扬声器端重构的语音完全听不出断续杂音,为端到端通信链路在物理网络波动中守住了亚50毫秒极限时延底线。
物理声学回声深度抵消与高动态智能打断判定
全双工系统在真实物理空间部署时所遭遇的最大工程梦魇,是麦克风不可避免采集到的扬声器自放音频——即声学回声(Acoustic Echo)。在亚50毫秒超高灵敏度下,如果设备播放的声音被重新卷入输入通道,模型极易将其误判为用户的打断输入,从而导致系统在瞬间陷入自说自话、莫名闭嘴或疯狂自激的崩溃状态。
针对这一致命缺陷,新一代系统在驱动层与模型层之间构筑了双层防御纵深:
在操作系统底层音频子系统,系统通过硬件环回(Hardware Loopback)通道将扬声器输出的原始数字信号在DAC转换前精确截获,利用复数域自适应有限冲激响应滤波器(FIR)与深度差分网络,在5毫秒内完成高达55dB的线性与弱非线性回声消除;
在模型潜变量层,系统引入了动态能量与语义联合意图分析网络。当麦克风通道检测到输入能量跃升时,网络并不机械地触发音频截断,而是在潜空间内以毫秒级速度判断该声音是否为非语言环境突发杂音(如关门声、咳嗽声)、附和赞同词(如‘嗯、对’)还是真正的实质性反驳打断;
若判定为附和词,系统仅在发音节奏上进行微弱的声调微调以示回应,主输出流道保持平稳推进;若确认属于真实打断,系统在10毫秒内启动声门气流动力学淡出阻尼,使发音以极度自然的短暂停顿收拢,瞬时将注意力重心无缝切换至对用户输入的深度解析。整套时延与声学对抗方案的成熟,让人机声学交互真正迈入了如同面对面交谈般丝滑自然的新天地。