大模型参数规模与计算效率之间的矛盾,正促使混合专家架构(Mixture of Experts, MoE)成为全行业不可逆转的核心技术底座。早期的大型密集模型(Dense Models)在每次前向传播时,必须激活网络中的全部神经元与浮点权重矩阵,导致推理成本随着参数规模的膨胀呈线性飙升。MoE架构通过将原本单一庞大的前馈神经网络(FFN)替换为一组相互独立的稀疏专家网络,并在前端引入门控路由网络,实现了在保持千亿级知识容量的同时,仅激活其中极小比例的参数。
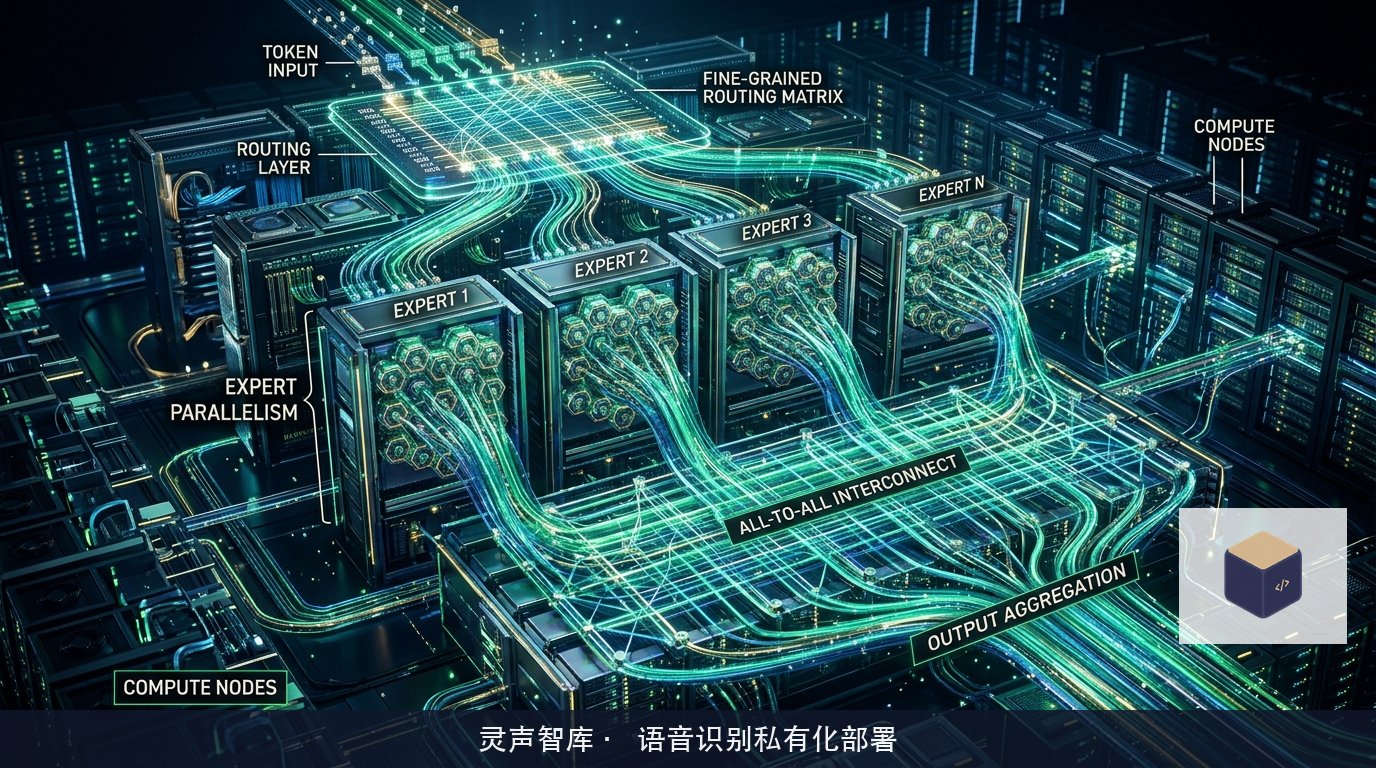
然而,随着开源社区与前沿科技企业对MoE理解的不断深化,架构设计正在经历从早期的粗颗粒度向极细粒度(Fine-Grained MoE)与高稀疏度的剧烈演进。当专家总数从经典的8个或16个急剧扩充至64个、128个甚至256个,且单代币激活的专家数被进一步压缩时,传统分布式训练与推理集群遭遇了极其残酷的通信墙制约。如何通过软硬件深度协同压榨计算拓扑,成为摆在所有智算中心架构师面前的头等大事。
专家粒度切分与知识专精化的数学演进
粗颗粒度MoE在实际业务运行中经常遭遇专家容量失衡与知识表征冗余的双重挑战。在经典架构中,由于每个专家的参数体量依然很大,路由网络往往倾向于将大量看似相关的代币集中派发给少数泛化能力较强的明星专家,导致这些专家迅速过载被动丢弃代币,而其余大部分专家则长期处于休眠欠拟合状态。
细粒度专家重构从根本上改变了特征解耦方式:
首先是专家维度的极细切分。系统将单个原本庞大的FFN中间隐藏层维度按因子N等比例缩小,从而将原来的单个大专家切割为N个具有相同参数总和的微型专家。当面临特定领域语义时,这些微型专家能够以更高的自由度进行组合拼接,形成针对特定子任务的动态临时子网络;
其次是共享专家(Shared Experts)与孤立专家的协同分工。在细粒度架构中,一部分专家被固定为全局共享激活节点,无论输入何种类型的词元,这部分共享专家都无条件参与前向计算,负责承载自然语言的底层通用语法、基本逻辑与常识知识;
而另一部分路由专家则采用Top-K门控机制进行高度动态的按需激活。路由网络计算词元与各个候选专家之间的余弦相似度,并结合带有轻微高斯噪声的Softmax层进行归一化权重分配;
数学统计表明,当专家切分粒度足够细致时,专家之间的权重余弦相似度显著降低,正交性大幅增强。这种设计不仅显著增强了模型参数在长尾专业领域的表达精确度,更使得模型在相同浮点运算量预算下,能够学习并存储数量级更为庞大的细分领域知识图谱。
专家并行(EP)下All-to-All集合通信的物理瓶颈
虽然细粒度切分带来了知识密度的飞跃,但当模型跨越多台服务器进行专家并行(Expert Parallelism, EP)扩展时,网络通信开销迅速成为吞吐量的最大掣肘。
在专家并行模式下,不同的专家被物理分配在不同GPU卡甚至不同物理节点的主板显存中。当一个批次的输入词元完成自注意力计算后,各个词元必须根据门控路由给出的目标专家ID,通过集群互联网络被精确路由发送到持有对应专家的目标计算设备上。在专家计算完成后,计算结果又必须原路传回初始设备以聚合残差:
这一过程在分布式通信拓扑中对应着极其沉重的All-to-All(全交换)集合通信原语;
在单节点内部,由于GPU之间具备高达数百GB/s双向带宽的高速互联通道(如NVLink架构),All-to-All通信的延迟通常处于微秒级,对整体吞吐的影响相对可控;
但在跨服务器的集群通信中,即使部署了昂贵的InfiniBand网络或RoCE v2低延迟以太网,网络交换机之间的物理双向带宽与单卡片上显存带宽相比仍存在一到两个数量级的巨大代差;
随着专家细粒度切分程度的加深,每个词元激活的专家分散在不同节点的概率急剧上升。大量的微小数据包涌入网络交换网络,不仅极易引发突发性的微突发拥塞(Micro-burst Congestion)与链路丢包,更使得GPU计算核心在完成注意力计算后,不得不长时间处于空闲等待状态,导致计算与通信比(Compute-to-Communication Ratio)严重恶化。
在千卡私有智算中心中,若缺乏通信拓扑感知优化,集群超过60%的耗时将被白白浪费在等待跨机通信完成上,算力集群的整体投资回报率被大幅削弱。
算子级重叠掩盖与无辅助损失动态负载均衡
为了冲破通信墙的封锁,系统级优化已经深入到GPU指令发射与底层集合通信算子调度的最深处。
目前主流的工程解法集中在异步通信隐藏与基于通信感知拓扑的路由重构:
研发团队重构了底层CUDA内核,将注意力前向传播、专家路由分配、All-to-All数据交换以及FFN矩阵计算在时间线上进行精细的微流水线(Micro-pipelining)切片。当系统正在为第N个数据分块执行耗时的跨节点网络通信时,计算引擎同时并行调度执行第N-1个分块的局部专家计算,通过算子计算与网络I/O的最大化并发,将绝大部分跨机通信延迟无缝隐藏在计算背景之中;
在算法层面,传统的MoE训练高度依赖人为设计的辅助平衡损失函数(Auxiliary Balance Loss)来强行拉平各个专家的利用率。然而,这种人为强加的惩罚项往往会牺牲模型的整体收敛质量,甚至扭曲专家的专业化分工;
新一代系统引入了无辅助损失的动态路由偏置机制。系统在门控网络的输出端为每个专家维护一个动态的偏差衰减因子。监控探针实时统计物理节点上的网络队列深度与专家计算负载。一旦检测到某个节点的专家即将发生通信拥堵或计算排队,系统便通过微调偏置因子,在几乎不损失语义匹配度的前提下,平滑将处于决策边界上的代币动态导流至负载较低的备选专家所在的节点;
此外,工程团队在网络拓扑层面深度绑定NUMA架构与网卡PCIe亲和性。系统将高频互通的专家组合聚类部署在同一机柜内的同构物理节点上,尽量将跨节点通信限制在局部Leaf交换机内部,彻底避免了跨Spine核心交换机引起的骨干网络拥塞,真正实现了计算吞吐与推理质量的极致平衡。