人机口语交互系统的技术演进,长期受困于机械拼接的级联范式。过去数十年间,无论是智能音箱、电话外呼客服还是车载语音助手,工业界几乎无一例外地采用经典的三段式流水线架构:首先通过自动语音识别(ASR)模块将麦克风采集的声学模拟信号转化为文本,随后将文本交由语言模型(LLM)进行意图理解与回复生成,最后再由语音合成(TTS)引擎将文本重新渲染为机器语音播放给用户。
这种三段式级联方案虽然在工程模块化上界限分明,但在实际的人机交流体验中却暴露出无法逾越的致命缺陷:每一段处理都会累加固有的计算与网络延迟,导致整体交互延迟动辄高达 1.5 秒到 3 秒以上;更严重的是,声学信号中蕴含的说话人情绪、语调起伏、重音犹豫以及环境背景信息,在被粗暴地转换为平面文本时被全量丢失。OpenAI 推出的 Realtime API 原生多模态端到端实时音频架构,正是对这一陈旧技术范式的彻底颠覆。
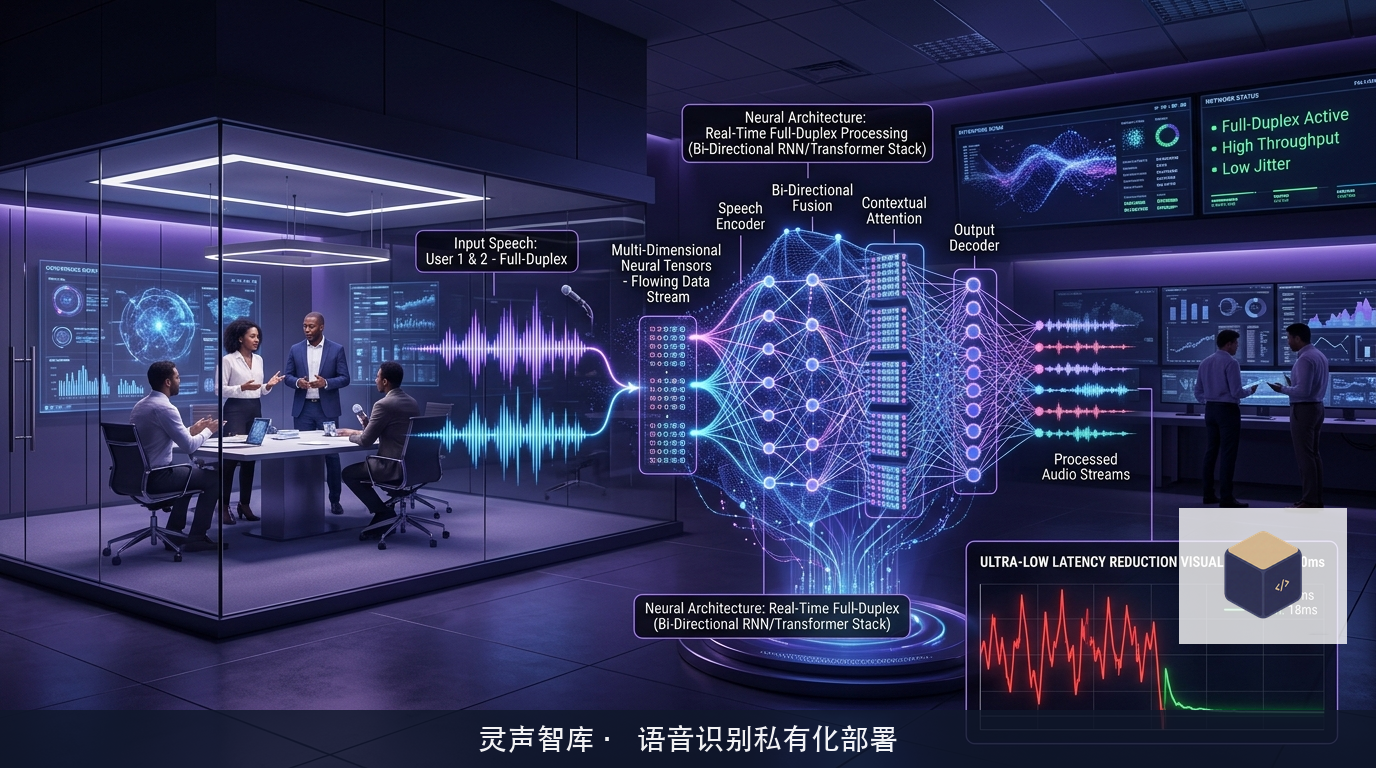
传统三段式级联时延叠加与多模态流式编解码突围
解构原生多模态实时交互的技术优势,首先必须深入量化传统级联流水线中的时延损耗与语义断层;
在传统级联体系中,各模块之间存在着严重的停等阻塞瓶颈:
ASR 模块为了输出确定性的文字,必须等待说话人出现停顿(VAD 判定静音)或者音频切片填满滑动窗口后才开始完整转写,这一过程往往消耗 300 到 500 毫秒;紧接着,语言模型必须等待 ASR 将整句话吐出后才能开始解码,即便采用流式吐字,首包返回依然需要 200 毫秒以上;最后,TTS 引擎为了合成出抑扬顿挫的自然语调,通常需要积攒数个甚至数十个字符的分句标点后才能启动神经声码器渲染,又引入了数百毫秒的缓冲延迟;
叠加各环节之间的数据序列化、反序列化以及进程间通信开销,整个人机对话呈现出极其僵硬的走马灯式顿挫感;
Realtime API 从根本上废弃了中间文本作为核心流转介质的设计:
底层网络直接将原始音频波形通过高速神经声学编解码器离散化为紧凑的音频表征标记流。模型的主干 Transformer 原生支持跨模态因果自注意力建模,在同一个统一隐空间中同时接收输入音频标记并即时生成对应的响应音频标记;
这种端到端架构实现了真正意义上的听即是想、想即是说:当用户的第一个发音单元穿过声学编码器时,主干网络便已经开始在隐状态中前瞻性地拟合语义分布,在用户说话即将结束的刹那,机器的声音已经在声码器中完成了并行合成,将整体端到端感官延迟不可思议地压制在 300 毫秒以内,达到了与真实人类面对面自然交谈完全比肩的流畅水准。
全双工无缝打断与声学空间回声抵消机理
在真实的口语交谈中,人类极少像电台对讲机那样遵循机械的单工轮流发言契约。真实的交谈充满着即兴的插话、表示赞同的语气词反馈、以及随时可能发生的打断重来;
传统级联方案面对打断时表现得极为狼狈。一旦用户在机器播报过程中突然开口发声,麦克风采集的声音极易被扬声器播放的声音严重污染,导致本地 ASR 发生严重的识别错乱;即便通过软件逻辑强行掐断 TTS 播放,系统也需要耗费数秒时间去清空已在队列中的 LLM 上下文与音频缓冲区,交互极度撕裂;
新一代原生实时架构在底层协议与声学前端深度集成了全双工交互机制:
首先是在模型内部构建了高阶因果注意力掩码。主干神经网络在流式输出响应音频的同时,其输入感知端口始终保持全开状态。模型学会了实时分辨当前采集到的输入音频是环境底噪、用户单纯的附和声,还是具有强烈语义对抗性的实质性打断;
其次是结合深度神经网络驱动的自适应回声消除(AEC)算子。在设备端与边缘网关,系统利用参考扬声器信号在时域和频域展开精准的相位对齐与滤波抑制,将设备自身发出的声音从麦克风采集流中彻底消除,即便在极小空间的强声学反射环境下,也能在 20 毫秒内精准捕捉到用户极其微弱的打断音素;
一旦判定用户发起有效打断,模型在自注意力层瞬间截断当前的生成注意力序列,将历史隐状态平滑收敛,并在数十毫秒内自发切换至聆听状态,自然地承接用户打断后的崭新话题,彻底告别了传统系统的迟钝与尴尬。
专网恶劣网络抖动下的前向纠错与丢包补偿策略
当架构师试图将高拟真度的实时音频交互流引入工矿企业、野外作业现场或跨地域广域专网等复杂生产环境时,网络链路的物理不确定性成为了最大的系统威胁;
与普通的文本传输不同,实时全双工音频流对时延抖动与丢包极其敏感。一旦网络发生微小的抖动拥塞,音频数据包就会发生乱序或丢失,直接导致用户听到严重的爆音、机械电音或长段静音,破坏交互沉浸感;
先进的实时音频流式服务在网络传输层与算法层实施了深度协同的鲁棒性保障:
在传输层,彻底告别重传开销沉重的 TCP 协议,全面基于自研优化的 WebRTC 协议栈展开构建。通过引入高频前向纠错(FEC)机制,网关在向客户端发送核心音频包的同时,动态附带轻量级的校验冗余包。当遇到 20% 以内的偶发性随机丢包时,接收端无需发起耗时的重传请求,仅凭本地算力即可在毫秒级时间内完整反解出原始音频帧;
在声学解码层,引入了基于深度生成模型的包丢失隐藏(Packet Loss Concealment, PLC)算法。当网络遭遇瞬间严重拥塞、连续丢失数个关键音频包时,传统的插值算法只会输出生硬的静音或机械蜂鸣;
生成式 PLC 模型能够根据上下文已接收的历史音频音素与语调走势,自发在丢失的时间窗口内生成符合发音人生理声学特性的自然补偿过渡帧。在人类耳膜尚未察觉异常的微小时间尺度内,网络已经平稳跨过了抖动波谷,保障了恶劣弱网工况下业务交流的持续顺畅。
复杂会议重叠说话人场景下的多通道音频工程取舍
在现实企业专网最核心的日常业务场景中,除了单人对单机器的独立客服问答,多名参会人员在大型会议室展开的多方混合研讨,是对声学与语义大模型的终极极限挑战;
在长达数小时的高管决策会议或跨部门研讨中,常常出现两人甚至多人同时发声争辩的重叠会话场景。如果直接采用单通道麦克风采集,不同发音人的声纹特征与声场能量在单条波形中严重纠缠,导致任何端到端大模型都容易陷入严重的语义漂移与幻觉臆造;
工程团队在构建高端专网会议智能化底座时,必须坚持前端多麦克风阵列与后端深度神经网络紧密耦合的系统思维:
硬件层面依赖环形或线性麦克风阵列展开自适应波束成形(Beamforming),在三维物理声场中根据声源到达时间差(TDOA)实时定位不同参会人的空间方位坐标,并在物理角度上对非目标方向的声音实施方向性抑制;
在算法后端引入空间盲源分离与声纹解纠缠网络,将采集到的多通道复杂声场无损解耦为属于不同说话人的独立干净音频流,随后并行灌入大模型的多模态处理分支;
这种软硬件紧密结合的工程架构,不仅完美保留了每位参会人员的原生说话情绪与真实意图,更为后续会议纪要的高保真自动梳理、跨语种实时同传互译提供了坚不可摧的底层声学保障。
从文本拼凑的级联旧时代,大步迈入声音原生端到端交融的新纪元,实时音频交互大模型的突破不仅是算法结构的重塑,更是人机交互自然度的一场深刻跃升。对于企业信息化建设者而言,深刻理解其在声学物理、因果推理与网络工程上的综合博弈,才能在汹涌而来的实时多模态技术浪潮中,为关键业务构筑起最为灵动且坚实的数智桥梁。