在过去两年多的企业级语音工程实践中,OpenAI 开源的 Whisper 系列几乎成为了多语种自动语音识别(ASR)领域的标准基准之一。然而,对于负责在企业内网或边缘设备上搭建离线语音识别流水线的架构师来说,Whisper-Large-v3 始终让人爱恨交织:一方面,其 15.5 亿参数带来的多语种泛化能力与抗噪鲁棒性极其扎实;另一方面,由于其自回归解码器层数高达 32 层,在处理海量长音频批量转录时,GPU 显存带宽消耗巨大,推理延迟始终难以压降至令人满意的交互级水平。
近期,OpenAI 在 GitHub 官方仓库与 Hugging Face 同步全量开源了轻量化版本——Whisper-Large-v3-Turbo。与以往直接按比例缩减隐藏层维度的量化剪枝不同,Turbo 版本采取了一种极为激进且针对性极强的“不对称剪枝”策略:完整保留 32 层的声学编码器,而将自回归解码器一口气从 32 层压缩至 4 层。参数总量由约 15.5 亿骤降至 8.09 亿,推理速度提升近 8 倍。这一更新在开源社区引发了广泛讨论,也为那些正在推进企业语音识别私有化部署的团队提供了一个极具吸引力的新选项。
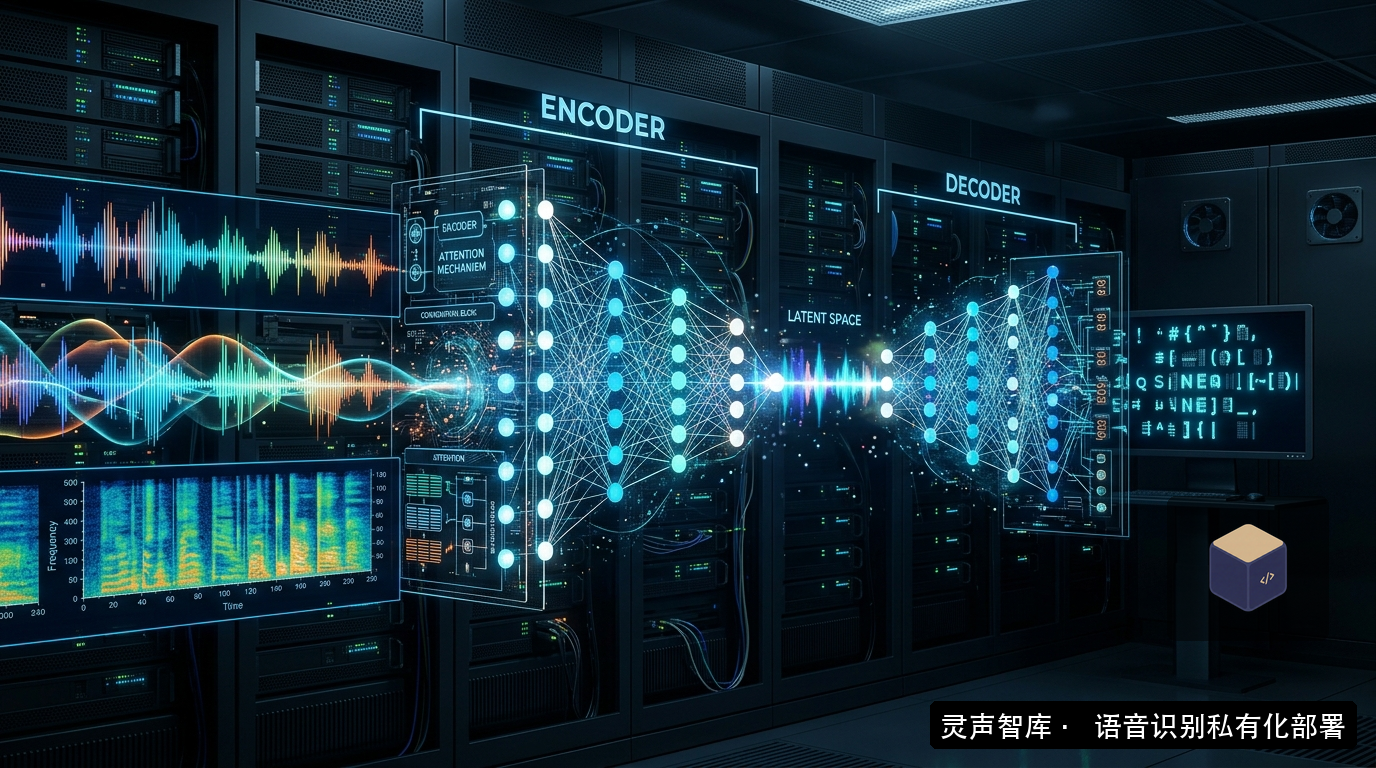
为什么自回归解码器可以被大幅压缩?
理解 Whisper-Turbo 的架构精髓,首先需要厘清自动语音识别任务与通用文本因果语言模型(如 GPT 系列)之间的本质差异。
标准的 Transformer 序列到序列模型由编码器(Encoder)和解码器(Decoder)两部分组成。在自然语言生成任务中,模型必须依赖极深的自注意力网络来理解复杂的逻辑因果和上下文脉络;但在端到端语音转写任务中,音频波形经过 80 维或 128 维梅尔频谱分析后,绝大多数声学特征提取、时域上下文建模、说话人音色对齐以及环境噪声过滤工作,实际上全部由编码器承担。
在原始的 Whisper-Large 架构中,编码器输出的高维声学表征已经包含了极其完备的音素序列信息。随后的 32 层解码器在很大程度上处于“计算力过剩”状态。解码器的核心职能仅是将编码器提供的声学 Token 转化为合法的词表概率分布,并提供一定程度的语言模型平滑修正。过深的解码器不仅引入了沉重的逐 Token 串行计算开销(Autoregressive Bottleneck),在音频出现低音量或长时间停顿空白时,深层解码器甚至更容易出现注意力发散,陷入自发性的文本死循环(Repetition Loops),例如无休止地重复某个标点符号或词组。
通过将解码器深度削减至 4 层,OpenAI 巧妙地打破了这种算力浪费: - 编码器依旧维持 32 层注意力网络,确保对各种语速、混响环境和方言音素的强大特征捕捉能力毫不缩水; - 解码器仅保留 4 层结构,每个自回归时间步的矩阵运算量降低了近 87%,KV Cache(键值缓存)对显存带宽的占用同步断崖式下降; - 在标准公开测试集(如 LibriSpeech test-clean / other 和 Common Voice 多语种测试集)上,字错率(WER)的浮动范围通常被控制在 0.4% 至 1.1% 之内,换取的却是端到端推理时延的大幅下移。
实际环境测试:性能跃升与边界局限
在企业实际的业务场景中,单纯依赖公开学术基准往往无法完全反映系统在复杂物理环境下的真实表现。我们针对 Whisper-Large-v3-Turbo 在内网离线推理服务器上进行了多轮实测,对比对象包括标准版 Whisper-Large-v3 以及轻量级的 Small / Medium 权重。
在硬件测试环境(配置单张 NVIDIA RTX 4090 24GB 显卡、Intel Xeon 8468 处理器、Ubuntu 22.04 LTS)下,采用标准 FP16 精度加载权重: - 实时率(Real-Time Factor, RTF)对比:在处理长达 1 小时的连续中文会议录音时,原始 Large-v3 跑完需约 210 秒(RTF 约为 0.058);而 Large-v3-Turbo 在开启批处理后,仅耗时 32 秒便完成全流程转写,RTF 骤降至 0.0088 左右,吞吐表现极其惊人。 - 并发承载能力:由于解码器层数大幅精简,单路流式会话所需的 KV Cache 显存占用大幅减小,使得单卡在保持低延迟的前提下,能够稳定承载的并行音频通道数由原先的 8 路提升至 36 路以上。
然而,在面对恶劣声学条件时,我们也观察到了浅层解码器不可忽视的工程局限: 1. 极低信噪比环境下的语义补全能力减弱:在背景机械噪音达到 75dB 以上的车间录音中,由于声学波形严重失真,原始 Large-v3 往往能够凭借 32 层深层语言模型“猜”出残缺词汇;而 Turbo 版本的 4 层解码器在面对模糊音频时,纠错容错率相对更低,偶发错字概率有所增加。 2. 专业术语与罕见同音词对齐:在包含密集金融术语或医药化学专有名词的特定对话中,Turbo 模型由于解码器语言模型先验较弱,对同音异义词的选择更倾向于高频通用词汇,必须配合外置的热词增强字典(Hotword Boosting)或外部轻量级语言模型进行二次重打分。 3. 前置语音活动检测(VAD)依赖度提升:实测发现,尽管浅层解码器大幅减少了传统 Whisper 的长段幻觉,但在音频前后端包含较长静音切片时,解码器偶发性跳过静音阶段的能力不如原始版本稳健。在实际工程落地时,前置一个严密的高精度 Silero-VAD 模块进行端点切分,成为了保障 Turbo 稳定输出的必要前置条件。
私有化部署工程链选型与优化实践
对于严禁数据出网、必须在完全断网环境下运行离线语音识别系统的企业而言,直接使用 Python 解释器调用 PyTorch 原生代码往往只能满足实验原型需求,无法支撑起高可用工业流水线。结合当前主流的本地化部署工具链,我们建议根据不同的硬件基础设施采用以下三种工程路径:
基于 whisper.cpp 的 CPU / 边缘设备离线编译
如果部署目标是普通的 x86 工控机、办公级服务器甚至 Apple Silicon 芯片的工作站,whisper.cpp 是兼顾轻量与速度的首选方案。借助其高度手写的 AVX-512 与 ARM Neon 汇编内核,配合 Q5_K 或 Q8_0 级别的 GGUF 整型量化,Whisper-Turbo 可以在不需要独立 GPU 的普通服务器 CPU 上顺畅跑满 4~8 路实时音频流,内存常驻开销控制在 1.5GB 以内,极大地降低了边缘现场的硬件采购门槛。
基于 vLLM 或 TensorRT-LLM 的集中式 GPU 集群流水线
在需要应对成百上千通客服电话录音或海量司法笔录批量质检的中心机房内,应当将 Whisper-Turbo 接入高性能推理服务引擎。例如,利用 TensorRT-LLM 对其 32 层编码器进行算子融合(Operator Fusion),并针对 4 层解码器的 PagedAttention 机制进行显存池化管理。通过动态批处理(Continuous Batching)调度,单台配置 4 卡的 2U 机架服务器即可构建起每日消化数万小时音频文件的企业级语音转文字本地处理中枢。
混合架构取舍:自回归 vs 非自回归模型
在评估是否引入 Whisper-Turbo 时,系统架构师还需要将其与 SenseVoice、Paraformer 等非自回归(Non-Autoregressive)开源模型进行横向对比。非自回归模型在首包延迟(First-Packet Latency)上具备天然优势,非常适合毫秒级实时语音指令交互;而 Whisper-Turbo 作为自回归架构,依然保留了对标点符号自适应断句、长上下文指代消解以及多语种自动识别的强项。对于会议纪要生成、审计录音批量转写、长音频归档等注重整段语义完整性的场景,Whisper-Turbo 的综合表现更为均衡。
从盲目堆大参数到端侧高能效比的务实转向
OpenAI Whisper-Large-v3-Turbo 的开源与走红,清晰地折射出当前人工智能技术落地趋势的一个深刻转向:行业正在从盲目堆叠参数规模、追求在学术榜单上刷新微弱百分点的狂热期,回归到注重推理延迟、硬件能耗比与工程部署成本的务实轨道。
对于正在规划语音系统架构的技术决策者而言,算力成本与数据安全始终是一体两面的核心考量。借助开源社区在轻量化架构上的持续演进,结合企业自身业务在信噪比、并发量与时延要求上的精细化权衡,在企业局域网内部构筑起安全、自主、低成本的离线语音识别与私有化计算基石,已经变得比以往任何时候都更加清晰和可行。