在企业级人工智能基础设施建设的推进过程中,大模型工程落地长期饱受着“部署周期漫长、环境依赖繁复、异构芯片算力利用率低下”等现实痛点的折磨。传统的开源大模型部署往往需要算法工程师手动配置复杂的 CUDA 运行时、编译高度专用的底层张量并行算子、调试显存分页驱动,并针对不同架构的算力芯片逐一排查兼容性故障。这种作坊式的手工部署流程,往往使得一个模型的上线验证周期拖延数周甚至数月之久。
正是在这一行业背景下,英伟达推出了其被视作算力软件商业版图核心支柱的全新交付架构——NVIDIA NIM(NVIDIA Inference Microservices,推理微服务)。NIM 的出现,标志着大模型的交付形态正式告别了繁琐的底层源码编译时代,步入以标准化 OCI 容器为载体、以统一 RESTful/gRPC API 为契约的工业级微服务时代。
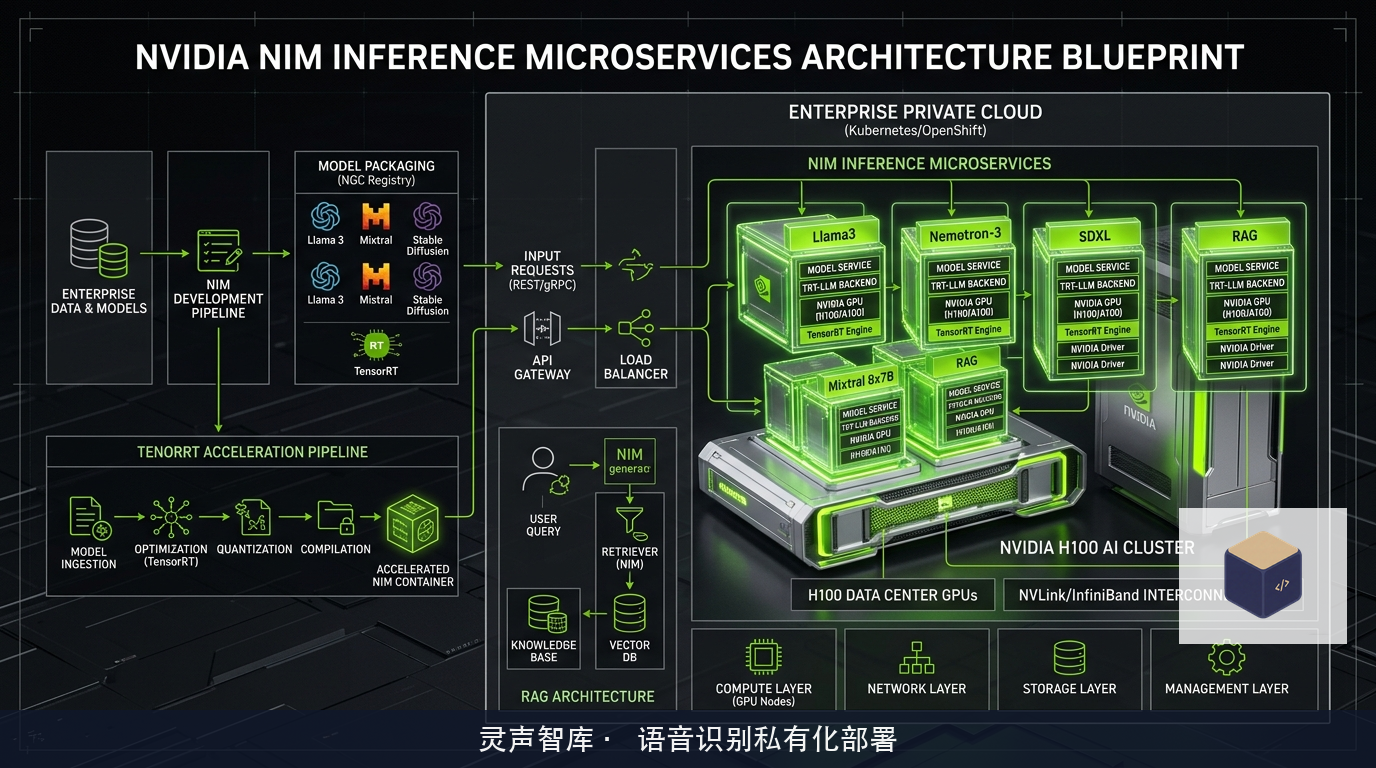
容器化封装背后的技术三剑客:TensorRT-LLM、Triton 与动态算子编译
深入拆解每一个预编译的 NIM 镜像包,其内部绝非简单打包了 Python 脚本与模型权重,而是高度凝练了英伟达数十年来在高性能计算与系统级加速领域的深厚技术积淀:
最底层是深度硬件适配的 TensorRT-LLM 高性能推理引擎。当 NIM 容器在特定的物理机上启动时,系统内置的硬件探测器会自动扫描当前主机的 GPU 微架构(无论是 Hopper、Ada Lovelace 还是最新的 Blackwell),并即时从算子库中挂载最佳优化的 FP8/INT4 GEMM 矩阵乘法内核、FlashAttention-3 注意力算子以及 In-flight Batching 连续动态批处理运行时,确保每一颗物理计算核心的张量单元均能处于满载运转状态;
中间层是工业级多模型推理服务器 Triton Inference Server。它负责提供企业级的并发请求排队、动态负载均衡调度、显存多实例共享(MIG)管理以及全链路 Prometheus 监控指标输出,使得大模型推理在宏观软件架构视角下完全等同于一个标准的云原生微服务单元;
最上层则是完全兼容 OpenAI 业界通用标准的 API 抽象层。这意味着企业内部现有的上层业务系统、前端交互组件或智能体工作流无需更改一行网络请求代码,只需将请求端点指向本地运行的 NIM 容器实例,即可实现底层大模型基座的毫秒级无缝切换与版本回滚;
在内部执行机制上,NIM 还通过深度图优化技术(CUDA Graphs)规避了频繁的 CPU-GPU 启动开销。当批量推理请求进入流水线时,预先捕获的内核执行流在硬件端以极低的上下文切换成本连续流转,使得单请求首字生成延迟(TTFT)与后续流式字间间隔(Inter-Token Latency)均被压制至微秒级极限。
政企物理隔离专网离线部署的真实挑战与应对
尽管 NIM 在连网的公有云或混合云场景中表现出了极佳的敏捷性,但当技术团队将其引入金融交易内网、涉密政务网等完全切断外网连接的严苛物理专网时,立刻会遭遇一系列特殊的系统工程卡点:
首先是海量镜像与数十 GB 权重文件的离线入网与镜像仓库同步。一个标准的 NIM 容器体积往往高达数个甚至数十个 G,企业必须在内网搭建高吞吐的 Harbor 私有镜像仓库,并通过专用的安全离线传输介质完成全量签名校验,建立受控的内部模型制品镜像分发通道;
其次是针对异构算力环境的兼容性兜底。企业机房内往往同时存在着不同年代采购的多种规格算力卡,在跨节点分布式部署时,NIM 的底层驱动与通信库对 NCCL 网络拓扑与 NVLink 带宽状态极其敏感。架构师必须在 Kubernetes 集群调度层精确配置节点亲和性标签与 GPU Operator 资源限制,防止因为混部跨代硬件导致整个集群推理吞吐退化至最低木桶短板;
最后是企业私有化模型权重的热插拔注入机制。企业通常需要运行经过内部行业数据深度对齐的定制微调权重(LoRA 或全量微调)。NIM 提供了外挂挂载卷机制,系统能够在不重新构建数十 G 庞大基础镜像的前提下,动态装配本地挂载的适配器权重,将新模型上线更新周期压缩至仅需几分钟的容器重启时间;
此外,专网集群的高速互联通信调优至关重要。在多机多卡分布式并行部署大参数模型时,若缺乏高速网络支持,跨节点的张量并行(Tensor Parallelism)通信延迟将吞噬大部分算力收益。工程团队在私有云中普遍配置了基于 RoCE v2(RDMA over Converged Ethernet)的高速无损以太网,通过精细调校 PFC(基于优先级的流量控制)与 ECN(显式拥塞通知)拥塞控制算法,确保 NIM 实例间的数据吞吐维持在线速水平,彻底杜绝通信死锁与丢包重传。
企业私有化算力中枢的敏捷编排范式演进
NIM 微服务架构的成熟,正在推动政企专网 IT 架构发生深刻的范式演进。在过去,各业务部门各自为战,财务、研发、风控部门为了各自的业务需求分别采购零散的服务器搭建孤立的大模型小工坊,导致硬件显存长期闲置且维保难度极大。
而在统一的微服务体系下,企业能够将散落在全网的算力服务器整合成一个统一的“企业级私有模型云”:
通过在集群前端挂载统一的 API 网关与路由编排调度器,企业根据实时业务优先级动态调度 NIM 容器实例数量。在白天客服咨询高峰期自动横向扩容轻量对话服务容器,在夜间批处理窗口自动缩容并快速拉起海量长音频离线批量转写与合规穿透审核微服务;
算力资源从“专机专用”的僵化资产转变为“按需动态流转”的高效基础设施服务池,硬件综合投入产出比实现了倍数级的飞跃;
更进一步,NIM 的标准化使全自动化 CI/CD 流水线进入大模型生命周期管理成为可能。模型团队在离线训练平台产出新的对齐权重后,自动化测试管线能够在夜间无人值守状态下启动 NIM 沙箱容器,执行全量自动化基准压测与安全防线扫描,确认性能达标后直接触发金丝雀灰度发布,将生产业务的中断风险降为零。
大模型的竞争已经从纯粹的算法智商比拼,全面延展至底层系统工程与工程交付能力的深度对抗。英伟达 NIM 用微服务的标准化工业语言化解了底层复杂的异构硬件摩擦,而把握这一演进趋势、构建弹性敏捷的本地化微服务算力底座,正是企业在波澜壮阔的智能化变革中保持从容定力的核心工程底气。