在全球大模型技术竞争日益白热化的背景下,算力成本高昂与硬件供应受限长期是困扰大模型产业化推广的核心瓶颈。许多企业在面对动辄需要数千万元初始硬件投入的千亿参数模型时望而却步,开源生态也长期在巨额训练账单与闭源商业壁垒之间艰难探索。然而,国产开源代表力量 DeepSeek 团队推出的 DeepSeek-V3 架构,以令人惊叹的工程创新彻底打破了这一僵局。
DeepSeek-V3 在参数总规模达到 6710 亿的超大体量下,通过开创性的算法重构与极限工程调优,将单次激活参数精准控制在 370 亿左右,并将全量预训练的实际算力成本压降至仅约数百万美元的极低水平。这一里程碑式的突破,不仅重塑了全球学术界对大模型训练能效边界的认知,更为各行各业在受限硬件预算下实现千亿级大模型本地私有化部署铺平了切实可行的道路。
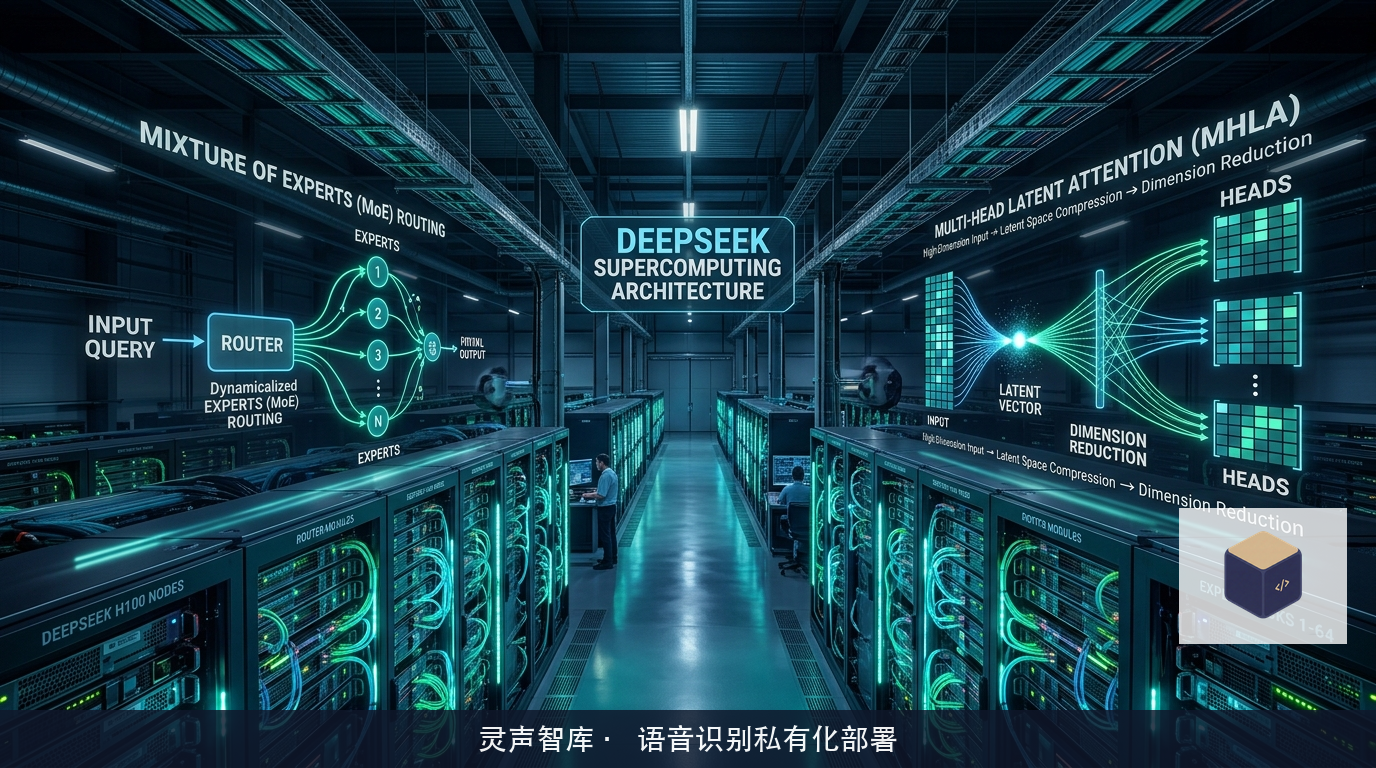
多头潜在注意力对长序列显存带宽的降维打击
深入解构 DeepSeek-V3 的算法精髓,首当其冲的革命性创新便是多头潜在注意力(Multi-Head Latent Attention, MLA)机制。这一机制直击现代大规模 Transformer 推理中最核心的痛点——显存带宽墙;
在传统的多头注意力乃至组查询注意力体系中,自回归解码阶段需要为每一个上下文标记存储独立的键(Key)和值(Value)张量。当面对数万标记的长文本或多轮高并发业务场景时,这部分键值缓存会急剧膨胀,迅速霸占服务器几乎所有的有效显存带宽,导致计算芯片的张量核心在大量等待数据读取的时间里陷入闲置;
MLA 机制从根本上颠覆了传统键值缓存的存储形式:
算法在自注意力计算之前,引入了低秩张量潜在压缩投影。模型不再直接将庞大的 Key 和 Value 矩阵载入显存缓存,而是利用高度紧凑的潜在向量(Latent Vector)对其进行降维表征。在进入注意力核心计算时,系统仅需在芯片高速片上缓存(SRAM)中依据投影矩阵将潜在表征实时动态解压;
实测工程数据显示,MLA 将长序列推理时的键值缓存物理显存占用断崖式削减了 80% 到 90% 以上。这意味着在相同的硬件服务器配置下,系统能够支撑的并发请求数量直接实现了数倍的跃升;
更精妙的设计体现在旋转位置编码(RoPE)与低秩压缩的解耦融合上。传统的张量压缩往往会破坏相对位置编码的时序敏感性,而 MLA 创新性地设计了分离式位置编码分支,使潜在向量在保持极端压缩比的同时,完美继承了模型对长上下文深层时序拓扑与精确细节定位的感知能力。
细粒度专家拓扑与无辅助损失动态路由演进
在混合专家(Mixture of Experts, MoE)架构的探索史上,如何平衡稀疏激活的专家专业度与专家间的负载均衡,一直是困扰学术界的经典难题。如果不同专家之间的任务分配失衡,极易导致部分热门专家过载而冷门专家退化为冗余参数,严重损害模型的整体表达能力;
DeepSeek-V3 对此给出了极具创见性的工程解答:
首先是将专家颗粒度推向极致。与以往粗粒度地采用 8 个或 16 个大型专家的做法不同,DeepSeek-V3 采用了细粒度专家混合(DeepSeekMoE)策略,在深层结构中构建了数百个轻量化的微型专家模块。在每次前向传播时,系统自发激活更多的细粒度专家组合,使神经元在更细密的语义切片维度上自由分工与协同重组,大幅拉升了知识表征的多样性与容量上限;
其次是彻底废弃了传统的辅助损失函数,转向纯自适应无辅助损失负载均衡机制。以往的模型在训练时为了强迫专家均衡,往往在总损失函数中加入生硬的人工惩罚项,这种做法实质上是以牺牲模型最终推理精度为代价来迎合硬件负载;
DeepSeek-V3 在路由门控层引入了动态自适应偏置量。路由器在推理阶段根据各个专家当前的历史排队深度与处理负载,动态微调门控选择倾向。这种纯工程维度的自平衡调度,在完全不污染主干任务损失梯度的前提下,实现了高达 98% 以上的专家计算资源利用均衡度,保障了模型在不同专业领域的知识密度均匀输出。
混合精度工程化与跨节点通信瓶颈突破
将一个高达 6710 亿参数的超巨型模型推向工业化生产,单靠算法层面的公式推导远远不够,底层软硬件底层的极致工程协同才是决胜的关键;
DeepSeek-V3 在大规模训练与推理部署中全面推行了原生 FP8 混合精度计算范式:
传统的量化往往停留在模型微调或离线推理阶段,而在千亿模型的全量预训练中采用 8 位浮点数极易遭遇梯度溢出与训练崩溃。研发团队重构了底层张量张缩机制,推行了基于微小张量块的细粒度量化缩放策略。通过在计算核心内部实时监控特征分布并动态调整缩放因子,FP8 成功覆盖了前向传播与反向传播的绝大部分密集算子,使计算芯片的理论算力吞吐直接翻倍,同时显存带宽消耗锐减一半;
更值得关注的是其在分布式通信拓扑上的极限压榨。在跨服务器的多专家并行计算中,跨节点全交换(All-to-All)通信往往是吞噬整体性能的吞吐黑洞;
系统设计了通信与计算的深度重叠流水线。当计算核心正在处理当前层的局部专家前向传播时,后向专家所需的跨节点数据包已经在底层网络驱动的协同下于后台异步高速传输。配合轻量化的点对点直连协议,系统将原本高昂的跨机通信延迟几乎完全掩盖在密集计算的耗时阴影之下,展现出了极高的分布式扩展效率。
企业私有云算力异构适配与本地部署收益评估
对于立足于数据安全合规与自主可控的企业决策层而言,DeepSeek-V3 的开源发布为企业级私有算力中枢的建设注入了极具想象力的可能性:
在过去,要在企业本地完全物理隔离的机房中部署一个具备卓越通识能力的大模型,往往意味着必须采购价格极其昂贵、供货周期漫长的国外顶级超算整机柜。而 DeepSeek-V3 凭借其卓越的稀疏激活与显存压缩特性,使得中等规模的企业级异构算力集群便足以承载千亿级全能力模型的平稳运行;
在实际的专网部署落地中,技术团队可以根据企业内部的具体业务负载,对细粒度专家实施差异化的量化与分流部署:核心通识门控保持高精度运行,而针对特定低频垂直领域的专家则可以采用更激进的权重量化甚至动态换页策略,在极低硬件资源消耗下维持全功能矩阵的待命;
此外,完全开源的权重与透明的技术实现,赋予了企业对模型底层算子和安全逻辑的绝对主导权。技术团队无需再担心云端商业 API 的突然断供、接口变更或暗中扣费风险,能够放心地将核心客户交易数据、生产制造工艺配方与战略分析工作流深植于本地闭环的大模型底座之上。
开源技术的伟力,在于它以开放共享的协作精神不断撞击技术垄断的高墙。DeepSeek-V3 用扎实的技术创新证明了算法架构优化的深邃潜力。对于广大致力于在本土土壤上推进产业数字化转型的工程师而言,这不仅是一次算力性价比的胜利,更为千行百业在安全、可控、高效的轨道上迈向通用人工智能时代筑牢了最坚实的技术基石。