人工智能计算芯片的性能狂飙,正在将底层物理基础设施的承载极限推向临界边缘。过去数年间,伴随着 Transformer 大模型对密集浮点算力的无止境渴望,主流算力芯片的设计哲学从早期的单芯片能耗优化,迅速演变为依靠先进半导体封装技术拼接双芯甚至多芯的庞然大物。当英伟达正式推出基于 Blackwell 架构打造的旗舰级 GB200 NVL72 整机柜系统时,全行业在为其惊人的算力吞吐发出赞叹的同时,也深刻感受到了来自物理学热力学与电力工程的沉重压迫。
GB200 NVL72 将 72 颗高性能 GPU 与 36 颗 Grace CPU 高度密集地整合进单一机架之内,在 FP4 精度下爆发出超过 1.4 Exaflops 的天文级推理算力。然而,将如此巨大的算力硬塞进一个占地面积不足两平方米的标准化机柜空间内,直接催生了高达 120 千瓦(kW)的峰值电力消耗与近乎等量的瞬态极热发热量。这一热密度直接宣告了传统风冷数据中心的彻底死亡,也对致力于筹建私有化智算中心的企业基础设施工程提出了颠覆性的重构要求。
芯片间极速直连与 NVLink 5 全互联无阻塞网络拓扑
深入剖析 GB200 NVL72 的性能核心,首先要理解英伟达为何不惜冒着巨大的热设计风险,执意将多达 72 颗计算芯片集中于同一套物理机架之中;
在大模型从单体走向数百亿乃至数千亿 MoE 稀疏专家的时代,跨计算芯片之间的通信带宽早已成为决定系统吞吐的终极瓶颈。如果采用传统的 PCIe 总线或跨服务器的外部网卡(NIC)连接,芯片间的数据搬运延迟将高达微秒级,使得大量算力白白浪费在通信等待之中;
GB200 NVL72 通过引入第五代 NVLink 全互联技术,构建了一个令人惊叹的机架级统一内存计算池:
机架内部配置了 9 个专用的 NVLink 交换机托盘,利用多达 5000 条高速双轴铜缆(Direct Attach Copper, DAC),在 72 颗 GPU 之间构筑起了全互联的无阻塞网络拓扑。整机柜双向通信总带宽飙升至惊人的每秒 130 太字节(TB/s);
这意味着对于运行在其上的千亿参数大模型而言,整个机架不再被视作由数十台独立服务器拼接成的松散集群,而是被底层微码统一调度为一个拥有多达 30TB 共享超高速内存(HBM3e)与每秒近百太字节内存带宽的超级单体计算机;
在处理超长上下文推理与细粒度专家路由时,数据在任意两颗计算芯片之间的穿梭延迟被压制在数十纳秒之内,实现了比传统多机 InfiniBand 网络高出一个数量级的跨卡调度效率。
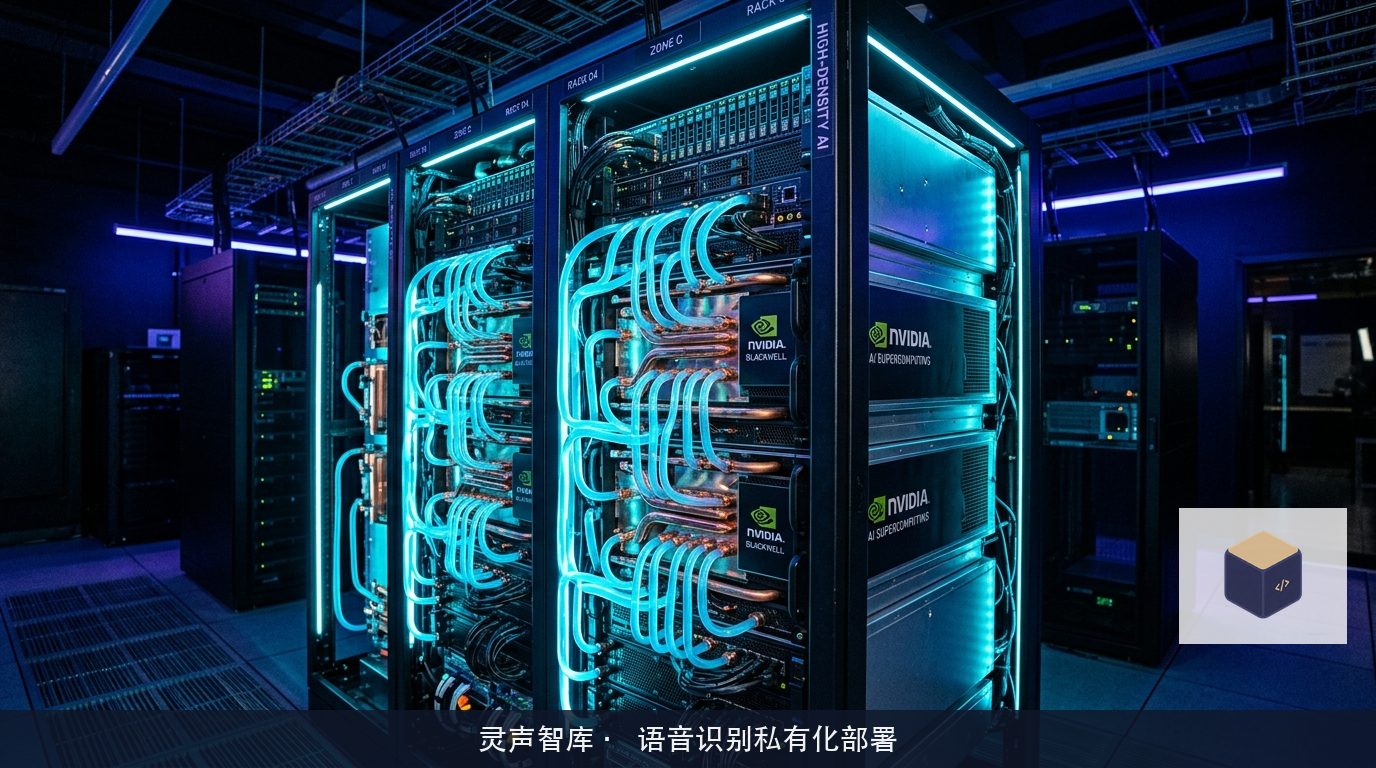
120kW 热密度下的直接接触冷板式液冷系统设计
面对单机架高达 120kW 的恐怖发热量,传统的冷热通道风道隔离与大功率机房精密空调已经彻底束手无策。空气的比热容极其微弱,在如此狭小的物理截面内,即便将风扇转速拉升至震耳欲聋的极限,流经机柜的风量也完全无法及时带走芯片表面单位面积高达数百瓦的极限热流密度;
GB200 NVL72 坚定采用了直接接触冷板式液冷(Direct-to-Chip Liquid Cooling, DLC)全覆盖方案:
冷却回路通过高度定制的无氧铜微通道冷板,直接紧密贴合在 GPU 计算核心、CPU 以及 NVLink 交换机芯片的封装顶盖之上。冷却介质(通常为去离子水与防冻防腐添加剂的混合流体)在加压水泵的驱动下,以高速紊流状态流经厚度仅有微米级的微通道翅片,利用水极其优越的高比热容特性,在热源产生的微秒级时间内将热量强行带离硅片表面;
整个机柜内部布满了极其精密复杂的冷却液分配管道(Manifold)与防泄漏盲插快速断开接头。系统不仅要承受数十升每分钟的高速液体循环冲刷,还必须确保在高压运行状态下维持十万分之一级别的绝对零渗漏可靠性;
机柜底座集成有高灵敏度的光学与电导率漏液检测绳,一旦发生极微小的滴漏,监控系统会在 50 毫秒内瞬间切断冷却液主阀门并卸载算力负载,将硬件损毁风险降至最低。而在机柜外部,温水冷却技术使得数据中心无需配置耗电巨大的机械冷水压缩机组,仅靠室外干冷器即可在全年绝大部分时间内实现高效自然冷却,将整栋智算机房的综合电能利用效率(PUE)硬生生拉低至 1.15 以下的卓越水平。
供电母排瞬态电流冲击与私有智算机房抗突波改造
将这样一台用电巨兽引入企业内部机房,对企业的电力变压中枢与末端供配电网络无异于一场严酷的高压大考;
传统的企业级机房通常是按照每个机柜 5kW 至 8kW 的标准电力负荷进行设计的。120kW 的单机柜功率意味着一台机柜消耗的电量就相当于以往整整一个服务器排列的全部负荷;
电力工程团队在引入 Blackwell 算力机架时,必须对末端供电进行彻底的重构:
彻底抛弃了传统的柔性动力电缆与普通插座,全面转向机架后方集成的实心铜质母排电力系统(Busway)。母排系统利用高达数百安培的大电流承载能力,以极低的线路阻抗向各个计算托盘直接输送直流母线电压,大幅削减了交直流多次转换带来的无效热损耗;
更为棘手的是大模型计算特征引发的极高瞬态电流突波(di/dt)。大语言模型在进行批量推理时,计算芯片的负荷会在数十毫秒内由低功耗待机状态瞬间拉升至满负荷极限运行;
这种剧烈的负载跳变会在供电母线上引发严重的电压骤降与反向尖峰电涌。如果企业机房的 UPS 不间断电源与变压设备缺乏足够的动态响应带宽,轻则导致服务器电源保护锁死跳闸,重则直接击穿昂贵算力芯片的内部供电模组。工程团队必须在机架供电前端增设大容量超级电容模组或超高速储能飞轮,以缓冲突发性算力洪峰带来的电网冲击。
企业自主算力底座的异构冗余与长稳运行调度
在见证了 Blackwell 架构展现出的强悍算力的同时,企业技术决策层在规划私有算力中枢时必须保持冷静清醒的战略定力:
首先是要清醒认识到供应链集中度与单点故障风险。GB200 NVL72 这类高度集成的整机柜系统具有极强的工程专有性,其从液冷接头标准、总线协议到调度软件均深度绑定于特定生态。一旦核心冷却泵组出现机械故障或机架内某处发生通信断联,往往需要整柜停机维护,对企业关键业务的连续性构成挑战;
合理的智算中心架构应当坚持异构多元、分层解耦的稳健路径。将整机柜超算作为攻克千亿模型核心训练与深度推理的先锋突破部队,而在海量的常规业务推理、离线语音质检、标准文档分析等日常任务中,广泛搭配能耗比更高、对机房风冷环境适应性更强的中小参数算力节点与国产化算力卡;
通过在软件层构建统一的异构算力抽象调度引擎,实现任务负载在不同硬件体系之间的无缝动态迁移,确保即便遭遇局部硬件维护,整体业务流水线依然能够坚如磐石、永不中断。
算力的爆发正在深刻重塑物理世界的物质基础。从微小的晶体管栅极到庞大的液冷冷却塔与高压输电走廊,人工智能的发展史同时也是一部跨越半导体、热力学与电力工程的宏大系统交响曲。对于立志构筑企业核心数智壁垒的工程师而言,唯有扎根物理现实,将前沿的算力梦想建立在安全、高韧、可持续的坚实工程地基之上,才能在激烈的智能变革大潮中立于不败之地。