人机口语交互系统正在经历一场彻底颠覆传统工程链路的技术范式革命。在长达数十年的时间里,工业界构建智能语音助手或自动化质检座席时,始终沿用经典的级联流水线方案:声学信号首先通过自动语音识别(ASR)引擎转写为纯文本,文本输入大语言模型(LLM)进行上下文理解与语义决策,大模型生成的回复文本再输入语音合成(TTS)引擎转化为合成波形推流返回。
这种三段式级联架构在工程实践中暴露出两大致命缺陷:其一是时延层层累加,ASR的断句等待、LLM的首字延迟以及TTS的文本归一化和音素生成使得端到端交互延迟通常处于1.2秒至2.5秒之间,完全无法实现真实人类对话中的自然插话、重叠发言与快速反馈;其二是语义与副语言信息的严重丢失,说话人的语调起伏、犹豫停顿、情绪震颤以及环境背景噪声在转换为纯文本的过程中被全量清洗,导致模型无法准确感知用户的潜在情绪意图。
随着原生端到端流式多模态大模型的研发落地,声音信号不再被粗暴降维为静态文字,而是作为连续的神经声学特征直接参与跨模态注意力计算。这种全双工流式架构将端到端延迟压缩至300毫秒以内,但在通信协议栈、跨模态时钟同步以及弱网抖动抵抗方面,对专网工程系统提出了前所未有的极限挑战。
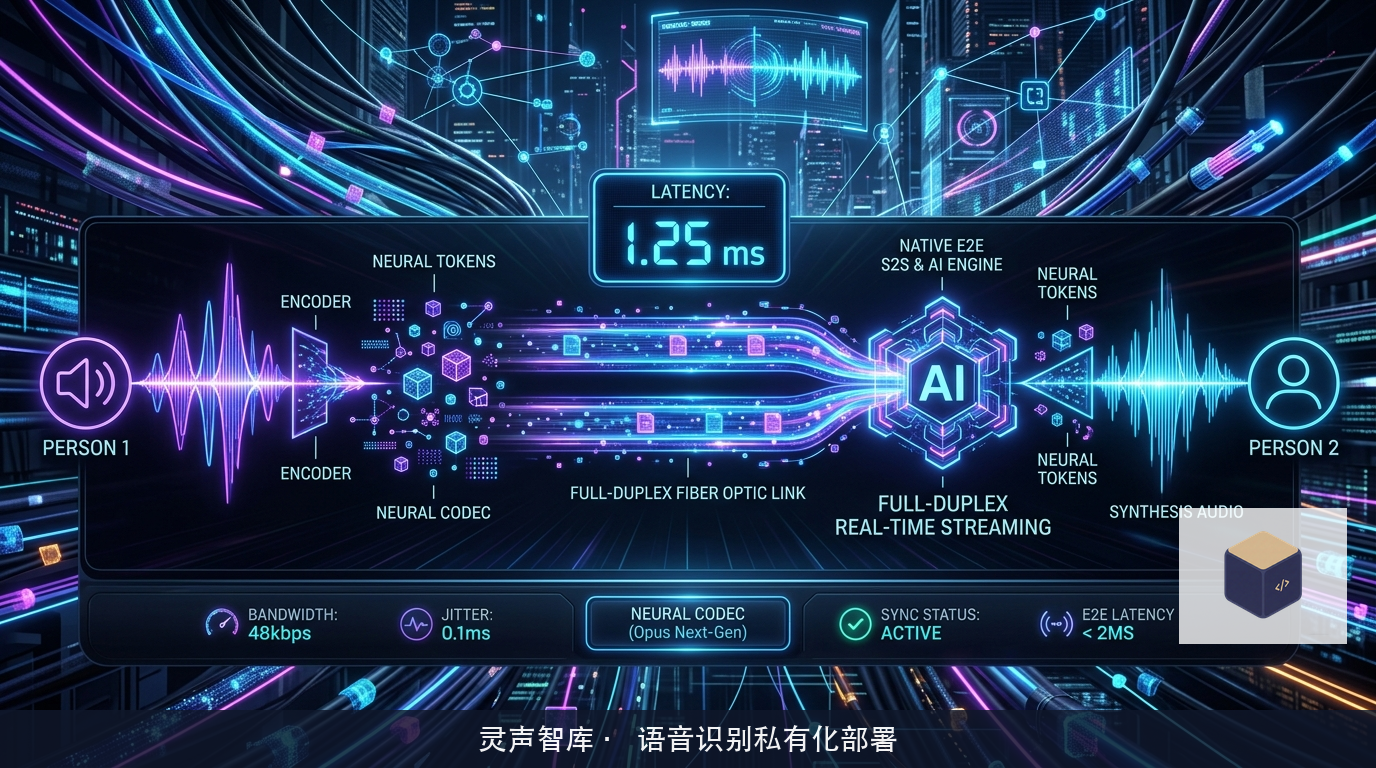
神经声学编解码器与离散残差量化机制
原生语音大模型能够实时吞吐连续声学波形,底层核心依托于新一代神经声学编解码器(Neural Audio Codec)的突破。传统的声学编解码算法如Opus或G.711以保留人类听觉感知为优化目标,输出的连续频谱参数难以直接输入自回归语言模型;
神经声学编解码器基于端到端卷积自编码器与残差矢量量化(Residual Vector Quantization, RVQ)构建:
编码器阶段采用多尺度一维因果卷积神经网络,以极高的采样率将原始音频采样点(如24kHz单声道波形)下采样为低帧率(如50Hz或75Hz)的稠密潜空间嵌入向量;
矢量量化阶段引入8层至16层级联的离散码本。第一层码本负责捕获音频的核心语义信息与基频轮廓,后续层级的码本依次逼近高阶声学残差细节,如音色泛音、呼吸声与微弱环境声学混响;
通过这种级联离散化处理,连续的物理波形被转化为多条并行的离散代币(Audio Tokens)流,与文本标记在相同的特征维度上进行统一对齐与因果自注意力交互;
在解码端,流式因果解码器接收模型生成的声学代币,无需等待整段话语结束,仅需缓存极短的数个音频帧(约20毫秒),便能借助轻量级转置卷积网络实时逆向合成高保真自然波形,为真正意义上的即说即答提供了底层算子支撑。
毫秒级时延预算与全双工打断因果掩码设计
在全双工交互系统中,最关键的体验衡量指标是双向交互时延与自然的插话打断(Barge-in)能力。为了将人耳感知的整体等待时间锁定在生理舒适区间(300毫秒之内),工程师必须对整个系统的数据流链路建立严格的时延预算分配模型:
物理麦克风采集与声学前端降噪预留20毫秒;神经声学编码器帧聚合与特征抽取消耗40毫秒;流式传输协议网络往返时延在局域网专网环境下控制在15毫秒以内;模型前向计算生成首个音频响应帧限制在120毫秒以内;TTS声学逆变换与DAC数模转换播放占用30毫秒。这一严密的时间预算要求链路中的每一个节点都必须具备因果流式处理特性,绝不允许出现任何全局阻塞式缓冲。
更为复杂的工程难题在于如何优雅地实现对话打断与回声自适应消除:
在传统半双工交互中,当系统推流播报时,麦克风采集通常被强制静音,以防扬声器播放的声音被麦克风二次拾取形成啸叫或误识别;
在全双工架构下,模型在向用户持续推流输出的同时,底层的输入通道始终保持全开状态。研发团队必须在注意力矩阵内部引入非对称的因果跨模态时间掩码:
模型不仅要并行处理输入与输出两条时序流,更要通过实时的自声回声抵消(AEC)算子,从麦克风混音中精准分离出远端播放信号与近端用户的新发声;
当检测到近端用户突然发出具有打断意图的词句(如“不对”、“请稍等”或轻微反问)时,系统调度器在10毫秒内发出中断指令,瞬间截断正在生成的输出音频流,同时重置生成状态缓存,使上下文注意力焦点瞬间无缝切换至用户刚刚插入的新意图之中。
在实际人机对话中,人类在思考时往往会伴随无意识的叹气、喉音或背景环境物品碰撞声。如果模型过于敏感,这些非语义的微弱声响就会误触发打断逻辑,造成播报频频中断;反之,如果打断门限设得过高,用户必须大声呵斥才能中止系统,体验将极其恶劣。因此,工程团队在因果掩码之后引入了语义级打断判定轻量模型,仅在声学特征与语义意图双重共振时才执行确定性打断,极大提升了会话流畅度。
专网复杂网络拓扑下的抖动缓冲与动态丢包补偿
当这套高精度全双工音频流系统从本地环回测试环境部署至跨园区、跨省域的企业专网或高安全隔离内网时,网络传输层的不确定性便成为破坏声音连续性的主要杀手。
语音不同于普通的网页数据传输,它对抖动和丢包具有极高的敏感性。TCP协议由于强制按序到达与丢包重传机制,在偶发网络抖动时极易引发瞬间的TCP队头阻塞,导致推流侧出现肉眼可见的语音停顿与破音。
成熟的工业级方案全面拥抱基于UDP优化的WebRTC数据通道或QUIC自定义流式传输协议,并针对神经声学代币研发了深度协同的丢包补偿算法(Packet Loss Concealment, PLC):
客户端部署基于强化学习的自适应抖动缓冲区(Adaptive Jitter Buffer)。缓冲区根据过去数十个数据包的网络延迟方差,动态微调排队队列深度,在网络顺畅时激进压缩延迟至10毫秒,在网络波动时平滑扩展至40毫秒,确保播放端绝不发生因欠载造成的静音断音;
当网络发生连续物理丢包时,传统的线性插值算法生成的声音充满金属杂音。新一代系统利用神经编解码器内置的声学先验,在解码端运行轻量级自回归生成单元。即使连续丢失3个声学代币包(对应约60毫秒声音),解码器仍能凭借前序语音的声门周期与声道共振峰特征,平滑外推合成高度自然的音素过渡,使人类听觉完全无法察觉丢包痕迹;
此外,在面对极度恶劣的无线工业专网时,传输层还会自适应开启前向纠错码(FEC)冗余注入机制。发送端根据实测丢包率矩阵,在常规音频包之间动态交织插入轻量异或奇偶校验包。即使链路上突发15%以内的随机丢包,接收端也可以在无需发起网络重传的前提下利用本地纠错直接重构原始声学代币,从协议层彻底消除通信卡顿,保障了专网调度与核心会议场景下的顺畅沟通。