大模型技术的演进重心正在从单纯依赖预训练阶段的百亿千亿级无监督文本堆叠,不可逆转地转向推理阶段的自适应计算资源分配。在学术界和工业界前沿实践中,这一转变被统称为测试时算力(Test-Time Compute)范式跃迁。过往的因果语言模型在面对高阶数学证明、复杂的底层网络故障排查或者涉及数百条异构规则的金融审计时,往往受限于单向生成的局限性,一旦前序词元出现轻微逻辑偏差,后续生成就会不可避免地陷入不可逆的级联幻觉中。
新一代深度推理大模型通过将马尔可夫决策过程、蒙特卡洛树搜索(MCTS)思想与自回归网络深度结合,赋予了模型类似人类专家的反思、自我验算与路径剪枝能力。模型不再依赖单纯的前向贪心采样,而是在隐状态空间中展开动态思维树。然而,当这种慢思考范式从算力极其充沛的公有云实验室环境走向对确定性、数据私密性和计算时延有严苛要求的金融、能源调度以及核心政企物理隔离专网时,底层工程系统不得不面对一场由隐层展开与显存爆发引发的严酷博弈。
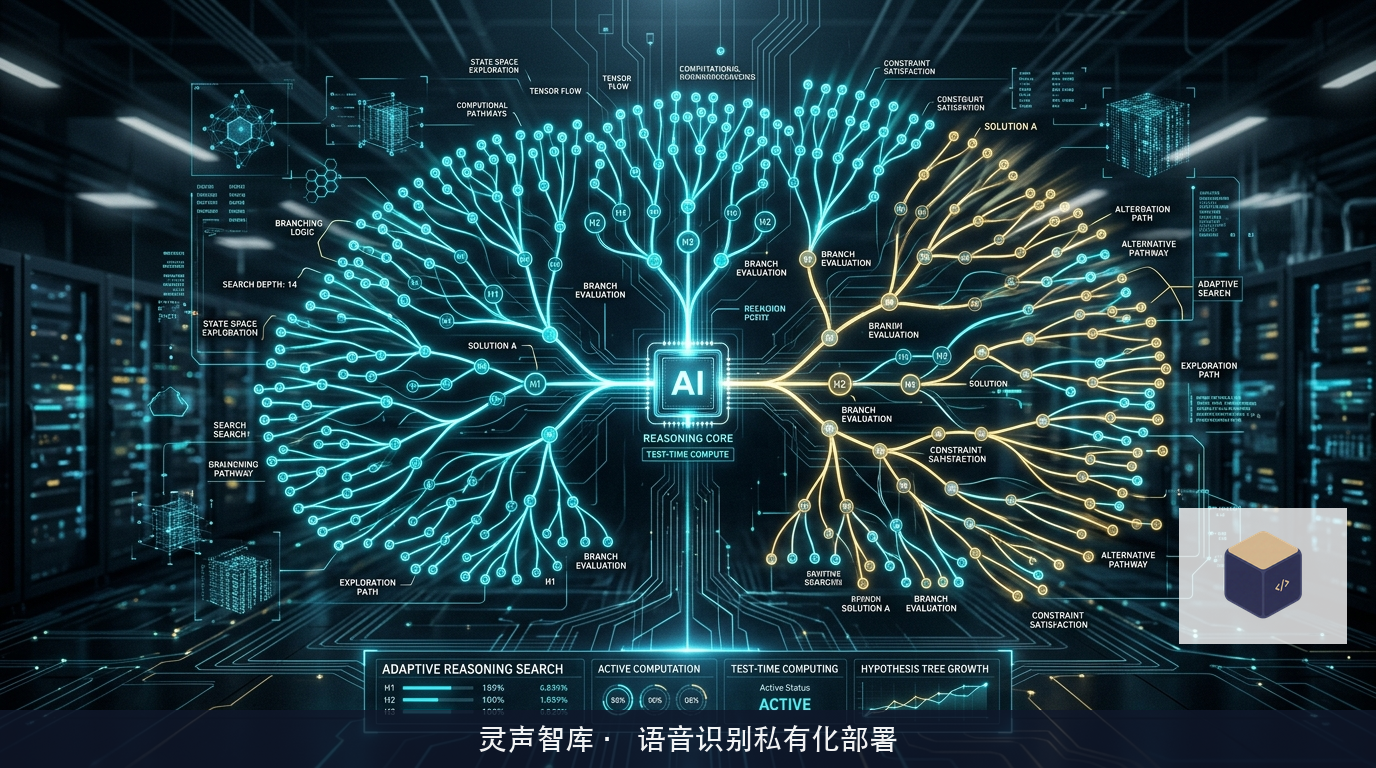
过程监督模型与状态空间自适应展开机制
传统的强化学习对齐普遍依赖基于最终结果的奖励模型(Outcome-supervised Reward Models, ORM)。在处理简单常识对话或文学创作时,基于结果的评分机制足以引导模型输出得体的文本;但是在长程逻辑推导任务中,最终结果正确并不意味着推导过程无懈可击,往往存在大量巧合猜测;反之,若一个推导步骤在第99步出现微小笔误,整个推理链条便会被粗暴判定为负样本,导致强化学习信号极其稀疏且充满噪声。
过程监督模型(Process-supervised Reward Models, PRM)的成熟彻底扭转了这一局面。系统不再仅仅在答案生成完毕后给出单一的标量分值,而是在思维链的每一个逻辑断句、方程展开或代码断言节点,即时介入并进行细粒度价值评估:
算法引擎为每一个生成的中间状态生成一个介于0到1之间的置信度标量。这个标量反映了当前推演状态收敛到正确解集的理论概率。当置信度高于预设动态阈值时,解码引擎继续沿当前路径向下前行;
若置信度跌入不确定区间,系统将激活局部采样机制,并发派生出3到8条不同的演算假设分支,让多个候选路径在隐层空间进行对抗式博弈;
而一旦某条分支被评估为逻辑违背或死循环,剪枝算子会即时切断该分支的计算图展开,强制回退至上一个置信度高位节点,并在反思提示引导下尝试全新的求解方向;
在强化学习的训练优化层面,研究团队进一步将蒙特卡洛树搜索的Rollout模拟机制融入微调循环。模型在离线策略迭代过程中,针对数十万条带有过程标注的复杂推理轨迹进行自监督学习,逐渐内化出一种自适应调节思考深度的能力。这种在隐空间自发构建的动态搜索树,使得大模型不仅能够解决多步嵌套的复杂约束问题,更在本质上将逻辑推理从盲目的单向概率采样演化为具备自我纠错韧性的确定性搜索过程。
专网物理隔离环境下的动态KV Cache与显存墙困境
虽然测试时搜索展现出惊人的逻辑深度,但在企业私有化机房与专网推理集群中落地时,该机制对硬件显存架构带来了极具破坏性的压力。
在标准因果推理场景下,KV Cache(键值缓存)的增长与生成的输出长度呈现完全线性的严格对应关系。工程团队可以通过预先计算批处理大小(Batch Size)与最大上下文长度(Max Sequence Length),极为精准地规划每张GPU计算卡的静态显存分配方案;
但是在引入自适应树搜索机制后,单次请求所消耗的思维标记数量完全无法在事前进行静态预测。针对日常信息查询,模型可能仅耗费100个中间标记即可收敛;而面对一次多维数据异常回溯任务,模型展开的搜索树深度可能达到数千甚至上万步,产生数以万计的隐式思考标记;
这种动态爆发的中间过程给专网显存管理带来了两大致命挑战:
其一是PagedAttention等虚拟显存分页算法遭遇高频内存碎片化。由于不同推导分支的并发派生与频繁销毁,原本连续的显存块被迅速切割为大量不规则碎片,虚拟显存管理器的页表映射开销呈指数级攀升。垃圾回收机制的频繁触发直接导致GPU张量计算单元出现周期性的管线停顿与算力空转;
其二是并发吞吐量的雪崩效应。在私有化专网部署中,企业往往受限于既有的硬件采购预算,单台服务器通常仅配置4至8张主流企业级计算卡。当多个业务部门同时发起复杂审计任务时,数个请求的思维链同时爆发性展开,瞬时显存开销将直接突破显存物理上限,进而触发系统的内存交换(Swap)甚至导致推理进程出现OOM致命崩溃;
不仅如此,专网环境通常要求严格的离线物理隔离,无法依赖公有云的弹性伸缩集群在流量洪峰时动态调配额外节点。一旦集群内部的显存池被撑爆,所有的实时业务接口都将面临超时断连的风险。这种显存容量的不确定性,成为了横亘在测试时算力模型与企业生产环境之间的一道巨大鸿沟。
投机性验证器协同与分层动态剪枝工程落地
为了在有限的物理隔离专网硬件资源约束下释放深度推理能力,业界的系统架构团队开始转向软硬件协同的分层推理架构设计。
核心突破口在于将笨重的大参数主模型与轻量化的小参数验证器进行异构流水线解耦。系统不再由千亿级基座模型独自承担所有的路径探索与价值打分,而是构建双阶段协同推理流:
前置阶段部署一个参数量在7B到14B之间的高能效投机草稿模型(Draft Model)。该模型专注于根据用户指令快速展开多条潜在的推演框架,生成包含伪代码或数学步骤的骨架思维链;
后置阶段由高精度基座模型与PRM验证器组成仲裁核心,仅对草稿模型提交的候选骨架中的关键逻辑分歧点进行并行批量验证。如果关键分歧点的逻辑一致性校验通过,系统直接复用草稿模型的上下文张量;若校验未通过,基座模型才介入进行精确重算;
在此基础上,工程师针对动态搜索树研发了树状KV Cache共享与就地覆写算子(In-place Overwrite Operator)。当多个推导分支共享相同的初始问题与前置思考步骤时,系统在显存底层强制只保留一份父节点的物理页指针,所有分支以只读方式共享前序上下文;
当某条探索分支被PRM判定为无效并触发剪枝时,内存管理系统并不立即释放物理页,而是将该分支对应的显存页块直接标记为覆写候选区,无缝供给下一条新衍生出的推演分支就地复用。这一设计直接消除了90%以上的显存动态分配系统调用开销;
实测基准数据显示,这种轻重协同的分层机制配合底层树状缓存就地覆写技术,能够将整机系统的端到端显存占用压降50%以上,同时将单卡支持的并发会话数提升2.4倍。在无法连接公有云弹性算力池的严格断网局域网中,这种深度的系统级工程权衡成为了将深度推理模型转化为企业级生产力工具的必经之路。