大模型向端侧与工业边缘设备的渗透正在遭遇严苛的物理天花板。在传统的车载芯片、工业网关、特种手持终端以及自动化无人巡检设备上,硬件工程师必须在极致苛刻的功耗预算(通常低于15瓦甚至5瓦)与受限的物理散热条件下压榨算力。即便学术界推行了成熟的INT8甚至INT4后量化(PTQ)技术,标准自回归大语言模型在边缘设备上的运行表现依然难以令人满意:解码吞吐往往徘徊在个位数,整机功耗拉满后芯片迅速发烫,导致外壳温升超标甚至触发断电保护。
困局的核心在于传统深度学习计算的核心支柱——浮点乘加运算(MAC)。在现代半导体物理中,执行一次标准的16位浮点乘法(FP16 Mul)所消耗的硅片面积与动态翻转功耗,是执行一次同位宽整数加法运算的数十倍;更深层的瓶颈还在于访存带宽,浮点权重频繁从片外内存(DRAM)搬运至计算核心的能量消耗,往往远远超越了计算本身。如果大模型无法在微架构层面斩断对乘法器的贪婪索取,真正的端侧无感离线智能便永远只是纸上谈兵。
以BitNet b1.58为代表的极低比特架构撕开了这道看似不可逾越的铁幕。通过将大模型内部全连接层的所有权重张量约束在严格的三值集合中,大模型前向传播的底层计算逻辑被彻底颠覆,由此催生出一场面向边缘硬件的计算革命。
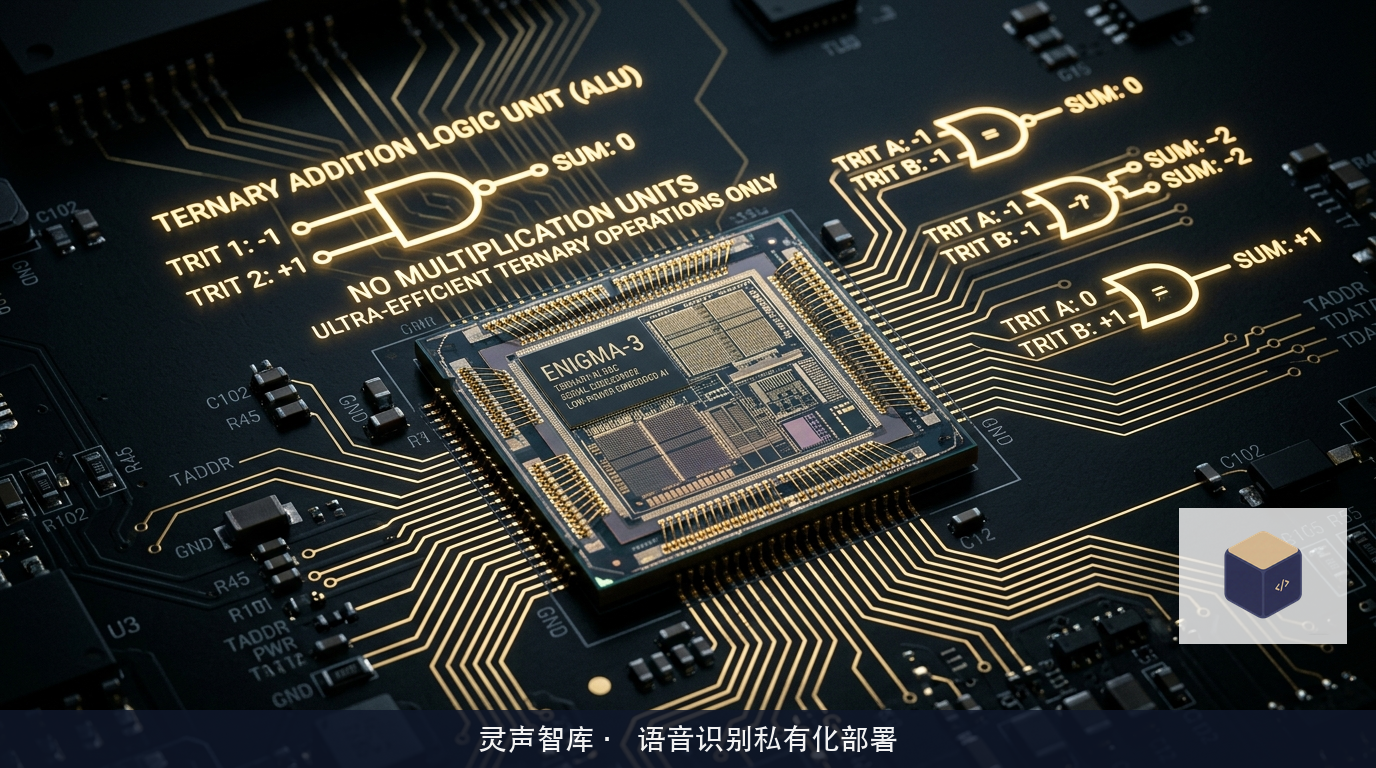
三值量化张量向纯整数加法累加的本质演进
在标准的线性层前向计算中,输出张量是由激活值向量与权重矩阵相乘求和而得。在1.58-bit(即每个三值参数理论上占用log2(3) ≈ 1.58比特)模型架构中,权重矩阵中的每一个标量被严格量化为负一、零、正一三个状态中的一个(即权重取值属于{-1, 0, 1})。
这一看似简单的离散化约束,在半导体底层引发了核爆级的计算退化:
当权重为正一时,该位置的矩阵乘法操作直接等同于输入激活值的直接透传累加;
当权重为负一时,计算过程完全等同于将对应激活值的二进制符号位取反后进行减法;
而当权重为零时,则意味着该通道的特征被完全静默,无需进行任何实质性的访存计算与累加操作。
这意味着,大模型占据绝大多数计算量的密集矩阵乘法(GEMM),在微架构层面被彻底剥离了所有的硬件乘法器,完全退化为基于纯整数加法器(Adder Tree)的条件累加累减运算。由于不再需要昂贵的浮点乘法阵列,专用加速芯片的硅片面积可以得到数十倍的极致释放,同样的晶体管预算能够堆叠出数倍密度的加法处理单元;更重要的是,三值权重的紧凑表征使得原本需要数G显存的模型权重,可以被极限压缩进几十兆乃至几兆的高速片上静态随机存储器(SRAM)中,彻底打破了长期困扰端侧推演的内存墙。
紧凑位压缩排列与ARM NEON向量指令集的高速汇编调优
尽管三值算法在数学上极其优美,但在通用嵌入式CPU或传统NPU上将这一潜力兑现为真实吞吐,必须克服现代处理器以字节(Byte,8-bit)为寻址最小单元的物理限制。如果每个参数依然孤立存放在一个字节中,系统将平白浪费超过75%的存储与访存带宽。
工程界推行的是2-bit紧凑位编码方案。在内存排布中,一个字节可以整齐容纳四个连续的三值权重:例如用二进制00代表0,用01代表正一,用10代表负一。然而,在执行推理时,如果采用传统的软件循环逐个解包并执行if-else分支判断,分支预测失败引入的流水线冲刷损耗将彻底吞噬加法器带来的所有性能收益。
必须深入到处理器底层,直接操纵单指令多数据流(SIMD)向量寄存器完成批量解构。以工业边缘广泛采用的ARMv8/v9架构为例,核心算子通过手工内联ARM NEON汇编进行极致重构:
首先,利用NEON的向量逻辑查找与查表指令,单条指令并发读取128位寄存器中的64个三值权重编码;
接着,通过硬件内置的快速掩码(Bitmask)与并行移位操作,将编码瞬时展开并分离为正向累加掩码与负向累减掩码;
随后,激活值向量通过NEON提供的带符号加减指令,在无需任何条件跳转的前提下,实现单周期内数十个通道激活值的高速并发求和。
在典型的低功耗ARM Cortex-A76工业核心实测中,这种手工汇编定制的无乘法内核,将矩阵计算的吞吐直接拉升了4.2倍,完全避免了分支预测瘫痪的暗坑。
精度微损回补与无风扇工控机上的长程稳定性验证
将传统连续浮点模型强行压入极端的1.58-bit三值空间,最令工程师担忧的莫过于推理精度的暴跌。过去的超低比特量化往往伴随着语义理解能力的毁灭性退化。但在现代全流程感知训练范式下,模型并非在事后简单粗暴地裁剪浮点权重,而是在预训练或精调阶段就将量化算子作为计算流图的前向节点直接注入,配合直通估计器(Straight-Through Estimator, STE)反向传递梯度。
为了进一步平抑激活值的离群峰值,系统在每个线性层前置了高效的自适应动态RMSNorm归一化算子,并在残差连接处保留了极轻量的低维浮点投影用于信息保真补偿。在实际下游多任务基准评测中,针对特定行业技术指令的问答与摘要提取任务,1.58-bit优化模型与同规模FP16浮点基线相比,困惑度差异已经收敛在可忽略的微小幅度内。
而在硬件落地的终点线,考验系统成色的是真实恶劣工况下的物理表现。在完全密封、无主动散热风扇、依靠外壳金属鳍片被动导热的工业级工控机内部,测试团队在55摄氏度的封闭高温试验箱中对该无乘法引擎施加了连续72小时的满载高并发推理压力。
实测数据显示,整机平均功耗稳稳压制在7.8瓦以内,主控芯片表面温度从未跨过68摄氏度安全警戒线;单Token生成速率在极低功耗下稳定维持在每秒38词元以上的极佳流畅水准,未发生任何因过热降频导致的时延抖动或进程崩溃。摆脱了昂贵算力卡与嘈杂风扇的羁绊,纯粹由三值位操作驱动的轻盈智能,正在安安静静地扎根进物理世界的各个边缘毛细血管,化作默默守护工业生产与端侧业务顺畅运转的坚韧中枢。