人机语音交互在过去很长一段时间里被困在工业拼装流水线的桎梏之中。在传统的语音对话系统中,系统架构被机械地切割为三个孤立的串行阶段:首先是自动语音识别(ASR)引擎将接收到的连续模拟声波强制硬解压为离散的纯文本字符;随后大语言模型(LLM)接收文本词元展开逻辑推理并逐字输出答案文本;最终由语音合成(TTS)模块将文本再次渲染为人工合成声波。
这种三段式流水线在实际生产应用中构筑了一道无法逾越的时延死局。即便每个模块单体都经过极致调优,三个阶段在通信转换、词元打包、语义缓存和声学解码过程中的累加延迟,使整体端到端往返时延(RTT)极难稳定压降至600毫秒以内。更为致命的是,在语音转写为冷冰冰文本的瞬间,说话人的重音倾向、情绪波动、讽刺反问语调以及环境物理背景音等关键副语言信息被彻底剥离殆尽。要实现真正行云流水的实时交互,整个技术栈必须彻底推倒重来,迈向统一的多模态原生全双工音频流架构。
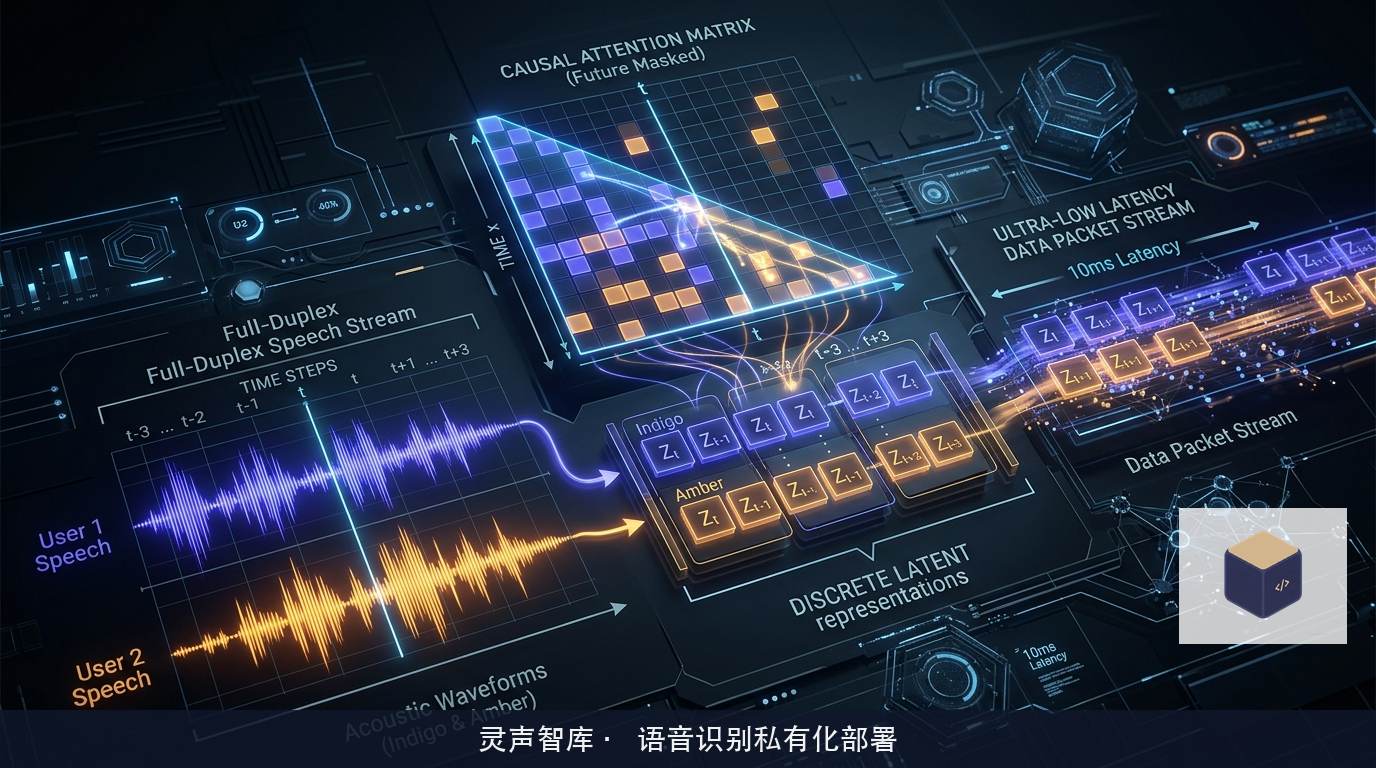
连续隐表征与神经音频编解码器的端到端闭环
原生音频模型的基石是摒弃中间的文字中介,让模型在大脑底层直接以音频的连续隐状态进行思考与输出。实现这一跨越的核心技术利器是新一代神经音频编解码器(Neural Audio Codec)。
传统的MP3或AAC等音频压缩格式依赖心理声学模型与离散余弦变换,其产出的位流无法直接与自回归神经网络的向量嵌入空间对齐。现代神经编解码器则构建于深度卷积与残差矢量量化(Residual Vector Quantization, RVQ)基础之上。在输入端,编码器以极高的采样率捕获原始PCM波形,在微观时域窗口将其下采样并投影至高维连续潜空间;随后的多层RVQ通过级联的离散码本,将连续特征层层剥离为离散的声学代码表征(Acoustic Tokens)。
在原生全双工模型中,这些音频代码直接与语言文本词元混编在相同的自回归主干网络中。模型不再经历先看文字后读拼音的间接过程,而是在注意力矩阵内部直接建立音频输入词元到音频输出词元的深层映射。在输出端,神经流式解码器能够直接根据模型生成的声学潜变量,实时重构出兼具极高自然度与丰富语调细节的波形切片。
这种端到端架构彻底抹去了模块间协议转化的粘滞时延。然而,从单向批量生成走向连续全双工(Full-duplex)实时推演,底层模型还必须解决因果注意力掩码在流式推进中的严酷时序约束。
Chunk级因果注意力掩码与自适应时间窗口推移
在传统的离线自注意力机制中,模型被允许一次性俯瞰整个音频时序维度的全部历史与未来上下文。这种双向非因果注意力(Bidirectional Attention)虽然能够带来极高的识别与生成准确率,但在实时流式场景下完全不具备可行性——系统不可能在用户说话的第1秒去预先获取第5秒才会发出的声学信号。
实现零等待实时生成的关键在于严格的因果注意力掩码(Causal Attention Mask)设计。在因果掩码矩阵中,任何时间步的特征仅允许对自身及位于其左侧的过去时间步施加注意力权重,未来的未发生时间步则被置为负无穷大而彻底遮蔽。
但如果机械地将因果注意力粒度细化到每一个离散的采样点或极短帧,模型在注意力计算中会由于缺乏局部语境感知而导致音色断裂和严重的呼吸声破音。工业级落地的核心折中是自适应分块(Chunk-level)因果机制。
系统将连续输入的音频流切分为动态可伸缩的时间块(例如每个Chunk跨度为40毫秒至80毫秒)。在每个独立的Chunk内部,所有帧之间被允许进行局部的双向全连接注意力,以确保音素特征的局部连续性与谐波完整性;而在跨Chunk之间,则推行不可逾越的严格单向因果流向。
更进一步,为了防止自回归注意力矩阵随着对话时长的拉长而引发显存灾难性膨胀,系统集成了自适应局部滑动窗口(Sliding Window Attention)与全局声学压缩锚点。对于数十秒以前的远端对话历史,模型不再维持点对点的细粒度声学状态连接,而是将其降维聚合为低频的宏观语义表征;而对于当前发音点前后的临近窗口,则保持最高精度的密集因果注意力。这种分层时间推移策略将流式前向推演的单步计算复杂度稳定在常数级O(1),为毫秒级持续响应清除了核心算力路障。
物理网络乱序抖动对抗与双讲打断状态检测
当算法在实验室本地环境压测出极低延迟后,将系统推向跨公网或复杂企业专网部署时,不可预测的物理网络抖动(Jitter)与偶发丢包成为了毁灭真实交互质感的最后一道难关。在音频交互中,哪怕连续丢失2个音频数据包(几十毫秒的断续),人类耳朵也能立刻捕捉到刺耳的爆音或卡顿。
在传输控制层面,单纯依赖TCP协议的重传机制会因超时等待引入数十毫秒的灾难性排队时延,而原生UDP裸传又面临丢包数据永久缺失的风险。高可靠架构普遍在传输层构建私有化的极速前向纠错(FEC)与自适应Jitter Buffer动态平衡网络。
网络接收端并不机械等待固定大小的缓冲池填满,而是通过机器学习模型实时预估当前物理链路的时延方差与丢包倾向。当网络出现轻微拥塞时,神经网络解码器自适应启用基于隐状态流形的声学外推算法(Packet Loss Concealment, PLC),利用上一周期注意力状态在隐空间平滑预测并填充微小缺失段,完全无需暂停播放等待数据重发。
更为精妙的是在双讲(Double-talk)与语音打断(Barge-in)场景下的状态机演进。在全双工体系中,模型在扬声器对外发声的同时,麦克风仍在毫秒不停地持续收音。如果系统无法极其敏锐地剥离扬声器自身声音的回声干扰(AEC),或者无法在用户突然发声插话时秒级抑制模型自身的自回归展开,就会出现人机互相对吼、逻辑彻底混乱的滑稽场面。
现代流式引擎在声学前端内嵌了轻量级的全双工声学状态判定头。该网络在用户声波到达的前50毫秒窗口内,极速鉴别该信号究竟是背景突发噪音,还是具有明确沟通意图的主动打断。一旦判定为用户主动打断,推理引擎瞬间向底层GPU发射软中断指令,在数毫秒内强行斩断自回归生成队列,清空待播音频缓冲区,并将模型的思维焦点无缝重定向至用户最新的语音片段。正是这种在时延、音质与交互意图之间千锤百炼的极致控制,才使得冷冰冰的数字智能真正具备了与人类进行同频呼吸、自然对答的真实生命感。