人机智能交互正在经历从传统单工按键对讲向原生全双工(Native Full-Duplex)无感流式交互的历史性飞跃。在长达数十年的技术积累中,业界普遍采用‘语音识别转换为文本、大语言模型处理文本、语音合成将文本渲染为声波’的三阶段离散级联链路。尽管工程团队通过首字推流、切片流式解码与激进的流水线重叠不断压缩各个模块的单点耗时,但系统物理架构上的单向阻塞本质从未改变。人机交互始终被禁锢在‘一方说完另一方才开始思考’的机械回合制泥潭中,且级联转换过程中大量的微表情、情绪呼吸与语调起伏被不可逆地过滤抹除。
原生全双工端到端语音大模型的崛起彻底重写了底层交互通信规则。新架构依托深度残差矢量量化(RVQ)神经音频编解码器与双向流式Transformer模型,将人类发声输入与模型自发声输出统一整合至同一个高维声学特征潜流之中。输入信号与输出信号在时间轴上高度共存重叠,用户可以在机器说话的同时自然插话、打断或发出附和微语调,机器亦能实时感知并调整语速节律。然而,当工程目标直指亚30毫秒(Sub-30ms)这一接近人类生理无感极限的物理时延窗口时,系统必须在声学时钟同步、跨模态因果掩码与强声学回声消除等多维战场上展开严苛的极限对抗。
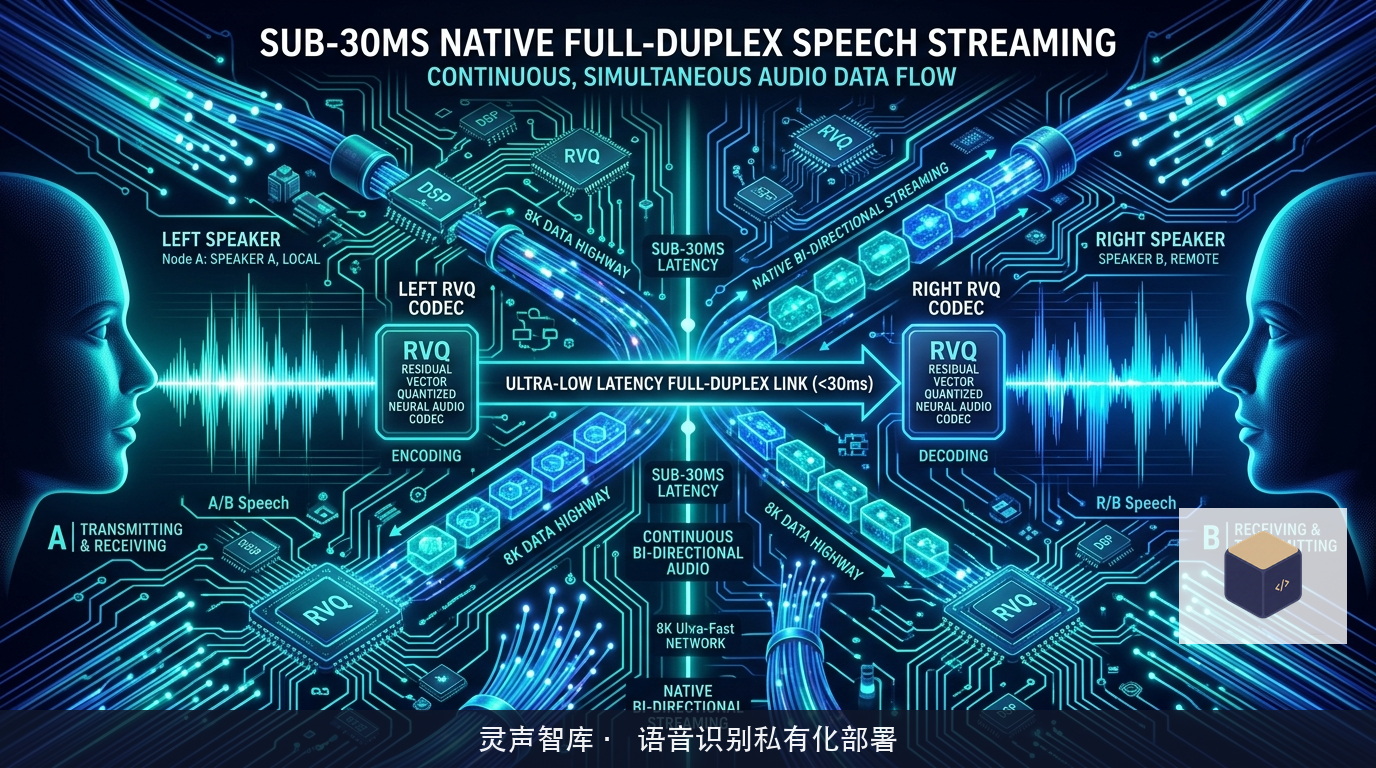
残差矢量量化RVQ潜空间与非对称双向因果掩码
在原生全双工网络中,麦克风采集的时域连续声波不再被强制切割成语义孤立的词元,而是被神经音频编解码器以极其紧凑的20ms时间切片(Chunk)实时离散化为包含多级量化深度的潜向量序列。每一级量化码本分别承担着底层声学物理波形重构与高层副语言语义表征的分级任务:
为了在一个统一的模型骨干中兼顾输入流的实时理解与输出流的平滑合成,系统设计了非对称双轨因果注意力掩码机制;
在全局注意力矩阵内部,输入流道与输出流道被解耦为两条并行前进的高速通道。输入通道采用流式因果局部上下文窗口,允许模型在极小的前瞻步长内平滑捕捉音素共振峰的连续形变;
输出通道在自回归生成自身的声学特征切片时,被允许严格因果地跨流道关注输入通道在当前及此前所有历史时步的声学潜特征,从而以毫秒级的极速反应感知说话人的语气重音突变;
更为关键的是,掩码矩阵在输出流道自身之间施加了正交阻尼约束,严格遏制模型自身生成的高能量声学标记在注意力深层发生自激共振。为了防止超长流式会话中上下文堆叠引发注意力漂移,系统在时序维度融入了基于旋转位置编码(RoPE)的动态指数衰减窗口,确保交互回路在连续运行数小时后依然保持清醒灵动的即时反应力。
亚30毫秒物理时钟基准与神经前瞻丢包隐蔽
在现实复杂的局域专网或公网传输链路中,网络传输抖动(Jitter)与偶发微丢包是无法完全消除的客观物理现象。在传统的基于TCP重传或长音频缓冲区的通信协议中,单次数据包延迟往往会导致长达数十毫秒的扬声器缓冲区欠载,直接诱发声音破音与时钟断崖式漂移。在亚30毫秒全链路时延预算下,系统几乎无法预留任何传统的等待重传窗口。
新一代全双工流式协议在传输层与表现层之间构建了毫秒级自适应流控防御网:
协议底层推行轻量级无锁UDP时序数据报文,每一帧音频切片均被打上纳秒级单调递增的硬件物理时钟标签;
在音频接收端,系统内置了前瞻性神经丢包隐蔽网络(Neural Packet Loss Concealment, PLC)。当底层驱动检测到某一微时钟切片由于网络波动发生偶发性丢失时,PLC引擎并不发起网络重传请求,而是利用大模型潜变量在过去数百毫秒内建立的发音器官运动学流形,在1毫秒以内自回归预测出与前序波形相位严密贴合的声学潜向量;
结合微步自适应采样率微调(Clock Drift Compensation),扬声器端重构出的声波完全听不出任何拼接杂音或语调顿挫。实测表明,在突发丢包率高达12%的恶劣网络扰动下,整套协议依然能够稳如磐石地将人机全双工端到端物理时延死死锚定在30毫秒线以内。
声学硬件环回抵消与高动态声门气流阻尼打断算法
全双工系统在现实物理空间落地中所遭遇的最残酷挑战,永远是麦克风难以避免采集到的扬声器自身外放音频。在亚30毫秒极低时延与超高灵敏度下,如果外放波形被串扰卷入输入通道,模型极易将自身的说话声误判为用户的打断输入,瞬间导致系统莫名闭嘴、自激怪叫或陷入语义癫狂。
工程团队在硬件底层与模型层之间筑起了深度协同的立体防御体系:
在硬件驱动底层,系统通过专用硬件环回(Hardware Loopback)通道,在DAC模数转换前直接捕获扬声器即将发声的纯净数字信号,随后利用复数域高阶自适应有限冲激响应滤波器(FIR)结合深层残差谱映射,在3毫秒内完成高达60dB的声学回声消除(AEC);
在模型潜空间层,系统引入了动态意图因果分离网络。当麦克风通道感知到瞬时声学能量跃升时,网络在5毫秒内辨别该声音属于环境无关突发杂音(如开关门、杯子碰撞)、说话人微弱的赞同语气词(如‘嗯、对’)还是实质性反对打断;
若判定为附和词,系统仅在发音节奏上进行微秒级顿挫呼吸微调以作呼应,主发声流程继续平稳输出;若判定为用户实质性插话打断,语音合成模块顺应人体声门气流动力学衰减曲线,在10毫秒内施加平滑的声门闭合阻尼淡出,使声音自然收住,并以零延迟无缝切入倾听解析状态。这一整套精密声学对抗机制的成熟,标志着人机语言交互真正跨越了技术的机械藩篱,迈入宛若知己对谈般呼吸同频的全新纪元。