以英伟达 Blackwell 架构以及下一代超高密度集群为代表的算力底座,正在将数据中心的物理参数推向令人瞠目的极端边界。单颗加速芯片功耗突破千瓦,单台全互联算力机架(如 GB200 NVL72)的整体设计热负荷直接飙升至惊人的 120 千瓦至 140 千瓦之间。在这一功耗密度面前,过去二十年统治数据中心的传统精密风冷与封闭冷通道制冷技术彻底遭遇物理失效——即便用工业级离心风机以接近直升机旋翼般的转速狂吹冷风,也无法穿透超高密度PCB板卡,更无法将热量从数平方厘米的微型硅基芯片裸晶(Die)上及时剥离。
全液冷甚至相变冷却已经从前沿探索变为高密超算的唯一生存法则。然而,全球绝大多数大型金融机构、科研院所及政企组织的数据中心,其机房基础设施是在单机架功耗仅为 8kW 到 15kW 的时代规划建设的。面对需要推平重来的百千瓦级算力怪兽,如何在不彻底废弃既有土建配电体系的前提下完成液冷改造,并在此过程中驯服微通道流阻失衡与芯片局部热点降频这一对孪生顽疾,成为横亘在一线数据中心工程师面前最严峻的工程大考。
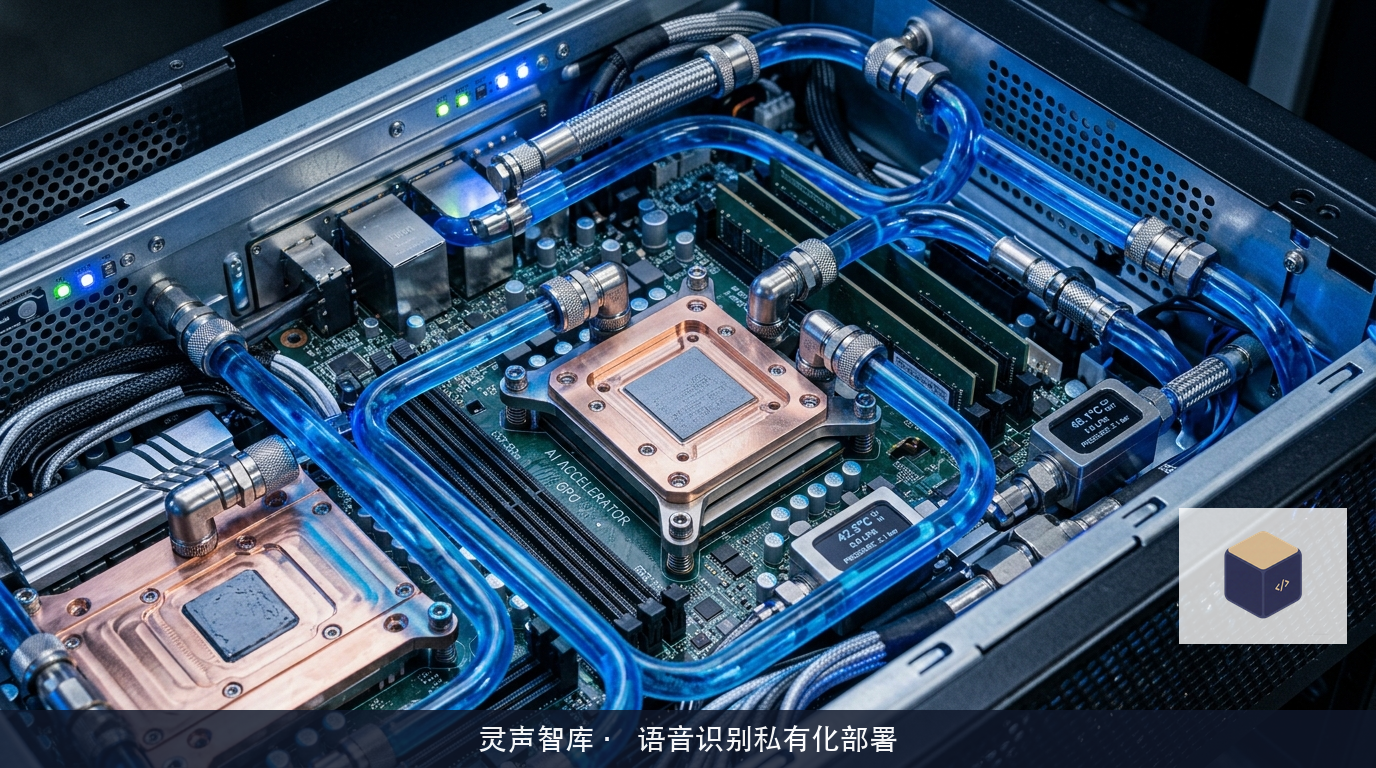
微通道冷板内部流阻失衡与气蚀死区的微观机理
高密液体冷却的核心物理构件是紧密贴合在GPU与CPU裸晶表面的微通道冷板(Micro-channel Cold Plate)。为了在极小面积内换取数倍的换热表面积,铜基冷板内部被激光刻蚀出宽度仅为数十微米、纵横交错的超微鳍片阵列。冷却介质(通常为去离子水与防冻防腐缓蚀剂的复合配方)以受控流速高压强行穿透这些微型缝隙,瞬间带走硅晶圆释放的高温热流。
然而,在单机架容纳数十乃至上百块计算刀片的复杂工业系统中,流体管网的宏观并联与微通道的微观阻力构成了极具破坏力的非线性耦合。当数十组冷板通过分水歧管(Manifold)进行多级并联供液时,根据流体阻力定律,流体总是天然倾向于从物理管路最短、阻力最低的近端回路快速逃逸。如果系统缺乏精密的管径渐变与动态节流设计,位于机柜顶端或管路末端的边缘算力刀片就会遭遇严重的流量饥饿(Flow Starvation)。
更具破坏性的是微通道内部的局部气蚀死区。高密芯片的发热并非均匀分布,处理复杂张量运算的张量计算核心与高带宽显存(HBM)物理堆叠区域的瞬时热流密度极高。当局部热点温度激增时,流经该区域的冷却液黏度急剧下降,在微通道拐角或粗糙边缘形成微观层流脱离与局部低压涡流。如果系统工作压力设定不当,局部压力跌落至该温度下的饱和蒸气压以下时,液体中会瞬间析出肉眼难见的微细气泡(Cavitation)。气泡的积聚不仅阻断了液体与铜壁的导热接触,形成致命的干涸绝热区,更会在下游压力回升时爆裂产生局部微水锤,逐步剥蚀侵蚀精细的微通道表面,埋下灾难性的漏液隐患。
解决这一物理难题依赖于管网全链路的流阻仿真与主动流量平衡。现代高密液冷机架在每个刀片分支入口全面引入了压差无关控制阀(PICV)与多通道数字流速计。无论总管网供液压力如何波动,机械平衡机构自动补偿局部压差变化,将进入每个冷板微通道的流量严格锁定在额定升/分钟公差带内,从而彻底抚平了并联管网中的流量偏流现象。
瞬时全算力突增与芯片热点动态限频的系统级博弈
在数据中心运维视阈下,制冷系统的失效往往不是表现为宏观的冒烟起火,而是隐秘且致命的动态性能跳水。现代GPU均集成了复杂的硬件级温度保护机制(Thermal Throttling)。一旦芯片内部任何一个监控二极管探测到结温触碰95摄氏度的安全红线,芯片固件会在几十微秒内无视任何操作系统调度,强行拉低核心主频甚至直接锁频。
在大规模分布式模型训练或长序列批处理推理中,由于存在全集群同步通信屏障(如All-Reduce),哪怕整座机柜中仅仅有一颗芯片由于散热不良触发了降频,其余所有处于正常温度的昂贵算力节点都必须在屏障前停滞,被迫向最慢的一张降频卡齐步看齐,导致整座集群的有效计算吞吐遭遇毁灭性腰斩。
更为棘手的是由算子计算特征引发的瞬时热冲击(Thermal Transient)。在自回归大模型推理从预填充(Prefill)阶段瞬间切入解码(Decode)阶段时,算力负载会呈现毫秒级的断崖式脉冲震荡。这种瞬时功耗跃变会导致硅芯片表面在短短几百毫秒内升温数十度。而从冷板换热、热量随液体传导至机柜内部的冷却分配单元(CDU),再到二次侧循环水泵接收到反馈加速运转,整个流体热力学回路存在数秒乃至数十秒的固有物理滞后。这种热滞后时间差构成了导致温度突破安全限值、触发降频惩罚的高发危险区间。
对抗这种动态热冲击需要彻底打破IT设备计算负载与设施层制冷调度的信息孤岛。前沿架构推行前馈式温控补偿(Feed-forward Thermal Management):推理框架在向GPU下发大规模密集算子序列的前几十毫秒,同步通过带外总线向机架CDU控制系统发出前馈预警信号;换热系统无需被动等待水温升高探针报警,而是在算力冲击爆发的同时提前将变频循环泵拉升至高转速,拉大冷板进出水压差,利用极速冷液冲刷彻底吸收第一波冲击热焓,将硅晶圆结温牢牢压制在安全阈值之下。
既有机房局部风液混动的改造工程落地平衡
面对无法进行全量推平新建的存量老旧机房,工程团队不可能要求物业在几天内将原本每平米承重仅为800公斤的防静电地板,全部替换为能够承载两吨重整体液冷机柜的重型钢架地坪;更不可能在老旧建筑物外立面重新架设巨大的闭式冷却塔水回路。
在这种约束下,结合了微型行级分布式CDU与局部风液混动的工程妥协方案展现出极强的工业适应性。该方案并不奢求整座数据中心全面废弃冷水机组,而是针对部署了高密AI算力服务器的核心高密区实施微环境重构。
机架内部的核心发热大户(GPU核心、CPU与主内存)完全剥离原有铝挤压风冷散热片,全面替换为微通道直触式冷板;而对于主板周边的供电MOS管、网络接口PHY芯片及固态硬盘阵列等中低热流密度元件,则继续保留定向风道与高效轴流风机进行辅助风冷;机架背部挂载气液热交换背板,风机吹出的中温空气在穿过背板冷水管网时被瞬间二次吸热,排出的空气甚至低于机房环境常温,实现所谓的‘机柜级零热排放’。
通过在每个机架底座内嵌独立的板式换热器,一次侧循环完全复用既有机房原有的冷冻水供应,二次侧则在封闭机柜内部独立维持超纯水循环。在长达数月的真实工况连续追踪中,这种风液混配架构在成功吃下单柜接近百千瓦严苛发热的同时,将机房的电能利用效率(PUE)从传统风冷的1.65一举拉降至1.15左右的优秀区间。在通往极致算力的道路上,真正的技术突破往往不仅发生在纸面上精密的芯片架构图里,更浸润在这些与每一升冷却液的阻力、每一微米流道精度以及每一摄氏度热阻反复较劲的机房实战之中。