人机智能交互的物理形态正在迎来一场推倒重来的重构。在过去近十年的工业实践中,主流的语音交互系统无一例外地建立在三段级联的拼装架构之上:前端部署的自动语音识别(ASR)引擎先将用户的连续语音波形强制转码为离散纯文本;中央的大语言模型(LLM)基于文本词元完成逻辑理解并生成回复文本;最后后端配置的文本转语音(TTS)模块将生成的文本重新合成渲染为声音波形。
这种三段式级联系统在企业专网与复杂业务场景中暴露出难以调和的固有痛点。首先是无法压缩的时延累加,从声学帧解码、文本组包、自回归文字生成再到声学合成,三道工序之间的网络传输与计算缓冲使得端到端交互延迟极难稳定压降至600毫秒以内;更为致命的是,在语音被硬性切碎为静态文本文字的瞬间,说话人声音中包含的充沛语调起伏、重音停顿、情绪张力乃至背景环境声学信息全部被清洗殆尽。
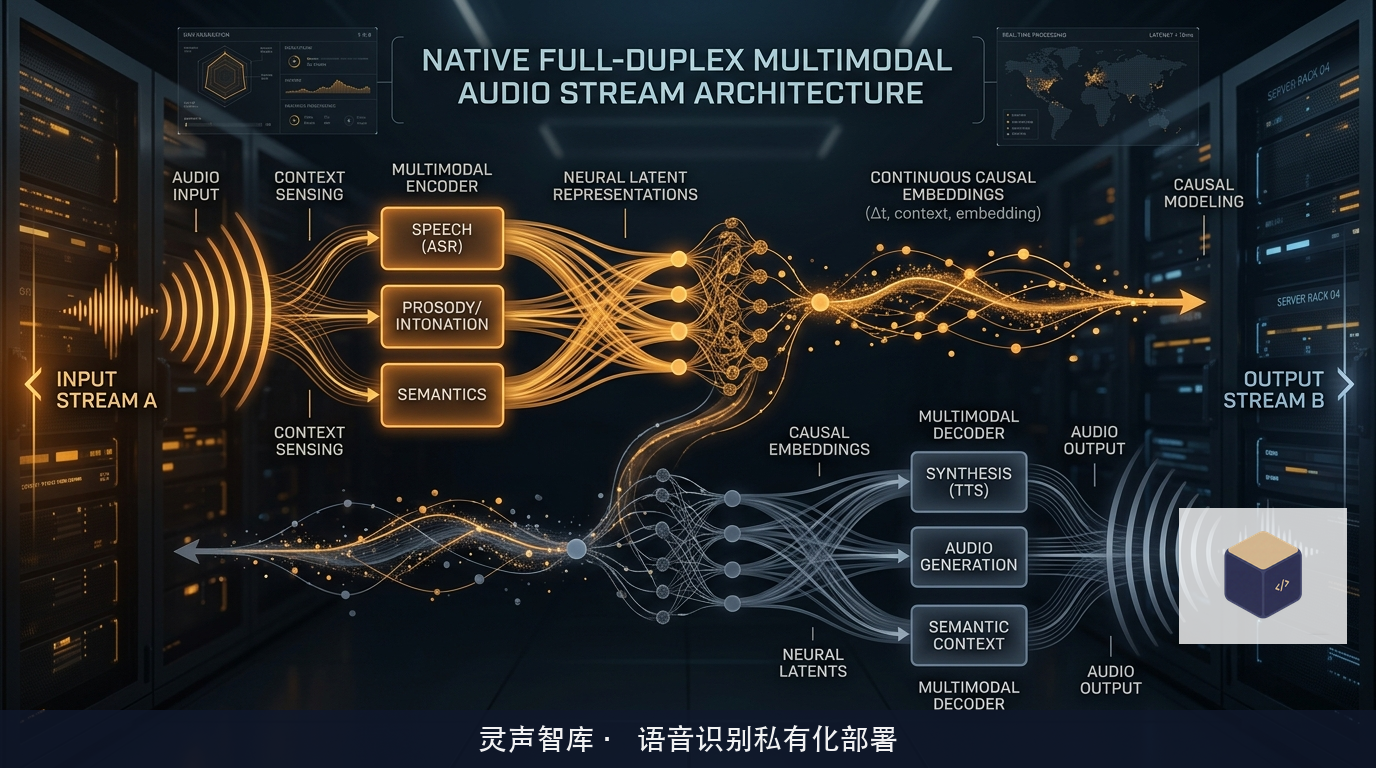
为了彻底打破这一瓶颈,学术界与前沿工程团队开始全力攻坚原生全双工音频流式大模型。这一架构不再把文本作为不可逾越的中介,而是构建统一的自回归多模态神经网络,直接在连续时域波形与声学隐表征空间中进行双向流式吞吐,从而为真正自然、低时延的实时对话奠定了全新基石。
级联流水线时延累加与副语言声学特征丢失的固有缺陷
审视传统串联语音交互架构,其瓶颈根植于离散文本的表征局限。文本是人类为了记录与传播抽象概念而发明的高度压缩的离散符号,但人类语言交流的真实信息承载量远不止于文字本身。
在真实面对面交流中,语速的骤然放缓、微弱的气息颤抖、句尾音调的微扬或下沉,往往蕴含着反问、犹豫、肯定或质疑等关键的情感与决策倾向。当系统通过传统ASR将一段充满讽刺意味的口语强制转换为平铺直叙的字面文字后,后端的语言模型即便拥有千亿参数,也只能根据冰冷的字面含义做出呆板的回答,产生不可挽回的语义偏差。
与此同时,三段级联架构在处理连续实时交互时面临着严重的排队时延。由于ASR引擎通常需要等待一个完整的语义断句单元(例如检测到200毫秒以上的静音期VAD),才敢向LLM发送完整的句子;LLM在收到第一批文字后,又需要积累若干Token才能启动TTS的流式合成。每一道工序都在人为制造缓冲阻塞,导致人机对话总是呈现出你一句、我一句的机械对讲机模式。一旦用户在中途想要打断机器的发声,级联系统需要穿透多层应用接口逐级发送取消中断,往往在用户发声数秒后机器依然在喋喋不休,彻底丧失了交互的自然流畅度。
深度残差矢量量化在微观时域窗口的高维连续特征投影
原生端到端架构的基石,是用新一代神经音频编解码器(Neural Audio Codec)取代传统的离散文字分词器。该技术的核心使命,是在极高压缩比下实现连续声学波形与离散隐空间代码的高保真双向转换。
在系统输入端,神经编解码器的编码网络通常采用多层一维因果空洞卷积(Causal Dilated Convolutions)。它以16kHz或24kHz的采样率直接摄取原始PCM波形,在数十毫秒的极短时域窗口内提取深层声学潜特征。
为了让自回归Transformer能够有效建模这些高维连续向量,系统引入了多层残差矢量量化(Residual Vector Quantization, RVQ)机制:
第一层矢量量化码本对原始连续隐向量进行粗粒度聚类,捕获最核心的音素与基础语调结构;随后,系统计算原始向量与第一层量化向量之间的量化残差,并将该残差输入第二层独立码本进行精细补偿;这一过程层层递进,直至第8层或第16层码本将高频泛音与微观环境声细节彻底保真捕捉。
通过这种级联残差设计,数万个连续采样点的庞大波形被优雅地压缩为每秒数百个离散声学Token。与传统的文本Token相比,这些声学Token不仅蕴含了完整的发音内容,更无损保留了说话人的音色指纹、情感副语言以及声场空间特征,为多模态模型进行原汁原味的声学思考提供了坚实的数据表征。
因果卷积与分块流式注意力掩码的时序解耦
在大模型内部处理这些声学Token时,架构设计必须无条件捍卫流式因果性(Causality)。
传统的Transformer注意力机制允许当前位置关注输入序列的前后所有上下文(非因果全注意力),这在处理静态离线文档时极为强大,但在实时流式传输中意味着无法计算——系统不可能在当前时刻预知用户未来一秒钟会说出什么声音。因此,原生音频模型的主干网络必须严格施加因果注意力掩码(Causal Attention Mask),确保任何一个时间步的神经元仅能感知当前及历史声学帧。
然而,纯粹的逐帧严格因果注意力会导致模型缺乏对微小局部语境的理解能力,造成音素发音畸变;而过大的双向局部窗口又会直接引入不可逆的缓冲延迟。
工程界给出的精妙平衡方案是自适应分块因果注意力(Chunk-based Streaming Attention)。系统将输入的连续声学Token流按照固定的时间步长划分为细粒度的计算块(例如每个Chunk包含80毫秒的声学数据)。在单个Chunk内部,注意力机制开放局部的双向全连接,允许音素内部与相邻声学特征充分发生自注意力融合,以保证声学表征的高保真度;而在Chunk与Chunk之间,则严格实施单向因果掩码,后置的Chunk绝不向后透视未来的未到达数据。
通过这种块内双向、块间因果的分层解耦,模型既消除了长程缓冲等待,又守住了局部声学特征的解析精度,将底层的算法计算暴露时延死死锚定在数十毫秒的安全阈值之内。
实时双讲回声抵消与毫秒级软中断自回归截断机制
在实现了单向流式输入与输出之后,迈向全双工的核心考验落在了双讲(Double-talk)与主动打断处理上。
在真正的全双工交互中,麦克风收音与扬声器放音处于毫秒级并发状态。当模型正在通过底层DAC芯片驱动扬声器向外播放回答声音的同时,环境麦克风必然会同时拾取到扬声器播放出来的自身声音,并混杂着房间的物理反射回声。如果系统缺乏极其强悍的声学回声消除(AEC),模型就会把自身刚刚说出的声音当作用户的新输入重新喂入编码器,引发灾难性的声学自激振荡与逻辑胡言乱语。
现代原生全双工引擎在声学输入的最底层,构建了深度结合物理延迟对齐与时域自适应滤波的AEC前端模块。通过将待播放音频流的数字信号作为参考信号直接输入滤波器,算法在麦克风模拟信号转为数字信号的第一时间,以亚毫秒级的精度扣除扬声器信号与房间传递函数响应,抽离出纯净的用户人声输入。
更为关键的是对用户打断意图的敏锐捕捉与快速响应。传统系统依靠文字识别后的语义分析来判断用户是否打断,往往需要等待半秒以上;而原生流式基座则在神经网络底层并联了一个轻量级的声学活动探测头(VAD & Intent Detector)。
该模块直接在声学隐表征空间中实时扫描用户声音能量与音素起振特征。一旦探针在连续30毫秒的微观窗口内捕捉到具有明确沟通意图的人声侵入,系统调度层立即向GPU推理核心发送异步软中断指令。主自回归解码流瞬间掐断后续声学Token的生成管线,清空硬件底层待播放的DMA环形缓冲区,将模型的生成上下文极速切换至倾听与状态吸收模式。
这种毫秒级的知进退、懂倾听的系统级调优,让机器彻底告别了呆板的机械轮询感,赋予了人机交互如同真实人类对话一般细腻、自然且充满呼吸感的生动体验。