大语言模型的演进范式正在经历一场深刻的底层转向。在此前相当长的一段发展周期中,整个工业界普遍将提升模型表现的希望寄托在预训练阶段的扩展定律(Scaling Laws)之上,即通过无止境地堆砌预训练参数规模与清洗海量文本语料,期望涌现出更强大的逻辑泛化能力。然而,随着全球高质量人类文本资源的逐步耗尽,以及前向预训练在算力与电力成本上的边际效益递减,单纯依靠增大参数底座换取智力跃迁的做法正逼近物理极限。
前沿研究与工业部署的目光迅速转向了测试时计算扩展(Test-Time Compute Scaling)。这一技术路径的核心逻辑在于:与其在离线阶段盲目追求一个无所不知的超庞大静态网络,不如在在线推理接收到特定复杂任务时,允许模型分配更多动态的推理算力,通过自我反思、步骤检验、多路径树状探索与回溯验证,完成从直觉式快思考向深思熟虑式慢思考的跨越。这种将算力重心由离线训练向在线推演倾斜的架构变革,不仅重塑了复杂数理逻辑与代码工程生成的上限,也对底层推理系统的显存管理和调度引擎提出了极其严酷的工程挑战。
自回归贪婪采样在复杂逻辑推演中的累积误差瓶颈
传统的Transformer自回归生成采用的是单向逐Token生成模式。在这种机制下,模型根据前文的上下文概率分布,以贪婪搜索或核采样(Top-p)的方式顺序吐出后续字符。这种前向机制在日常对话或开放式文本创作中表现轻盈流畅,但在面对需要精密长程推导的专业任务时,却暴露出致命的缺陷——单向不可逆性。
一旦自回归模型在推演链条的第3步产生了一个极其隐蔽的逻辑偏差或事实性幻觉,其注意力机制在后续的第4步、第5步中便会将这一错误前置结论作为既定事实输入。自回归生成的累积误差概率呈现指数级上升,模型不仅无法在后文自我修正前期的逻辑漏洞,反而会利用其强大的语言顺滑能力继续强行编造推论,最终得出一个荒谬却在句式上看似严丝合缝的错误答案。
为了突破这种直觉采样的局限,初期的尝试是引入多数投票机制(Self-Consistency),即针对同一提示词让模型并发采样数十条独立思考路径,通过最终答案的投票聚集来提升准确率。然而,这种朴素的整链路采样在算力利用上极其低效:一条推演了90%且完全正确的长路径,仅仅因为结尾微小的计算失误就会被全盘抛弃;同时,多条路径之间完全无法共享中间有效的推理子状态,导致显存中充斥着海量高度重复的自注意力键值缓存(KV Cache),严重拖垮了推理集群的吞吐。
过程监督奖励模型对离散推演步骤的细粒度打分机制
测试时计算扩展实现精细控制的关键分水岭,在于从整篇结果监督(Outcome-supervised Reward Models, ORM)转向细粒度的过程监督(Process-supervised Reward Models, PRM)。
结果监督模型仅仅充当一个事后的打分裁判,只有当大模型完整输出长达数千字的全部推导并得出最终结论时,裁判模型才给出一个全局奖励标量(例如0或1)。这种稀疏的反馈信号对于漫长的思考链条几乎没有定位指导价值,它无法向系统指出究竟是哪一个关键推演节点触发了逻辑偏航。
过程监督奖励模型则对推演过程实施了离散化的步进解构。在系统架构中,大模型的思考链被明确分割为多个具有独立因果含义的推演片段(Step-level Tokens)。每当主思考模型完成一个局部的逻辑推导步,PRM评分网络便立刻介入,对当前局部状态的正确性、严谨度以及通向终局目标的置信度给出纳秒级的多维打分。
在具体工程实现中,高质量PRM通常采用双头判别网络结构:一个分类头评估该逻辑步骤在语义层面的严密性,另一个回归头则预测当前中间状态的势能价值。这种密集的过程级反馈构成了后续搜索算法赖以运转的价值罗盘,使得系统具备了在推导途中随时判定对错、及时止损的能力。
蒙特卡洛树搜索在解空间探索与动态分支剪枝中的工程实现
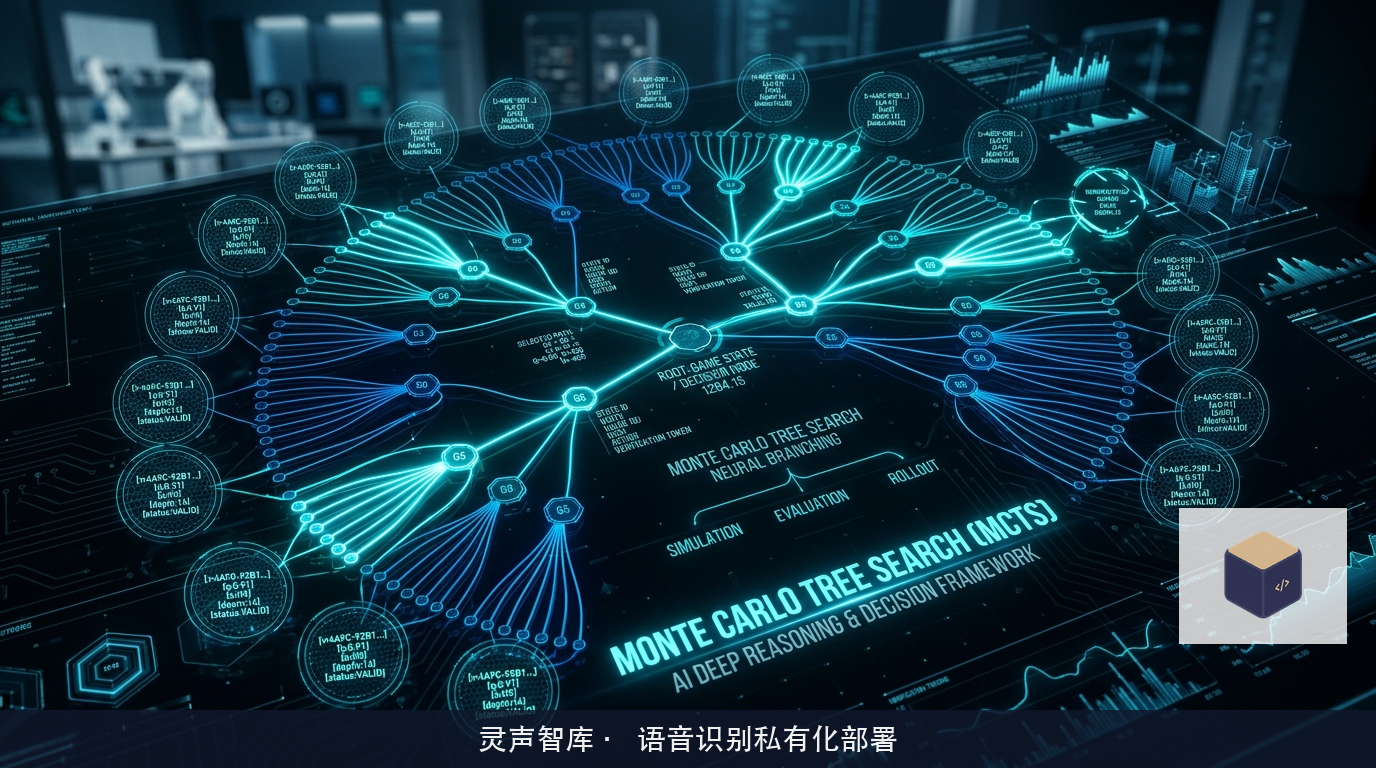
依托PRM提供的细粒度奖励打分,推理引擎得以将原本单向线性的生成过程重构为有向树状图探索,而蒙特卡洛树搜索(MCTS)则是遍历这一庞大解空间的经典算法。
在MCTS推理调度器中,生成流程被划分为选择、扩展、评估与回溯四个循环阶段:
当输入问题被解析为根节点后,系统利用改进的上置信界算法(PUCT)在现存的思考树中向下遍历,平衡对高价值节点的深度利用(Exploitation)与对低访问频次节点的广度探索(Exploration);到达叶子节点后,主推理模型并发生成K个候选候选后续步骤;PRM网络随即对这K个候选分支进行打分评估;评估结果沿着树结构逆向回溯,更新整条祖先路径的访问计数值与平均价值评分。
在这一过程中,启发式剪枝策略(Heuristic Pruning)直接决定了搜索的生死。解空间的宽度和深度呈现组合爆炸趋势,如果允许低置信度的分支无节制生长,系统显存将在数秒之内被海量的探索路径彻底挤爆。工程团队在此构建了严格的动态截断防线:一旦某个推演节点的PRM置信度跌破设定的动态阈值,或者连续两步未产生正向信息增益,调度器直接斩断该子树的后续展开,将其标记为不可行路径,并立即回收该路径占据的计算流。
与此同时,为了避免陷入局部极值陷阱,算法引入了虚拟损失机制(Virtual Loss)。当多个并发推理工作线程同时访问同一高分节点时,调度器会人为在短时间内下调该节点的表观评分,迫使其他并发线程转向探索次优但潜在价值巨大的备选分支,从而保证了思考路径的多样性。
异构推理集群中测试时算力弹性扩展与显存拓扑平衡
当单次用户请求的推理逻辑从单向流转变为生长出一棵包含数百个节点的动态思考树时,底层的系统工程架构遭遇了前所未有的冲击。
首当其冲的是键值缓存(KV Cache)的管理混乱。在单向自回归中,KV Cache的增长是连续且线性的;而在MCTS搜索树中,多个不同的推演分支共享同一个上游树干前缀。如果为每个分支独立开辟完整的显存空间,重复前缀造成的显存浪费将高达80%以上。为此,前沿推理引擎全面重构了底层的显存分配器,开发出树状分支感知的统一页表内存管理方案(Tree-structured PagedAttention)。
系统将KV Cache以微小的数据块(Block)为单位分散存放在全局虚拟显存池中,各条探索分支在底层共享完全相同的父节点页表指针,仅在发生分叉写入新数据时触发写时复制(Copy-on-Write)。这种紧凑的拓扑共享使得单个GPU节点能够同时挂载深度达数十层、分支上百条的庞大搜索树,将有效显存利用率拉升至物理极限。
另一个工程痛点是计算强度的剧烈抖动。不同的推演分支在何时触发剪枝、何时需要扩展展开具有高度的不确定性。这导致GPU的计算负载不再呈现平稳的批处理特征,而是表现出微秒级的脉冲式波动。为了抚平这一毛刺,集群调度层设计了异步计算流排队引擎,将树搜索过程中的主模型自回归生成与PRM评分判定解耦到不同的计算流乃至异构加速卡上执行。
通过将算力消耗精细化地分配至真正困难、高价值的逻辑决策节点上,这种慢思考架构让大模型在不膨胀静态物理参数的前提下,展现出了惊人的复杂推理纵深。伴随底层内存虚拟化与分支剪枝工程的持续精进,测试时动态算力扩展正在为下一代智能系统构筑起坚实可靠的逻辑基石。