伴随大模型基础架构由稠密全激活网络向稀疏混合专家网络(Mixture of Experts, MoE)的大规模迁移,分布式计算的性能瓶颈正在经历一场前所未有的重心位移。在传统的稠密模型中,千亿参数的推理与训练主要受限于单卡矩阵乘法(GEMM)的纯浮点算力密度以及跨层张量并行(Tensor Parallelism)的显存带宽;而在高稀疏度的MoE架构下,模型虽然在每次前向传播中仅激活少数专家节点,但为了在多机分布式集群中容纳数十乃至数百个独立专家,整个系统必须依赖高频跨节点的集合通信来分发和汇聚Token。
在政企物理专网或由多代次算力卡混编构成的复杂机房环境中,这种架构特性往往会瞬间引爆严峻的通信墙危机。实测表明,未经深度通信优化的MoE集群,其GPU计算核心在大量时间里处于空载等待网络数据包的状态,集群算力利用率(MFU)甚至跌落至不足20%。如何打破网络接口卡(NIC)与张量加速器之间的壁垒,实现零拷贝RDMA数据流转与算子级的计算通信深度重叠,成为了私有化高密智算中心必须攻克的核心技术战役。
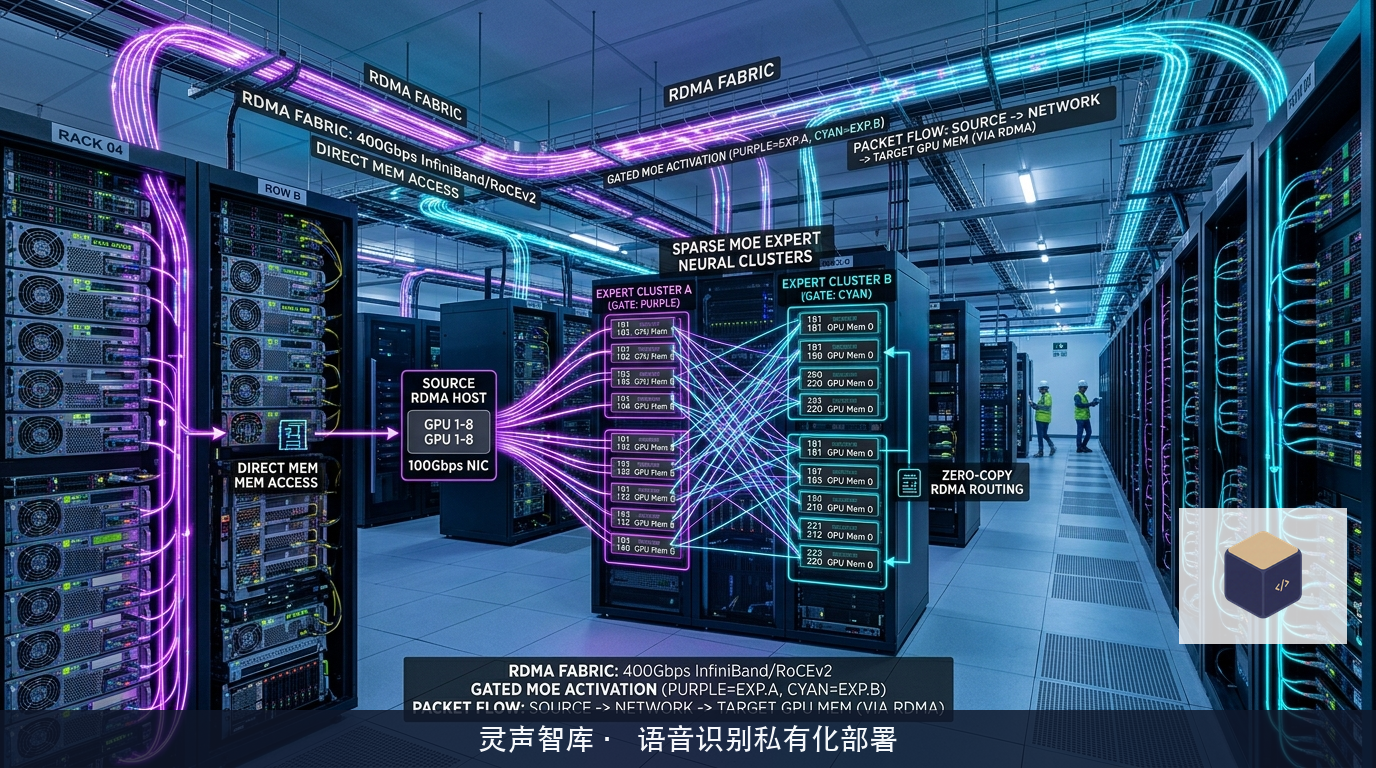
跨节点集合通信在分布式MoE推理中的带宽吞吐墙
剖析MoE推理的底层时序,其通信瓶颈主要集中在专家并行(Expert Parallelism)所引入的All-to-All集合通信原语之上。
在标准的MoE层执行流程中,输入的词元序列在经过自注意力计算后,由门控路由网络(Gating Router)计算出每个Token与全集群所有候选专家之间的亲和度权重,并选出Top-K个目标专家;由于不同的专家权重被物理分散存放在不同宿主机、不同PCIe总线插槽的GPU显存中,系统必须发起第一轮跨机All-to-All调度,将分散在各个GPU上的Token按照目标专家归属重新打包,跨越物理网络精准投递至对应节点;在专家层完成局部矩阵乘法计算后,系统又必须立即触发第二轮反向All-to-All通信,将计算产出的隐状态结果重新汇聚回发起请求的源GPU。
这两轮高频爆发的集合通信对集群网络构成了毁灭性的突发流量冲击。在常见的双汇聚交换机网络拓扑中,如果数十张网卡在同一微秒级窗口内并发向相同的目标节点倾泻数据包,交换机缓冲队列会瞬间被填满,引发可怕的微突发(Micro-burst)拥塞。
更为雪上加霜的是传统TCP/IP网络协议栈的沉重开销。在标准操作系统网络栈中,数据从GPU显存向网卡流转需要经过多次主机内存拷贝(GPU -> Host Pin-Memory -> Socket Buffer),伴随着频繁的内核态上下文切换与软中断处理,端到端延迟直接被拉升至毫秒级。在单步前向推理耗时本就需要压制在数十毫秒以内的严苛场景下,通信开销直接吞噬了所有的稀疏计算红利。
计算与通信双缓冲CUDA流异步重叠中的微块流水线设计
消除通信暴露时间的最有效手段,是在底层执行引擎中构建完美的计算通信异步重叠(Overlap)。
在传统的串行调度中,GPU的核心执行流水线是僵化的:通信开始,计算核心完全熄火;通信完毕,计算核心才被点火唤醒。而异步重叠的核心哲学在于,利用现代加速卡独立的数据传输引擎(Copy Engine)与计算调度流(Compute Stream),将二者的执行时序在时间轴上实现物理交叠。
为了达成这一目标,工程团队引入了细粒度微块双缓冲流水线(Micro-batch Double Buffering):
系统将当前批次的Token数据流沿着时间维度切分为微块A与微块B。当微块A在主计算流中执行注意力层或密集前馈层计算时,辅助通信流通过非阻塞异步原语,提前启动上一周期已经路由完成的微块B的数据跨机分发;当微块A计算完毕进入通信等待时,微块B的网络数据已经通过后台DMA悄然就绪,主计算流无需任何暂停停滞,立即无缝切入微块B的专家计算。
在真实集群落地这一流水线时,最大的暗坑在于隐式依赖同步。在许多高层深度学习框架中,跨流事件同步(CUDA Event Record & Wait)如果使用不当,会触发全局驱动级别的CPU忙轮询等待,导致原本并发的两个流发生隐式锁死。
稳健的底层做法是基于裸机C++重构自定义通信算子,彻底绕过框架的高层抽象封装,直接利用GPU底层的硬件信号量原语(Hardware Semaphore)在显卡固件层编排事件触发依赖。通过严格剥离任何宿主机CPU的主动介入,微块流水线能够将跨节点的All-to-All通信时间近乎100%隐藏在密集的矩阵乘法阴影之下,使整体推理吞吐一举提升2倍以上。
动态长尾Token倾斜防范与弹性共享显存缓冲池
除了网络带宽的绝对限制,真实业务请求中Token路由的非均匀分布也是导致集群瘫痪的高发诱因。
在理论推导中,算法设计者通常假定所有专家被调用的概率是大致均等的。然而,在真实生产场景中,自然语言输入的数据分布往往呈现出极度陡峭的长尾偏斜。负责处理高频语法连词或通用句式模式的少数“通用专家”会被疯狂调用,而承载特定冷门知识或冷门专业术语的“长尾专家”却门可罗雀。
这种偏斜一旦投射到物理GPU节点上,就会引发致命的负载失衡:
承载热门专家的GPU节点其输入缓冲区瞬间被海量Token撑爆,显存面临严重的OOM(Out of Memory)溢出风险,计算单元超负荷运转;与此同时,承载冷门专家的相邻节点却因为无事可做而陷入漫长的空等。由于分布式All-to-All通信必须等待所有节点全部结算完毕才能完成同步屏障,最慢的过载节点直接将整座集群的推理时钟拖入泥潭。
工程上彻底杜绝这一现象的方案,是建立基于容量因子约束的弹性共享显存缓冲池机制。系统在物理显存层为每个专家划定严格的最大处理上限(Expert Capacity),一旦某个专家在当前周期的分配Token数触及容量红线,多余的溢出Token并不直接简单丢弃(避免精度坍塌),而是通过旁路动态路由层转移至预先开辟的全局弹性备用槽位中。
备用槽位通过低延迟虚拟显存页表映射在集群中负载最低的空闲GPU上,利用空闲算力对溢出数据进行低优先级代偿计算。通过这种动态流量整形与显存兜底,系统彻底熨平了瞬时热点流量对单卡的冲击,保障了集群时序的高度一致性。
专网RoCEv2自适应路由与微秒级PFC死锁避免机制
在算子层与调度层优化完毕后,底层物理网络的基础设施调优构成了高吞吐编排的最后一道防线。
为了实现真正的零拷贝数据穿透,专网集群全面启用了基于聚合以太网的RDMA协议(RoCEv2)。通过在操作系统中预先注册并锁定固定GPU物理显存区域,网卡可以通过GPUDirect RDMA技术绕过宿主机CPU与系统内存,直接发起跨机器的GPU显存到GPU显存的端到端直接内存写入。
然而,RoCEv2作为一种构建于无连接UDP之上的无损网络协议,极其依赖交换机底层的优先级流量控制(PFC, Priority Flow Control)机制来保障不丢包。在全互联All-to-All高并发流量冲击下,极其容易在网状网络中诱发可怕的PFC死锁风暴(Deadlock):多个交换机端口互相向对端发送Pause暂停帧,导致整个机房的网络通信瞬时陷入彻底冻结。
攻克这一硬件级顽疾需要在交换机与网卡驱动层推行全方位的自适应拥塞控制与动态路由协同:
首先,在物理交换机上部署基于数据包真实排队长度的显式拥塞通知(ECN)与动态阈值WRED标记算法,当端口队列深度触碰警戒线时,网卡硬件在微秒级时间内感知并精准调降发送窗口,平滑化解微突发拥塞,避免触发粗暴的全局PFC暂停;其次,在多路径网络架构中摒弃传统的静态ECMP哈希分流,全面激活基于数据包粒度动态感知链路负载的自适应路由(Adaptive Routing),将原本容易在单条交换机主干上发生撞车的All-to-All数据包动态打散分流至全网所有可用物理链路。
正是这种从硬件微架构、底层网络协议栈、显存内存虚拟化到上层算子流水线全方位的系统级深度打磨,最终化解了大规模稀疏架构在现实专网中的通信围城,让千亿参数的智能网络在私有算力中枢中释放出应有的澎湃动能。