【全球计算前沿讯】在刚刚举办的 GTC 2026 全球企业技术论坛上,英伟达(NVIDIA)计算系统与 AI 基础设施部门正式揭晓了其专为超大规模企业专网打造的语音大模型全栈加速套件——NeMo-Voice 3.0。结合英伟达最新商用化的 Blackwell 架构 GPU 集群,NeMo-Voice 3.0 展示了前所未有的声学密集型计算吞吐能力:在标准 4U 机架内,单台搭载 8 块 Blackwell Ultra 加速卡的计算节点,能够同时支撑高达 1200 路全双工、低延迟语音识别与流式语义理解的实时并发处理。
相较于上一代 Hopper 架构平台,新套件将企业内部语音推理的综合每通道算力功耗降低了 64%,每秒音频帧的端到端吞吐效率跃升了 3.2 倍。这一测试数据的公布,在电信运营商、超大型国有银行以及智慧政务云平台等重载语音业务领域引发了技术决策层的极大关注。
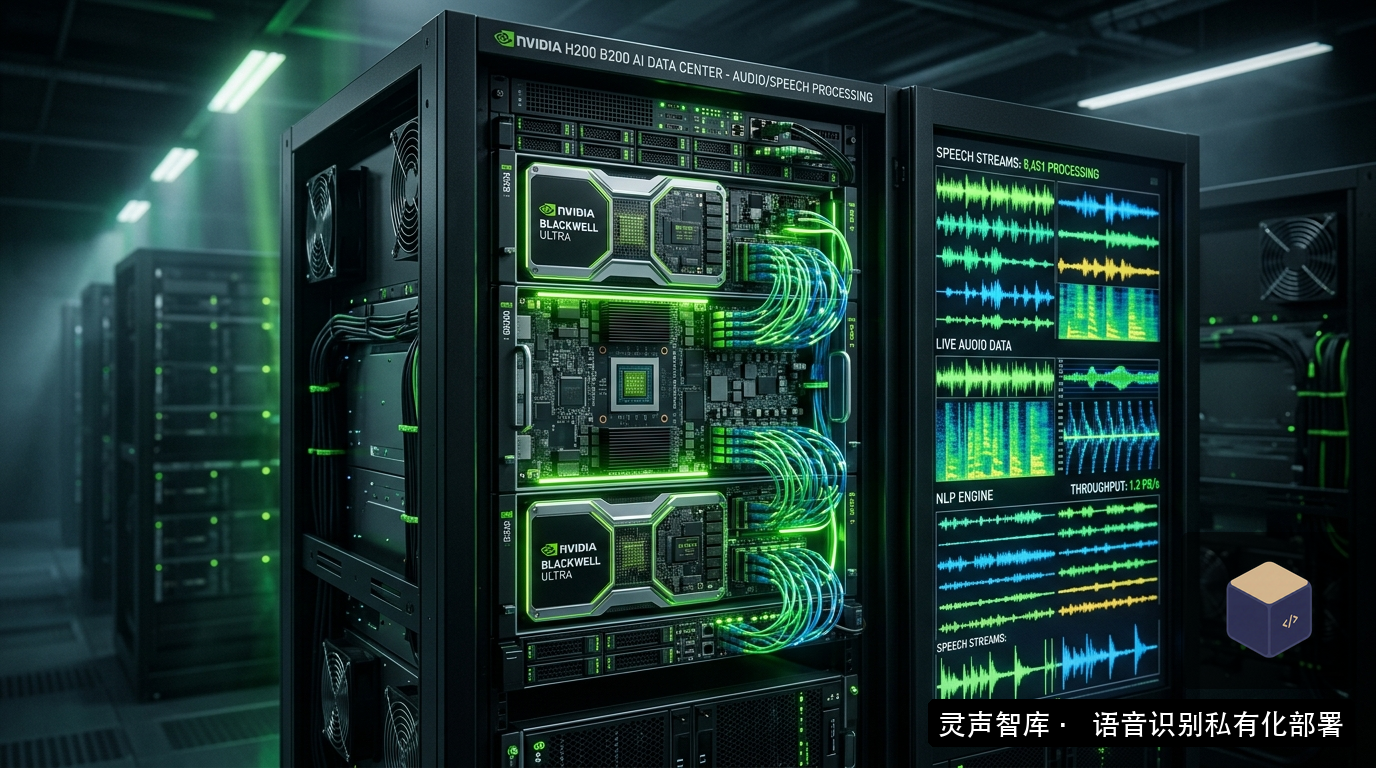
一、 Blackwell 架构重塑语音计算的四大底层支柱
传统语音大模型在进行高并发流式推理时,往往受制于显存带宽(Memory Bound)和频繁的小包数据搬运开销,难以充分吃满 GPU 的稠密张量算力。英伟达工程师通过软硬件一体化重构,在 NeMo-Voice 3.0 中实现了多项革命性技术融合:
1. 第二代 Transformer 引擎与 FP4 微缩浮点原生支持
NeMo-Voice 3.0 完整打通了从 FP16、FP8 到 FP4 的全精度自适应量化推理管线。在对声学特征提取层保持 FP8 高保真度的同时,自注意力与前馈网络全面采用 Blackwell 原生硬件支持的 FP4 计算格式。配合硬件级的动态缩放因子(Scaling Factor),不仅模型权重显存占用降低了一半以上,更使得每瓦特能耗下的算力释放达到了空前水平。
2. 5 代 NVLink 带来的近零延迟声学缓存同步
当需要处理跨多个通道的复杂多说话人会议时,传统的 PCIe 总线极易发生数据拥塞。Blackwell 节点内配备的双向 1.8TB/s NVLink 5 互联技术,使得 8 张 GPU 的显存能够被虚拟化为一个统一的超大共享声学特征池。不同坐席或通话的声学隐状态可以在卡间进行纳秒级交换,彻底排除了卡间通信等待引起的音频卡顿与转写掉字。
3. 基于 CUDA 13 的流式内核算子全融合(Kernel Fusion)
在典型的自动语音识别(ASR)流水线中,通常涉及傅里叶变换、梅尔滤波器组映射、卷积归一化及注意力矩阵运算等数十个独立算子。NeMo-Voice 3.0 利用最新的编译器优化技术,将前端声学信号预处理与底层 Transformer 编码算子融合成单一的常驻显存内核(Persistent Kernel),排除了上下文切换导致的 CPU-GPU 交互延迟,端到端延迟死死控制在 35ms 阈值以内。
4. 企业级专网自愈与热迁移容灾机制
针对金融级交易系统对“业务零中断”的严苛要求,NeMo-Voice 3.0 引入了微服务级的动态健康探测与会话状态实时镜像机制。一旦某块加速卡出现突发性硬件故障,正在进行的数百路通话流状态可以在 10 毫秒内透明迁移至备用核心,上层呼叫中心坐席与客户端毫无感知。
二、 架构师与系统决策者的热烈讨论
NeMo-Voice 3.0 的发布,重新引发了技术圈关于“云端租用算力”与“本地自建高密算力”在全生命周期成本(TCO)上的深度复盘:
- 某全国性股份制银行总行系统架构师测算指出:“大型商业银行的智能客服中心与全国网点柜面每天产生数千万分钟的业务录音。过去使用传统服务器集群支撑上千路并发需要部署数十台设备,机房机柜空间、电力散热以及网络交换设备都是沉重的包袱。英伟达展示的高密单机并发方案,意味着原本需要三个标准机柜才能承载的并发量,现在单台 4U 节点即可消化,仅机房电费与空间租金一年就能节省上百万元。”
- 某省级大数据中心基础架构负责人表示:“公有云厂商按秒计费的语音大模型 API 看似初期门槛很低,但一旦业务规模扩大,长期的租用成本将呈指数级失控。更为关键的是,政务内网对于敏感公民数据的物理隔离要求极其刚性。在自建机房内采用先进的高密推理架构进行固化投资,不仅资产自主可控,长远来看更是最具经济性的技术决策。”
- 某大型智能座舱与车载语音通信技术专家提到:“随着多模态智能体向各类工业控制台和应急指挥车渗透,对边缘车载机架的体积与散热限制极高。高能效比的端侧与本地化语音计算套件,正是推动高端制造业实现‘脱机实时感知’的核心驱动力。”
三、 行业洞察:算力红利加速推动语音智能化回归本地
回顾人工智能产业的演进路径,算力基础设施的突破往往直接重塑应用架构的形态。英伟达 Blackwell 架构与 NeMo-Voice 3.0 的结合,释放出了一个明确的行业信号:超大规模语音大模型已经不再局限于少数头部互联网公司的云端实验室,而是具备了规模化下沉至企业本地机房的硬件可行性与商业合理性。
在合规要求日趋严格、企业对数据资产自主权意识觉醒的宏观背景下,如何充分消化前沿算力红利,将高吞吐、高精度的智能语音能力牢牢构筑在企业内部坚固的防火墙之内,正在成为各行各业 IT 与数字化决策者的共同必修课。