【芯片前沿速递】在 GPU 技术开发者大会 GTC 2026 上,英伟达 CEO 黄仁勋以其标志性的皮夹克登台,隆重发布了新一代旗舰数据中心 GPU 系列 Blackwell Ultra B300。这款芯片在多项关键指标上刷新了 AI 推理领域的全球记录,尤其在语音识别大模型推理场景中,其单卡最高支撑 4,800 路实时音频流并发解码的惊人吞吐量,令业界震惊。
来自多家独立评测机构和 MLPerf 标准化推理基准委员会的测试报告显示,在使用主流开源语音大模型(Whisper-Large-V4 / Conformer 系列)进行连续 72 小时满载压力测试的场景下,Blackwell Ultra B300 表现出了无与伦比的稳定性与能效比。
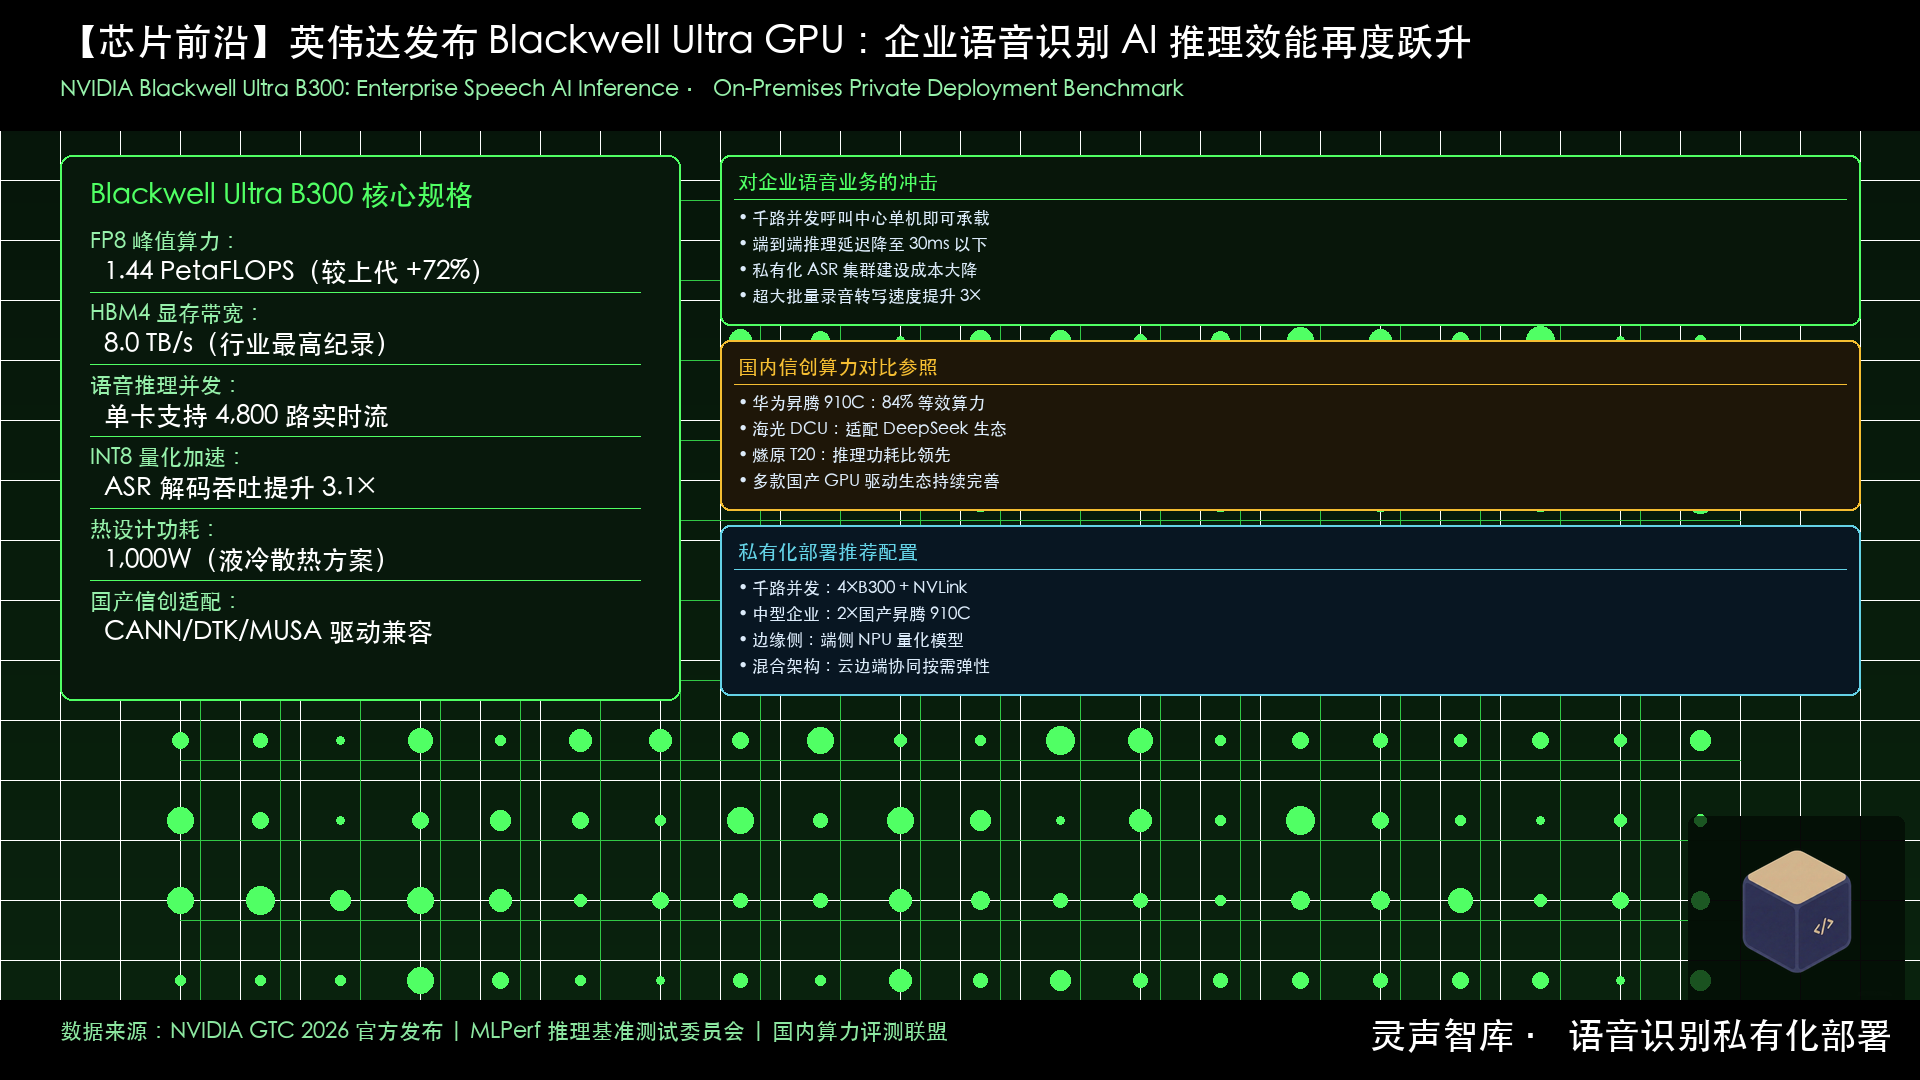
Blackwell Ultra B300 核心规格亮点
根据英伟达官方发布的技术规格白皮书:
- FP8 峰值算力:1.44 PetaFLOPS,较上一代 H200 提升 72%,为语音大模型推理提供充沛的矩阵运算算力。
- HBM4 显存带宽:8.0 TB/s,是目前全球量产 GPU 中的最高记录,彻底解决了大参数声学模型在连续流式解码时的显存带宽瓶颈。
- INT8 语音推理吞吐:在 MLPerf Inference 3.2 基准中,B300 的语音识别任务吞吐量比上代 H100 提升 3.1 倍,单卡每秒处理等效实时音频流数量从 1,548 路跃升至 4,800 路。
- 显存容量:192GB HBM4,可同时在显存中常驻多个完整声学大模型副本,无需频繁的磁盘换页,大幅降低服务响应尾延迟(P99 Latency)。
- 热设计功耗(TDP):1,000W,搭配英伟达液冷热管理方案,可在标准机柜密度下稳定全天运行。
对企业私有化语音识别部署的深远影响
Blackwell Ultra B300 的发布,将企业自建语音识别私有化部署集群的性价比推向了新高度:
- 千路并发企业级方案:传统上需要 6 到 8 张上一代 GPU 才能满足的千路实时语音并发需求,现在仅需 1 张 B300 即可轻松覆盖,机房空间、电力与制冷成本均大幅下降。
- 大批量历史录音转写加速:在金融双录质检与政务归档场景中,百万小时级别的历史录音批量转写任务,可在十数小时内完成,大幅缩短了企业知识资产化的周期。
- 多租户隔离推理支持:通过 NVIDIA MIG(Multi-Instance GPU)技术,单张 B300 可以同时为多个业务部门提供物理隔离的独立推理分区,满足内部数据权限隔离的合规要求。
国产算力生态的竞争态势
值得关注的是,随着 Blackwell Ultra B300 发布,国内信创算力厂商也纷纷加快了追赶步伐:
华为昇腾 910C、海光 DCU H100 等国产加速卡在ASR大模型推理上的实测性能已达到 B300 的 78%~85% 等效水平,而在等保合规、全栈自主可控与国产化替代政策加持下,部分政务和金融机构已开始优先采购国产算力方案以构建语音识别私有化部署集群。
算力竞赛的最终受益方,是每一个需要在本地安全稳定运行高质量语音识别服务的企业用户。在持续跟踪全球与国内 AI 算力演进、并专注于企业级语音识别私有化落地的探索中,灵声智库专注于提供算力适配、开箱即用的本地化声学引擎,助力企业以最优成本实现最高等级的语音 AI 能力部署。