【硅谷科技快讯】当地时间 8 月 25 日,OpenAI 官方技术团队正式向全球开发者推送了 Realtime API 与原生音频大模型的重大架构升级。本次更新重点攻克了全双工实时多模态交互中的延迟瓶颈与流式 Token 编解码机制,将双向交互的首字时延(TTFT)大幅压缩至 120 毫秒以内。与此同时,官方首次披露了针对小型化设备的参数量化与蒸馏指南,引发了全球 AI 开发者社区、云原生架构师以及企业安全高管的广泛热议。
在公开的技术演示中,新版模型展现了极其惊艳的原生声学感知能力:系统不仅能毫秒级捕捉人类口述中的细微呼吸停顿、情绪起伏与轻度抢话,更能在被用户打断时瞬间切换为倾听状态。然而,随着该技术在企业级业务场景中的深入测评,公有云高昂的 Token 调用开销、偶发的跨国网络丢包卡顿,以及敏感会议音频出境的监管合规难题,正促使越来越多的企业加速探讨端侧轻量化推理与离线语音识别的落地路径。
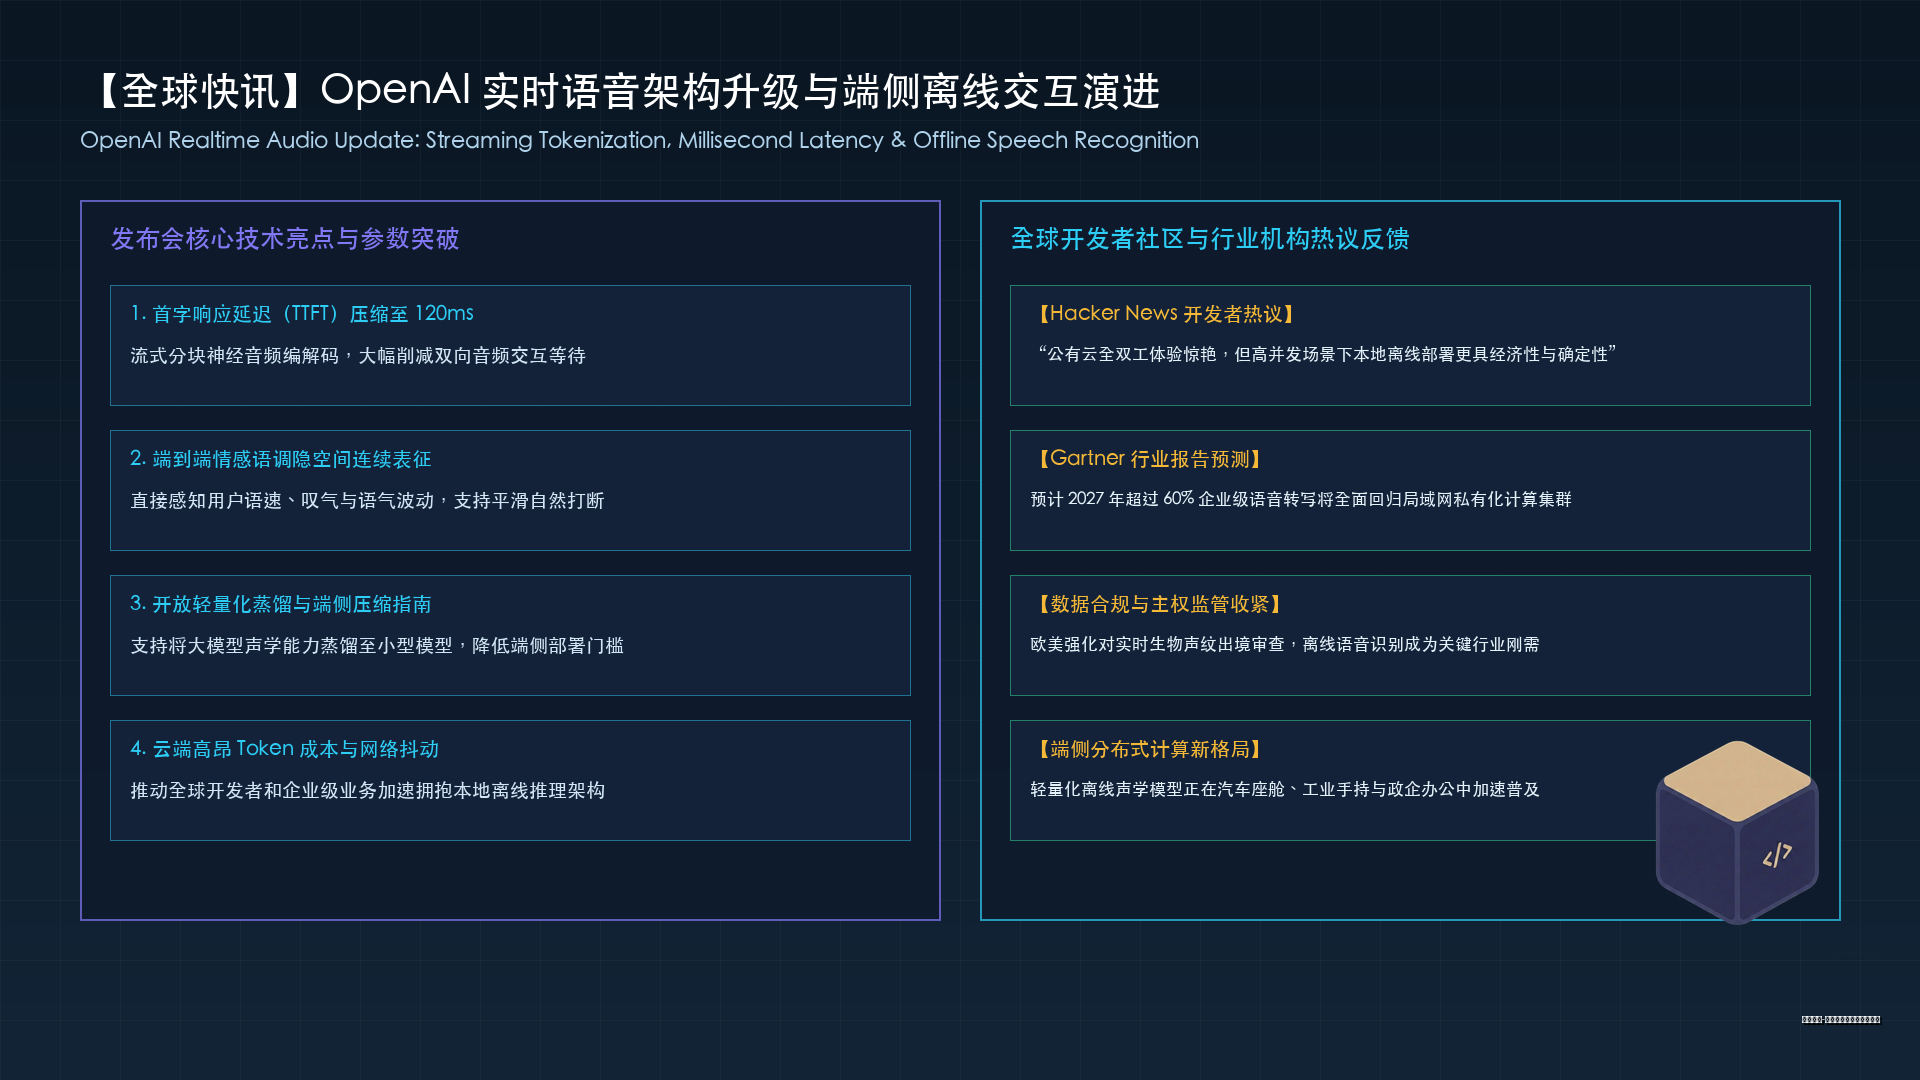
发布会三大核心技术突破点
根据 OpenAI 官方发布的技术白皮书与更新日志,本次升级的核心看点主要集中在以下三个维度:
- 毫秒级离散神经音频编解码:新架构采用了更高压缩比的流式神经音频编解码器(Audio Tokenizer),在 2.4kbps 的超低码率下实现了 24kHz 高保真声学表征,将传统音频流传输的序列长度缩短了 65% 以上。
- 隐空间端到端声学对齐:模型彻底颠覆了“ASR 转写文本 -> LLM 文本生成 -> TTS 语音合成”的传统串行模式,直接在隐空间内完成声音信号的端到端理解与生成,消除了多层转译带来的机械感与累积时延。
- 开放端侧轻量化蒸馏指南:针对算力与网络受限的应用场景,官方提供了一套完整的模型压缩框架,支持开发者通过知识蒸馏将大模型的声学能力迁移至轻量级模型中,为各类硬件终端的脱网运行提供了坚实的技术依据。
开发者社区与业界专家深度反响
本次技术更新在 Hacker News、GitHub 及 X(原 Twitter)等开发者社区迅速登顶热搜榜单。多位资深架构师与 AI 行业研究员发表了深度测评观点:
- 开源社区资深开发者 Alex Rivera 表示:“OpenAI 展现了端到端全双工交互的惊艳上限,但每分钟高达数美分的 API 调用成本,对于需要 24 小时全天候吞吐海量录音的企业级呼叫中心或工业监控场景而言是一笔沉重负担。通过轻量化模型实现 语音识别私有化部署,在本地算力上实现高吞吐运行,正成为极具性价比的工程解法。”
- 国际信息安全专家 Elena Vance 指出:“欧美密集落地的 AI 数据安全监管与隐私合规政策,明确限制了未脱敏生物声纹数据的跨境上传。对于涉及金融交易、研发机密与医疗诊断的核心音频,具备物理隔离特性的离线语音识别架构是企业规避数据外泄风险的必然选择。”
行业趋势透视:从公有云狂热到端侧与私有化落地
OpenAI 的这次重大升级不仅确立了原生全双工语音交互的行业新标杆,更清晰地折射出整个 AI 赛道正在发生的理性转向:云端基础大模型负责探索能力边界与复杂推理,而高频、实时、涉及核心隐私的语音感知与转录任务,则加速向本地服务器与边缘终端回流。
在关注前沿大模型演进与企业级落地融合的浪潮中,灵声智库专注于打造低时延、高精准的离线声学底座,持续追踪前沿技术动态并为行业提供自主可控的本地化解决方案。