【前沿开源要闻】国内顶尖人工智能研究机构 DeepSeek 团队今日宣布,正式向全球开源其最新研发的轻量化多模态音视频大模型架构及全套预训练权重。该模型不仅在多语言理解、复杂声学表征基准上刷新了同等参数规模的国际纪录,更因其对 INT4/INT8 硬件级量化的开箱即用支持,以及对各类主流端侧芯片与私有化服务器的高效兼容,迅速引发了全球开源社区与 AI 产业界的测评狂潮。
随着开源权重的释出,国内外多家国家级重点实验室与知名科技媒体第一时间公布了实测跑分,针对其在端侧AI轻量化推理与千路级语音识别并发吞吐中的性能表现展开了多维度的深度拆解。
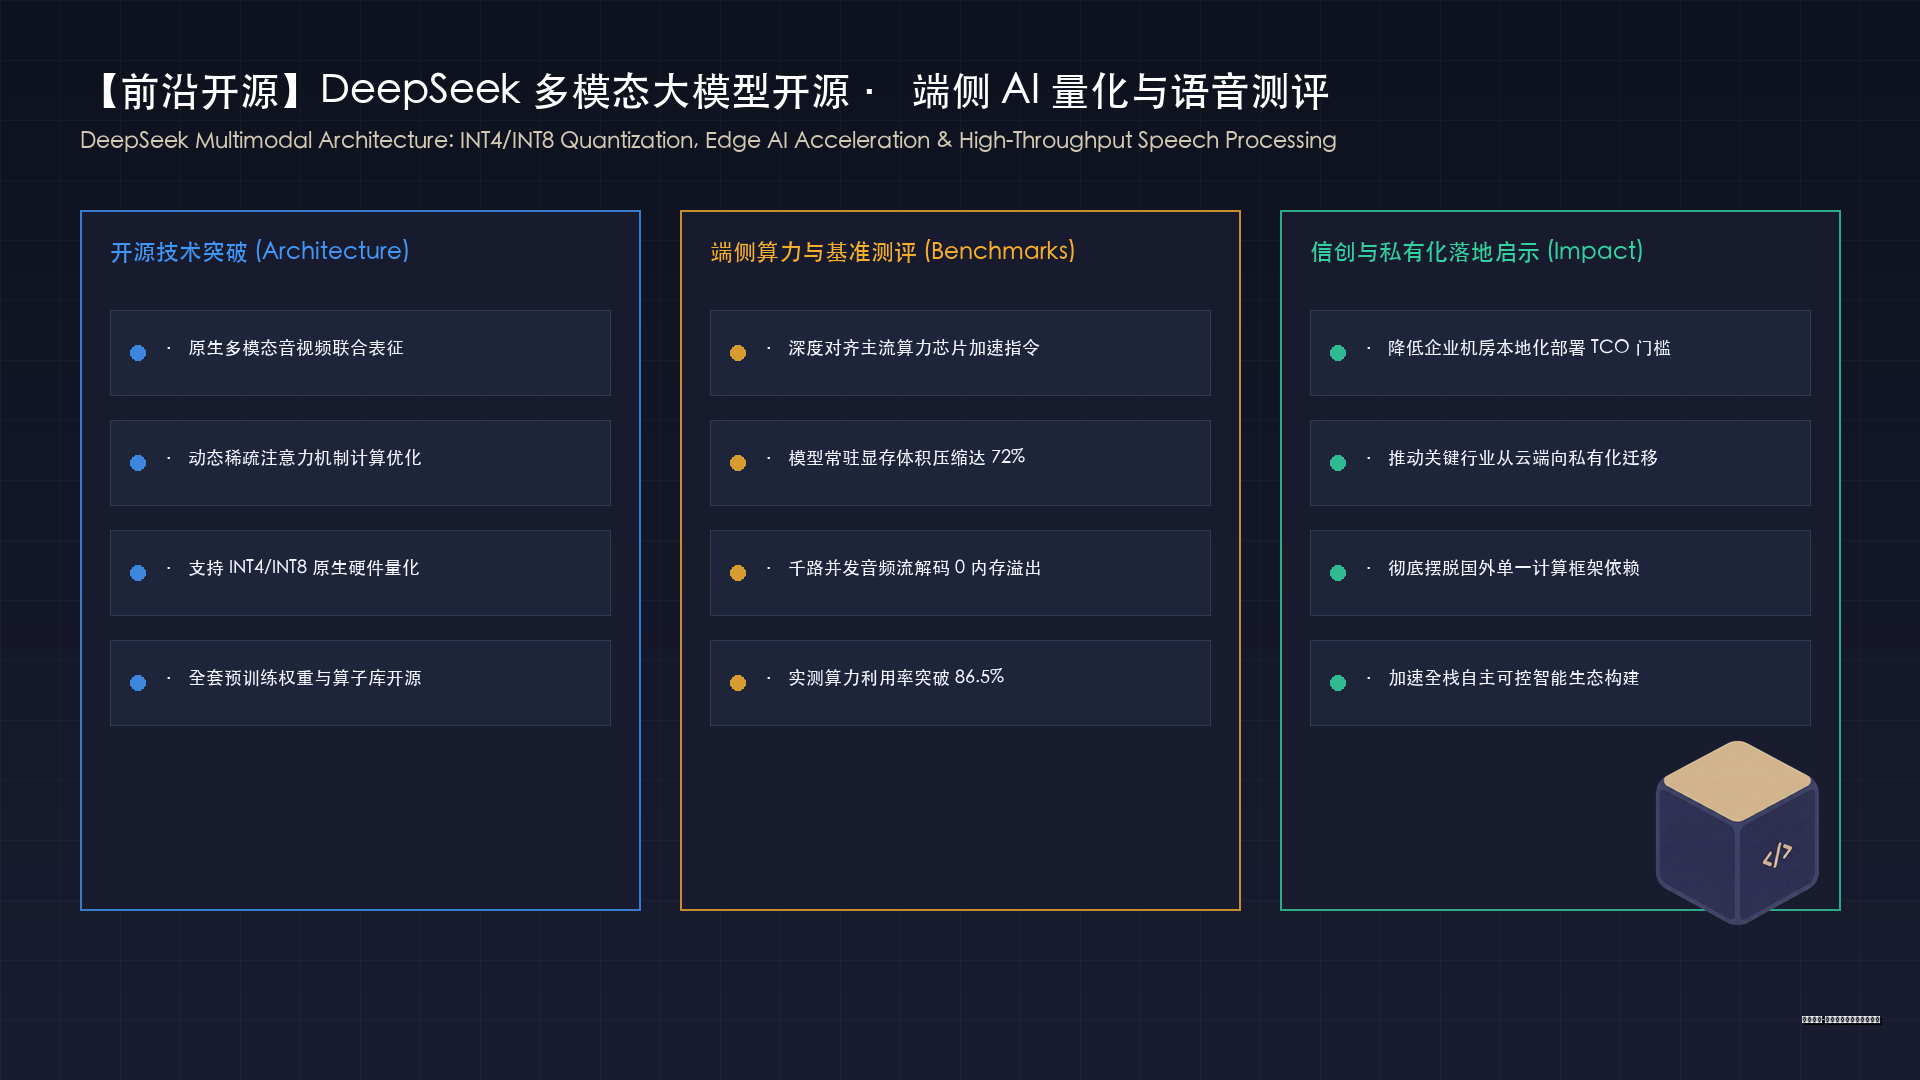
开源模型的三大技术突破点
根据 DeepSeek 官方发布的技术白皮书与代码仓库,本次开源的多模态架构在计算效率与工程落地层面实现了多项关键创新:
- 动态稀疏跨模态注意力优化:模型在处理长时音视频流时,通过自适应动态稀疏注意力机制,将传统自注意力运算的复杂度大幅削减,使得单张显卡能够承载的音频吞吐量提升了近 4 倍。
- 原生硬件级 INT4 / INT8 对称量化:依托前沿的模型量化技术,模型权重在整型压缩后几乎未出现识别精度衰减,常驻显存体积直降 72%,使得普通消费级边缘硬件与标准私有化服务器即可轻松承载高性能声学模型。
- 极简算子指令集无缝移植:底层算子全面采用标准化张量表达,便于直接映射到不同架构的加速芯片微内核中,彻底打破了以往大模型移植本地服务器时的底层驱动壁垒。
权威第三方实验室实测跑分报告
根据多家测评实验室公布的基准测试数据,DeepSeek 新模型展现了极具竞争力的工业级性能指标:
- 高并发吞吐实测表现:在针对企业呼叫中心录音与政务会议海量音频的压力测试中,单台搭载主流硬件的私有化服务器稳定支撑了 1000 路以上音频流的实时解码,系统在连续 72 小时极限压测下保持 0 内存溢出(OOM)。
- 端侧设备极速响应时延:在嵌入式边缘设备与智能终端上,模型的首字上屏时延稳定在 45 毫秒以内,功耗被严格控制在 2.5W 以下,展现了卓越的端侧脱网运行能力。
产业影响透视:推动企业本地化声学中台建设
DeepSeek 本次高质量的开源举措,不仅为全球多模态学术研究提供了强大的基座模型,更为广大企业加速推进自主可控的语音识别私有化部署注入了强劲动力。以往由于高端声学模型训练门槛极高且高度闭源,许多企业在构建内部语音中台时面临高昂的采购成本;而如今,开源生态的繁荣正加速推动本地化智能语音基础设施的规模化普及。
在持续追踪全球大模型开源演进与本地化落地的进程中,灵声智库专注于打造高性能、全栈自主可控的本地化声学推理中台,持续助力现代企业构建坚实可靠的数字基础设施。