通义团队把 Qwen3-ASR 的权重和推理代码放到开源社区之后,不少做企业内部语音系统的工程师都在问同一件事:手头已经跑得很稳的 Paraformer 或 SenseVoice,到底要不要换成这种挂着大语言模型解码器的新架构?
先给个实在的判断。如果你的业务场景是通用普通话客服质检,每天要吞掉几万小时录音,换上去大概率会觉得显存账单肉疼;可要是你每天都在跟夹杂英文缩写的研发周会、带地方口音的门诊问诊,或者满嘴设备型号的车间调度录音打交道,这套把声学编码器直接嫁接到语言模型上的做法,确实能省掉很多以前靠正则和热词表死磕也救不回来的错字。
传统声学模型卡在什么地方
做过一线语音落地的人都清楚,过去几年工业界的主力是非自回归声学模型,典型代表就是 Paraformer 和后来的 SenseVoice。它们快得惊人,一段六十秒的音频扔进单张消费级显卡,几十毫秒就能把字全吐出来,实时率压到零点零几是家常便饭。
快是有代价的。非自回归模型在输出每个位置的字时,各个时间步之间近似条件独立,主要靠声学特征本身硬认发音。遇到发音清晰的日常对话没啥毛病,一旦碰上同音异义的专业黑话、中英文混说,或者说话人吞音严重,声学层拿不准的时候,后面缺乏足够强的上下文推理能力去“兜底”。
以前工程团队为了补这个短板,通常会在声学模型后面再串一个外挂语言模型做重打分,或者在有限状态转换器里塞进几千个业务热词。这套打补丁的路子维护起来相当折腾:热词权重调低了不起作用,调高了又会把正常句子里的近音词硬生生拽成术语,闹出不少笑话。比如把日常寒暄里的普通动词强行替换成某款药品名字,售后回访人员听录音核对时还得一行行手动改回去。
挂上语言模型解码器到底改了哪一步
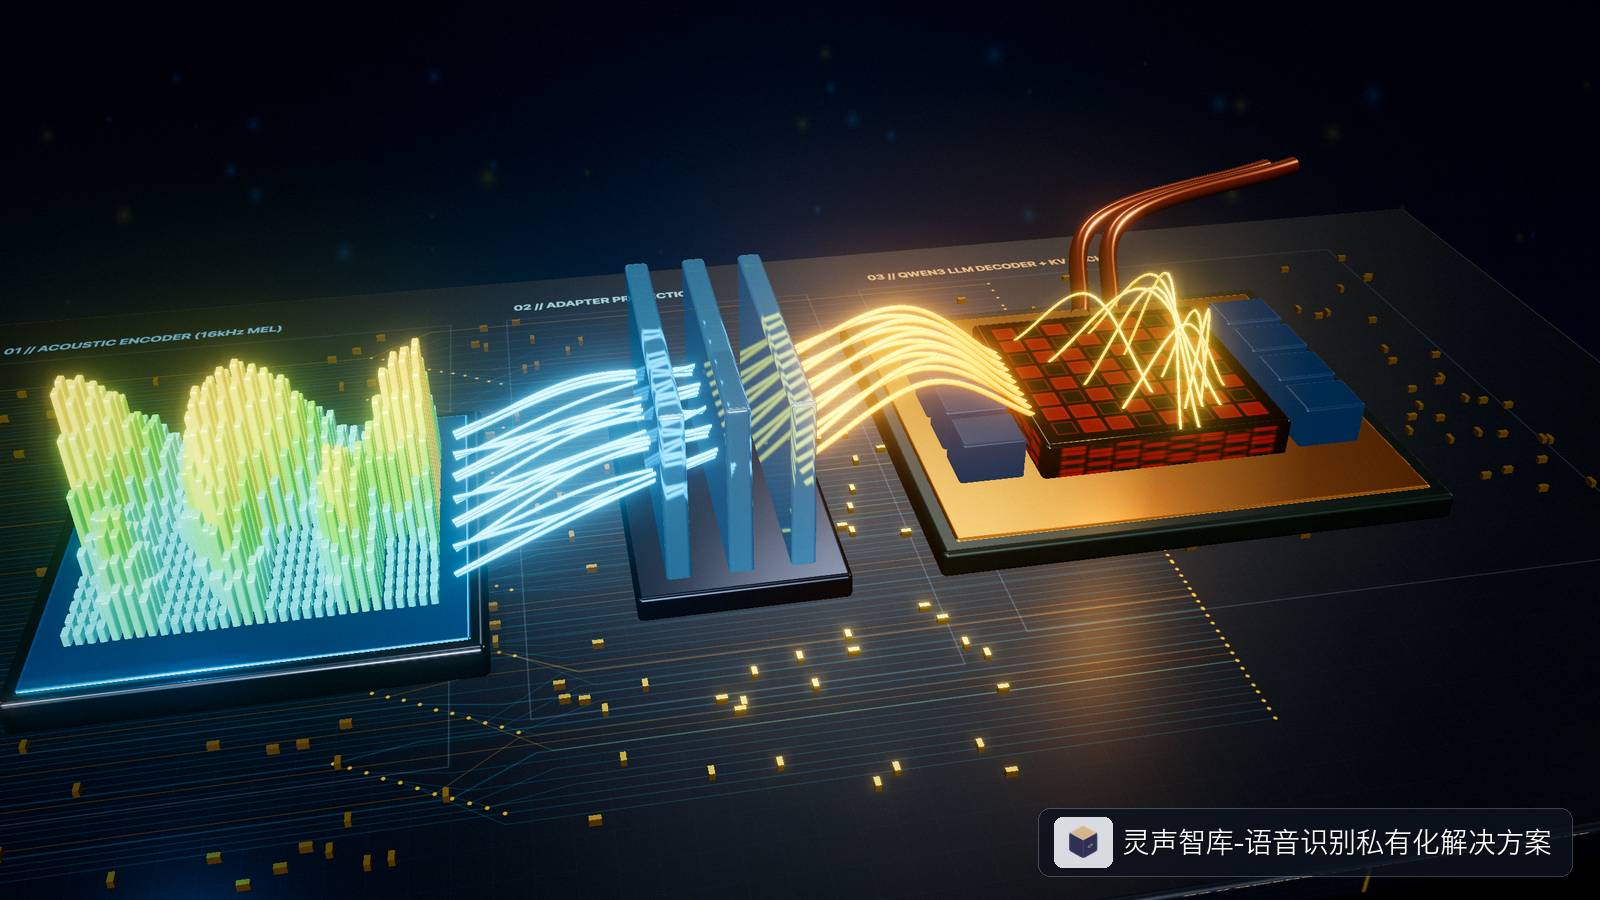
Qwen3-ASR 这类新架构的思路很直接,不再搞“声学认字加外挂词表修补”的两张皮,而是前端保留多层卷积与注意力编码器提取连续声学表征,经过下采样压缩帧率之后,通过一层轻量投影网络,把音频特征直接对齐到 Qwen3 语言模型的词嵌入空间里。
换句话说,语言模型看到的前缀不再是冷冰冰的拼音或候选字格,而是一串浓缩后的连续声音切片。接下来吐字的过程,完全复用了海量语料喂出来的因果语言解码器。
这种结构带来了一个立竿见影的变化:上下文偏置变得相当顺手。以前塞热词得重新编译解码图,现在只需要在解码提示区直接放进本场会议的议程单、参会人名单或者科室常用药名缩写,语言层在自回归逐词生成时,自然会根据前文语境把模糊音拉回正确的专业词汇上。哪怕说话人中间夹了半句英文接口名,又突然切回带方言口音的中文解释,模型也不太容易像传统声学架构那样在语种切换边界上崩出一串乱码。
不过塞提示词也有个暗坑:提示区里的术语表不能无节制地往里堆。实战压测时经常发现,一旦往提示区塞进超过两三百个生僻词,语言解码器的注意力就会被长长的候选名单分散,遇到发音含糊的半截话时,反而会凭空从提示词表里挑一个根本没在录音里出现过的词硬凑上去。比较稳妥的做法是结合业务工单号或会议室预约信息,按场次动态筛出二三十个当场真用得上的高频专名塞进去,比整本词典一股脑全喂进去干净得多。
音频帧率压缩在这里帮了大忙。原始语音按十毫秒一帧算,一秒就是一百帧;经过编码器多层卷积折叠后,往往能压到每秒十二帧到二十五帧左右。即便如此,它依然比纯文本占地方——人正常说话一秒也就三四个字,折算下来音频特征吃掉的上下文窗口长度,依然是同等内容文本的三到六倍。
算力真账:准确率涨了,并发掉多少
账不能只算准确率这一头。把非自回归换成自回归语言解码器,机房里的显卡负载立马就变了天。
非自回归是一把算出整句矩阵,显卡的浮点运算单元吃得饱饱的;而自回归解码是吐完前一个词元,才能算下一个词元,每走一步都得把解码器好几十亿参数的权重从显存搬到计算核心里过一遍。这时候卡住吞吐量的不再是算力峰值,而是显存带宽,每张卡的键值缓存还会随着音频时长一路往上涨。
拿常见的二十四吉字节显存单卡来算一笔粗账:跑轻量级非自回归语音模型,单卡稳稳撑住上百路流式并发并不罕见,批处理攒一攒还能更高;换成七十亿参数级别的音频语言融合模型,就算上了四比特权重量化和分页键值缓存,既要装模型本体权重,又要给多路并发留出声学编码特征与解码缓存,单卡能同时接住的实时路数往往会缩水一个数量级,首字响应时间也会从几十毫秒抬升到两三百毫秒区间。
如果是离线批量跑历史录音归档,靠连续批处理把批次塞满,吞吐劣势还能追回来一部分;但要是放在早高峰几百个坐席同时进线的实时电话场景,全量用大模型硬扛,服务器采购预算分分钟翻上好几倍。
机房里更务实的双路混跑法
真正在内网机房落地的团队,很少非黑即白地二选一,大家摸索出来的省钱路子大多是“快慢双路分流”。
所有实时进来的音频流,头一道关依然交给轻巧的非自回归小模型,几十毫秒先把实时字幕投上屏幕,同时顺手吐出每一句的声学置信度分布。大部分日常沟通句子置信度都很高,直接落库完事,根本不劳烦后面的大家伙。
只有当小模型在某个片段出现词元置信度明显塌陷、中英混杂切分混乱,或者命中业务预设的关键风险条款区域时,调度器才把前后十几秒的原始音频切片连同上下文词表一起,异步塞进 Qwen3-ASR 这类大模型队列里做二次精校。这样一来,只有不到两成的疑难片段真正消耗自回归算力,整套集群既保住了专业术语和复杂口音下的成稿质量,又不用跟着扩充一堆高价显卡。
当然,要是团队手头维护的只是标准普通话指令控制、固定话术播报核验,或者运行在只有几瓦功耗预算的嵌入式工控盒子里,连双路混跑都不用考虑,老老实实把轻量声学模型调顺就够用了,没必要为了追新架构背上沉重的显存包袱。