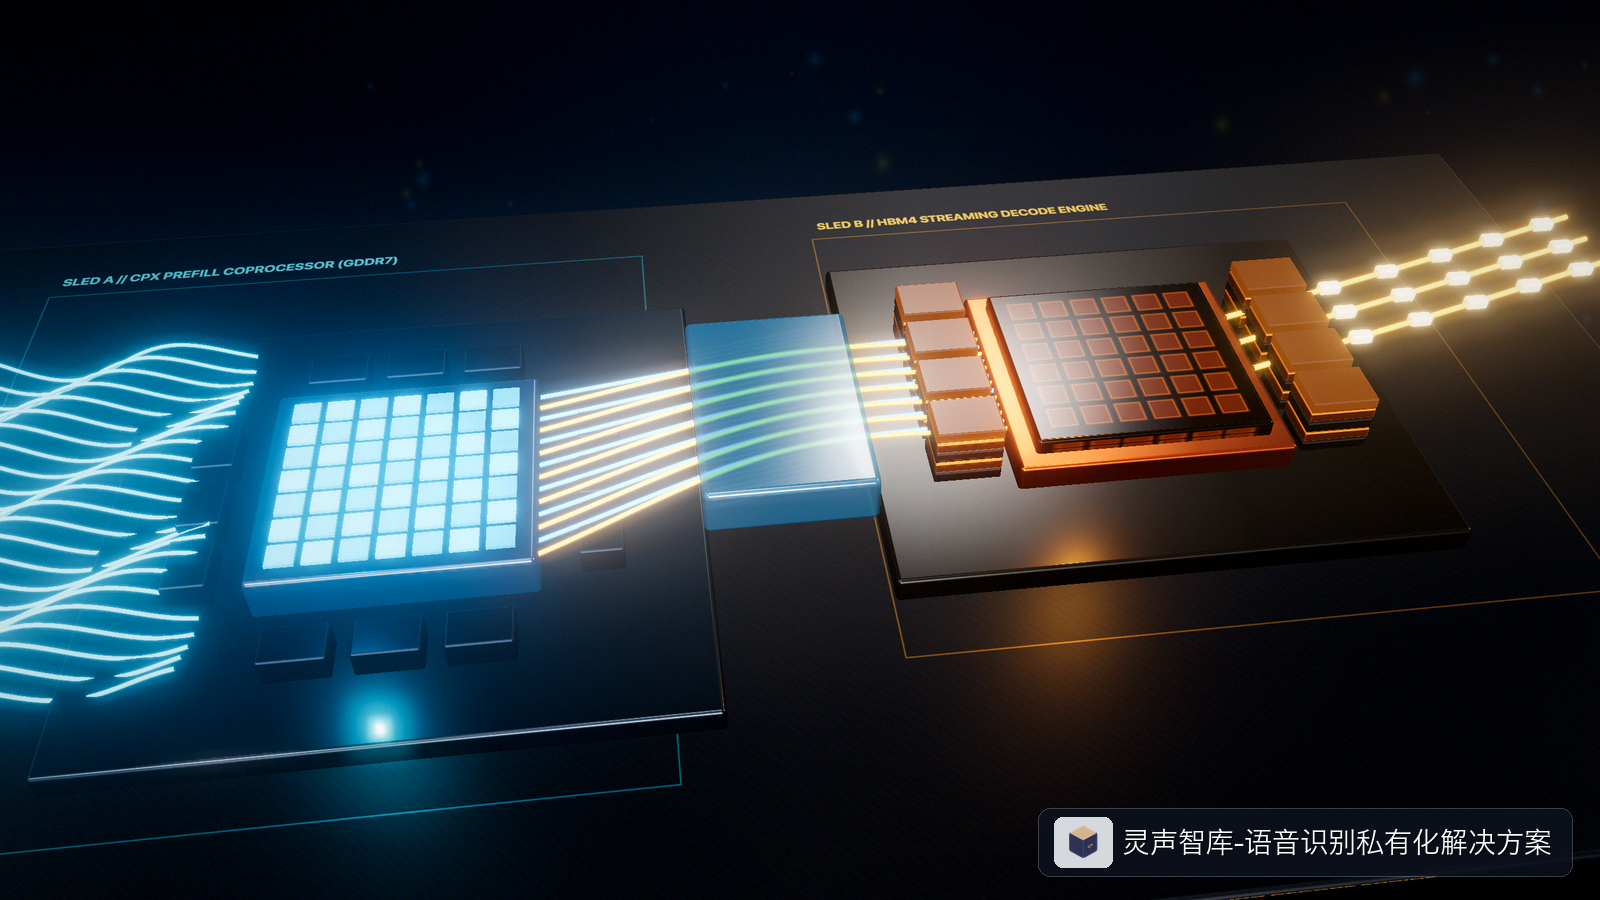
英伟达在公开新一代 Vera Rubin 机架方案时,除了常规秀出三纳米制程和 HBM4 显存带宽之外,还悄悄塞进了一个很有意思的新物种——Rubin CPX 协处理器。这颗芯片不配昂贵的 HBM4,反倒挂着成本低一截的 GDDR7 显存,干的活非常专一:把大模型推理前半程的预填充(Prefill)单拎出来自己扛,让配了超宽显存总线的主 GPU 专心干后半程的逐词解码(Decode)。
很多只关注文本聊天的朋友觉得这是超算中心才操心的事。其实只要你在企业机房里维护过一套既接实时电话流、又接会议长录音归档的语音大模型集群,看到这张硬件架构图大概会会心一笑——平时线上偶发的“实时字幕突然卡死半秒钟”,病根跟英伟达要拆硬件解决的是一模一样的事。
同一张显卡干着两份脾气相反的活
先把语音或文本进大模型后的两个阶段拆开看,就能明白为什么混在一起跑会打架。
前半程叫预填充。比如用户刚上传了一段四十分钟的部门周会录音,或者带上了好几万字的背景资料,音频编码器切出来的几万帧声学特征一股脑涌进来,显卡要做的是大规模并行矩阵乘法,一次性把这几万帧全算完并填满键值缓存。这一步是典型的“算力饥渴型”重活,一脚油门踩下去,张量计算核心瞬间拉满,单次前向耗时动辄几百毫秒甚至上秒。
音频请求在前半程比纯文本还要霸道得多。原因很实在:一段三十分钟的普通会议录音,哪怕声学编码器已经做了四倍到八倍的时间步下采样,折算出来的连续音频特征序列依然动辄好几万步,外加前端梅尔频谱变换与多层自注意力编码本身就要先吃一轮密集矩阵运算。同样是一份会议内容,整理成文字稿可能也就八千个词元,原始音频流塞进来预填充时的计算量却往往翻了好几番。
后半程叫自回归解码。缓存填好了,模型开始一个词元接一个词元往外蹦字。每次只算一个新位置,计算量小得可怜,可每蹦一个字都得把模型几十吉字节的权重和历史键值缓存从显存里重读一遍。这一步变成了“显存带宽饥渴型”细活,讲究的是每一步必须在十几到二十几毫秒内准时交差,一旦中间顿一下,前端盯着实时字幕或等着语音回话的人立刻就能察觉卡顿。
麻烦就出在把这两类请求扔进同一个连续批处理队列的时候。原本一张卡正在稳稳当当地给二十路实时通话做逐字解码,每隔二十毫秒顺滑吐出一批词元;突然旁边行政系统推过来一段半小时的离线录音做预填充,几万个声学帧插进当前批次里一算,整张卡的计算单元被死死占住四百毫秒。那二十路正在实时说话的通道,就得陪着一起干等这四百毫秒——监控大盘上的平均吞吐量看着挺漂亮,九十九分位尾延迟却直接炸穿了实时红线。
硬件分家背后的成本算盘
看懂了这个冲突,再回头看 Vera Rubin 把 Rubin CPX 独立出来的刀法就非常合乎工程直觉了。
既然预填充拼的是并行算力、对超高显存带宽没那么挑剔,那就拿配 GDDR7 的协处理器去硬啃海量上下文吞吐,每吉字节显存成本还能降下一大截;算完生成的键值缓存通过高速互连总线推给配了 HBM4(带宽突破每秒二十二太字节级别)的主 GPU,主卡不被长序列预填充打断,安安心心维持稳定的毫秒级解码节拍。
大厂可以靠定制硅片做物理分家,绝大多数企业自建内网机房可没条件立马换上整柜新硬件。大家手头跑着的往往是四卡或八卡的常规服务器,卡间甚至未必有全速互连桥,走的还是标准 PCIe 总线。这种条件下照搬“跨卡传键值缓存”那一套,光是把一段长音频生成的几吉字节缓存从一号卡拷到二号卡,PCIe 带宽就能先堵成停车场。
普通四卡与八卡机房怎么低成本照抄思路
虽然没法在单次请求内部频繁跨卡搬运大块缓存,但“预填充重活”和“实时流细活”物理隔离的思路,在常规多卡服务器上照样能落得漂漂亮亮,改造成本也很低。
头一招是按音频块长度在网关层硬切泳道。四卡机器里,明确划出两张卡只接流式短分片请求,并强制开启分块预填充(Chunked Prefill),把每次塞进批次的声学帧上限锁死在固定小窗口内,哪怕来了稍长的历史上下文,也拆成好几拍慢慢消化,绝不许单拍霸占显卡超过五十毫秒;剩下两张卡专门划作离线长音频与文档摘要池,批次怎么大怎么来,把显卡算力吃干榨净,哪怕单步算上两秒也不碍任何实时用户的事。
网关层的转发规则也不用搞得多玄乎,直接看请求头里的流式标记和上传音频字节数就能分流:凡是走长连接流式协议、单帧切片在几百毫秒以内的会话,一律打进低延迟泳道;凡是整包上传超过三十秒录音文件、或者附带长篇历史纪要重排的异步任务,统一丢进后台消息队列,由长序列池按空闲算力慢慢拉取消费。两拨流量连进程和显存池都不共享,监控图表上的尾延迟毛刺当场就能掉下一大截。
另一招是管住语音活动检测(VAD)切出来的畸形超长段。现场调试时经常遇到一种冤枉卡顿:会议室里有人讲演示文稿一口气连说四分钟不喘大气,或者背景风扇噪声偏高导致静音切分一直没触发,前端攒出一个超长音频包突然砸向实时推理池,瞬间制造出一次小型预填充洪峰。在送进编码器之前加一道硬性滑动窗口上限,比如满二十五秒哪怕没停顿也先在低能量谷底软切一刀,就能把这种隐形毛刺削平大半。
什么时候完全没必要折腾这套分离调度?如果你的机房压根没有实时流式业务,每天只是定时任务在半夜跑白天的录音转写归档,又或者总共只有三五路并发、显卡常年有一半时间闲着,那单池混跑省心又好维护,多拆一套队列反而徒增运维监控负担。只有当同一套集群既要保前排坐席的毫秒级响应,又要吞后台成堆的长录音长文档,且高峰期九十九分位延迟频频越过三百毫秒警戒线时,把“重吞吐”和“稳节拍”拆进不同笼子里,才是花小钱治大病的正经路子。