这阵子不少企业内部技术团队在升级本地模型服务时,都踩过同一个让人哭笑不得的坑:看开源榜单挑中了当红的混合专家(MoE)模型,比如 Qwen 3.5 系列的大尺寸稀疏版本或者 DeepSeek 新一代开源权重,技术选型报告上写得漂漂亮亮——“单次前向推理仅激活三十亿或几十亿参数,计算开销跟轻量小模型相当”。结果采购部门按跑七十亿稠密模型的预算批了两张二十四吉字节显存卡,机器上架一拉镜像,连模型权重的一半都塞不进去,当场报显存溢出。
问题就出在“算力省了”和“显存省没省”根本是两码事。在按调用量计费的公有云大集群里,几百张卡拼成一个大显存池摊薄了驻留成本,稀疏激活确实划算;可一旦搬进只有单机四卡或双机八卡的企业本地机房,算账逻辑立马翻了个个儿。
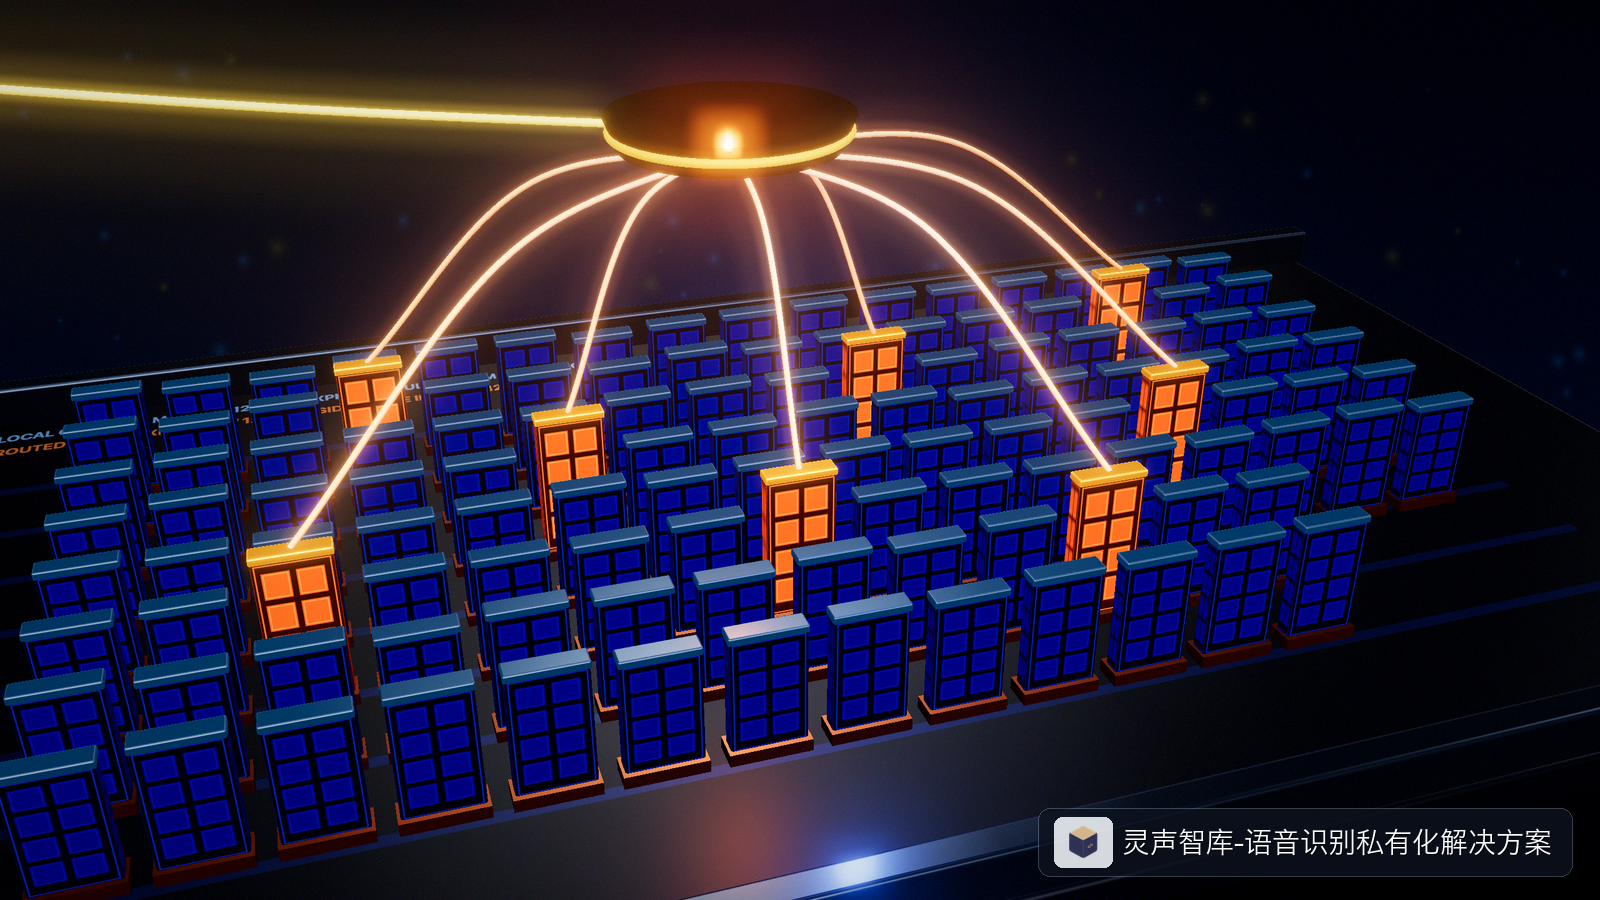
算力按激活算,显存得按户口本全员算
混合专家架构的脾气,用机房值班打比方特别好懂:一个大厅里坐着一百二十八名不同专业的顾问,每次进门一个词元,门口的路由网络只挑其中四名或八名顾问站起来干活。就单次计算的浮点乘法次数而言,确实只付了八个人的力气钱。
但麻烦在于,你完全猜不到千分之一秒之后进来的下一个词元会点谁的名。要是把暂时没被点到的另外一百二十名顾问赶回机械硬盘或者主机普通内存里待命,等点到名再顺着 PCIe 总线往显卡里临时搬,哪怕是 PCIe 5.0 通道,每秒几十吉字节的传输速率在几百吉字节每秒甚至上太字节每秒的板载显存带宽面前,也慢得像牛车。
尤其在语音转写后的实时纪要结构化、坐席话术实时纠偏这类并发场景里,同一批次里并排跑着十几路不同用户的句子:A 坐席在聊车险定损,点亮了金融条款相关的专家子网;B 坐席在报服务器故障码,点亮了运维代码相关的专家子网。几路请求往一块儿一凑,每一轮解码几乎把大半个池子的专家都摸了一遍。想保住每秒几十词元的正常吐字速度,所有专家的权重参数就得老老实实全员常驻在显卡板载显存里,一个都不能少。
不妨拿一台插了四张二十四吉字节显卡、总显存九十六吉字节的常规机架服务器摆开算算细账。假设选了一款总参数一千二百亿、每次只激活一百亿参数的开源稀疏模型,哪怕把权重压到四比特量化,光模型静态权重本身就要吃掉六十多吉字节显存;再扣掉四张卡各自的运行时上下文、算子工作区缓存以及多卡张量并行通信缓冲区,真正留给分页键值缓存的空余显存往往只剩十几吉字节。这点余量跑两三路短对话还凑合,一旦塞进十几路带长篇历史会议转写稿的并发请求,显存池立刻见底,框架只能被迫把排队请求踢回等待区,吞吐量反倒不如踏踏实实跑一个体量匹配的稠密模型。
内存卸载在哪些场景能凑合,哪些场景会翻车
很多开源推理框架(比如主流的异构卸载引擎)确实提供了“热门共享层放显卡、冷门路由专家放主机 DDR5 内存并用多核 CPU 帮忙算”的折中跑法。这套方案能不能救场,完全取决于你跑的是单人离线慢活,还是多人在线急活。
如果你只是在办公室工作站上挂一个后台脚本,趁夜里把白天积攒的十几份访谈转写稿慢慢抽成结构化档案,哪怕每秒钟只蹦出六七个字,一晚上照样能跑完,用大内存配单张显卡跑异构卸载确实能省下一大笔硬件采购费。
可要是把它接在实时语音对话链路后面,用户说完话等着耳机里回音,或者电话挂断三秒内必须在业务系统弹出填好的工单,CPU 内存带宽和跨总线同步开销就会变成致命短板。一旦并发从一路涨到八路,多路请求在主机内存通道上争抢随机专家切片,单步解码延迟会从二三十毫秒陡增到两三百毫秒,整条语音流水线直接堵死在后半截。
压低比特量化时容易忽略的路由抖动
不想加卡,又不想退回主机内存慢吞吞地跑,很多团队自然会想到往四比特甚至更低比特硬压权重量化。
稠密模型压到四比特(如成熟的分组对称或非对称量化),精度折损通常比较温和,调好校准集基本能兜住。稀疏混合专家模型压低比特时却多了一处敏感神经——门控路由层,以及那些平时很少被激活、但专门存着生僻行业术语与冷门公式的细分专家块。
如果在做校准量化时,只拿了几百条通用日常对话去跑激活统计,那些专门管医疗器械编码、化工原料名称或者地方规章简称的稀疏专家分支可能全程都没被触发几次,量化缩放因子算得粗糙不堪。上线之后普通聊天看着挺正常,一碰到生僻词转写纠错,路由权重轻微一偏,原本该接活的专业分支没选上,直接滑进通识分支里瞎编了一个近音词。
所以真要在内网有限显存里跑 MoE 量化版,门控路由层和共享专家层往往得保留高精度(十六比特浮点或八比特),只对体量大头的常规路由专家做四比特压缩;校准语料也得把自家业务里难啃的录音转写文本掺进去实打实跑一遍激活分布,确保冷门分支的缩放系数不被通用闲聊语料带偏。
多卡切分方式同样有讲究。稠密模型跨四张卡做张量并行,每层通信一次也就完事了;稀疏模型要是跨卡做专家并行,不同显卡上的专家负载一旦失衡——比如某段录音全在聊法律合同,恰好全挤到二号卡那几个专家身上——其他三张卡就得干等着二号卡算完才能进下一层,板卡间没有高速互连桥的普通 PCIe 服务器在这儿很容易吃暗亏。
四卡以内的小机房怎么选更省心
说到底,给本地内网挑模型不能光看开源排行榜总分,得先拿卷尺量自家机柜的显存总池子。
在单机两卡到四卡(总显存九十六到一百九十二吉字节区间)的常见企业私有配置下,与其硬塞一个总参数几百亿、压到极低比特还得抠抠搜搜留不出多少键值缓存空间的巨型 MoE 模型,不如直接选同代三十亿到三十二亿参数级别的稠密模型做针对性微调,或者选总参数控制在三十亿左右、激活三四十亿的小体量稀疏模型。留出充裕的显存余量给多路长语音上下文缓存和批处理队列,线上跑起来的尾延迟和稳定性,往往比硬扛大号稀疏模型踏实得多。