做会议转写项目的团队,大都经历过演示现场和真实交付现场的心理落差:拿标准开源测试集测字错率,图表上个位数好看得很;测试工程师自己在工位戴着耳麦录一段十分钟独白,标点断句也挑不出几处毛病。结果设备一搬进客户那间三面落地玻璃墙的大会议室,十个人围着长桌开上两小时项目协调会,导出来的文稿里突然冒出连续十几行一模一样的“感谢观看”“请订阅频道”,到了下半场连字幕时间戳都比原声慢了足足七八秒。
这不是模型突然变傻了,而是公开评测榜单压根没考“长静音底噪”“多人抢话混叠”和“跨小时切片拼接”这三道脏活累题。要把开源语音模型训成能交差的会议记录员,真正费工夫的往往不是换更大的主干网,而是把模型前后的声学管线一寸寸拾掇干净。
空调嗡鸣为什么会诱发成串的“礼貌用语幻觉”
先说那个让人头疼的循环复读和凭空编词。以 Whisper 系列为代表的编码器加自回归解码器架构,当年训练时喂进去大量带网络视频字幕的弱监督音频。这类野生数据里有个隐蔽规律:每当视频片尾音乐响起、或者画面静音黑屏的几秒钟,对应的字幕轨往往挂着制作者留下的“谢谢收看”“字幕由某某压制”。
到了真实会议室里,中间茶歇大家低头翻材料没说话,或者投影仪风扇与中央空调出风口持续发出五十到一百五十赫兹的低频嗡鸣。如果前端没有把这段纯底噪拦住,原封不动切进三十秒音频窗喂给模型,编码器特征落在低能量模糊区,自回归解码器一旦在开头试探性地吐出一个常见虚词,紧接着就会顺着自身的语言先验滑进死循环,把记忆深处的片尾套话一句接一句默写出来;要是开启了“以上一窗口输出作为下一窗口提示词”的跨窗连贯开关,前一个窗口吐出的复读机废话还会污染后面好几个正常说话的窗口。
治这个毛病不能指望单调解码温度参数,得在进模型前立两道闸门。头一道是基于神经网络的语音活动检测(如精细调优过的 Silero VAD 或 FSMN-VAD),把无人说话的纯空调底噪段直接剪除,不给解码器对着白噪声瞎猜的机会;后一道是解码后的压缩比与对数概率双阈值拦截——凡是某一段输出文本的字符重复压缩比异常偏高,或者平均词元对数概率跌穿安全线,立刻丢弃重算,同时果断清空跨窗口历史提示词,切断复读传染链。
三个人同时插话时,单通道模型听到了什么
圆桌讨论跟领导念稿宣讲完全是两种声学物理环境。一讨论到预算分摊或排期责任,经常是主持人的话还没落地,左边业务代表已经插进来反驳,右边技术人员又补了一句参数说明,外加玻璃幕墙把零点五秒前的尾音反射回来叠在一起。
单通道语音识别模型本质上假设同一时刻只有一个主声源在说话。当两三路频率相近的人声在时频图上撞车时,梅尔频谱的谐波纹路全部糊成一团,模型要么挑嗓门大的那个人断断续续认几个词,要么把甲的前半句和乙的后半句硬缝成一句谁也没说过的话,事后分角色纪要更是无从谈起。
面对这种硬伤,如果硬件条件允许在桌面布设多麦克风阵列,前端先跑一遍自适应波束成形与盲源分离,顺着不同座位的声波到达时间差把各个方向的拾音波束锁定住,混响和邻座串音能当场削掉一大截。要是现场只给了一支单声道全向麦或者历史留存的单轨录音文件,那就不能直接往转写引擎里硬塞,需要先过一层重叠语音检测(OSD)与说话人日志切分模块:凡是标出双人以上声纹同时活跃的几秒钟片段,先调语音分离网络拆成两条独立声轨分别识别,再按起止时间合流回主轴。虽然分离步骤会多吃一点算力,总好过把两方的相反意见拼成一条张冠李戴的会议结论。
两小时录音切块跑完,时间戳为什么越飘越远
再来拆另一个常被忽视的暗坑:长录音的时间轴漂移。
绝大多数语音模型单次接收的音频窗口在二十秒到三十秒之间。处理两小时长录音时,有些图省事的脚本直接按固定三十秒一刀切开,算完把每段内部预测的相对时间加上偏移量往一块儿一拼。只要中间某几刀恰好劈在一个长音节的半腰上,或者把静音段吞算了零点二秒,累计两百四十刀切下来,到了会议后半程,文字时间戳跟真实说话位置就能差出好几秒;前端播放器做“点哪句字跳到哪秒原声”功能时,一点过去听到的全是上一句的尾巴。
靠谱的工程切法从来不在固定秒数硬剁,而是先由语音活动检测扫描全片,专挑超过四百毫秒的自然停顿换气处下刀,把长录音切成十几秒到二十几秒不等的自然语义块,并在相邻切块边界保留一到两秒的重叠缓冲区,合并文本时用公共子串滑动比对把重叠区的重复字扣掉。
切块拼接完还有个不起眼但很影响阅读体验的小尾巴:标点与说话人切换边界错位。很多流水线是先把整段字拼好,再丢给独立的标点恢复小模型补逗号和句号,结果甲刚说完半句疑问、乙抢着接了三个字,标点模型不懂声纹已经换人了,顺手打个逗号把两个人的话连成了同一句。实操中应当先把声纹切分出来的说话人转换时间点当成硬隔离墙,优先在换人处强制截断换行,再在各自独立的发言块内部跑标点恢复,导出来的会议纪要才不会出现前后语气拧巴的怪句。
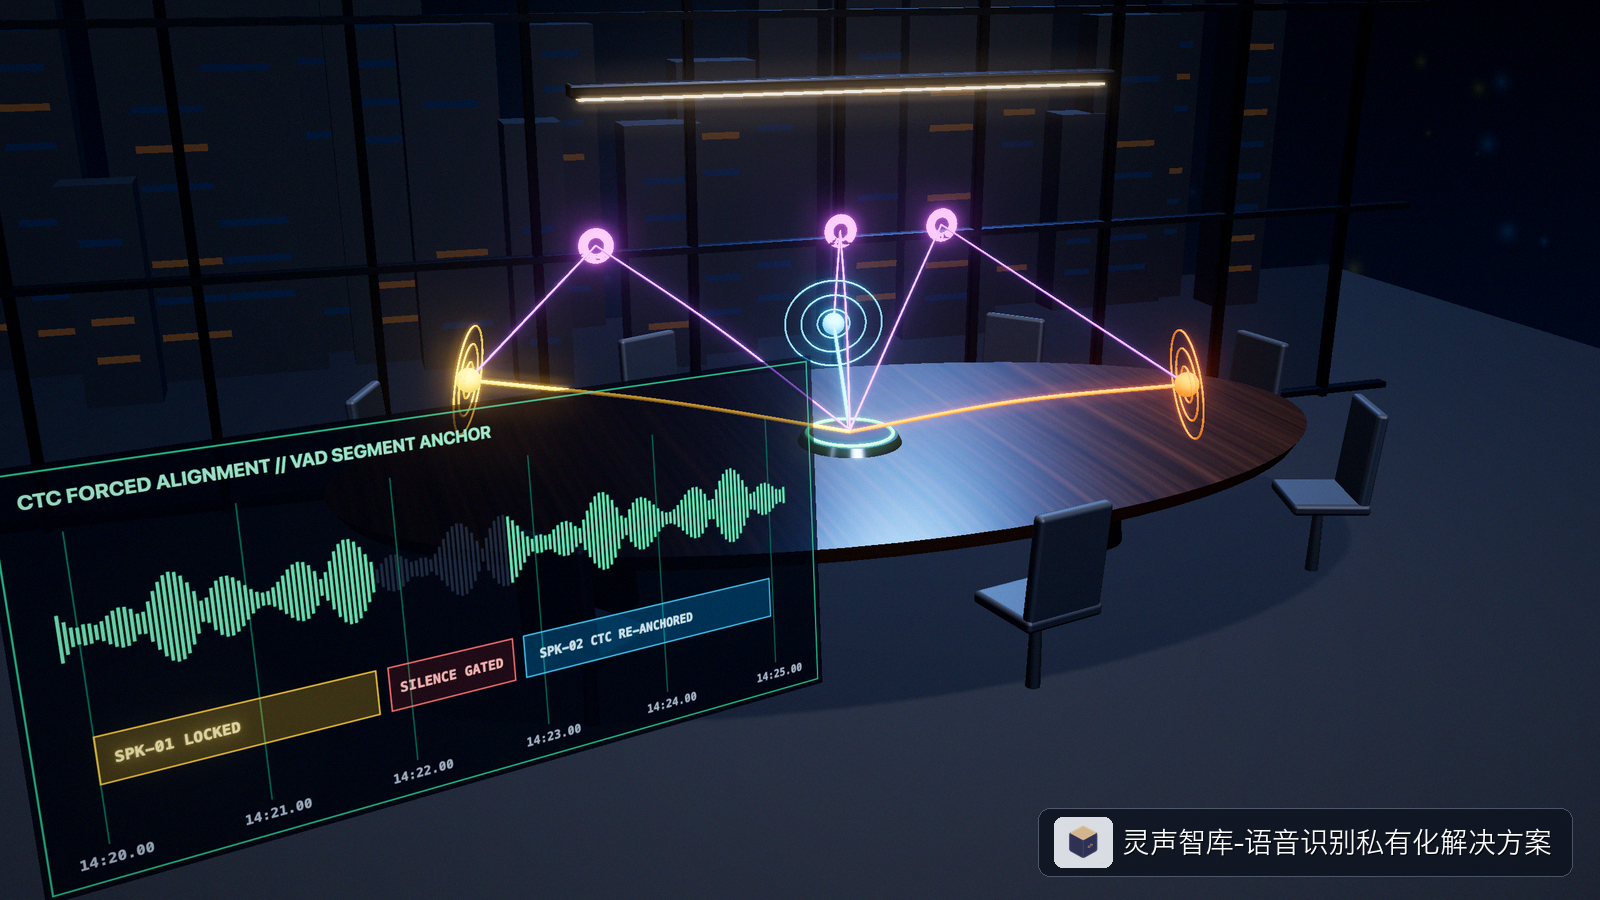
如果业务对逐字卡点精度要求极严(比如庭审质证回放或字幕打轴),连解码器自带的粗粒度时间戳都不要直接采信——因为注意力机制预测出来的时间边界天生带有几百毫秒的软模糊。更稳妥的办法是在整段转写文字定稿之后,拿轻量级的连接时序分类(CTC)声学小模型对着原始音频帧和定稿文本做一遍强制对齐(Forced Alignment),利用维特比路径反推出每个字对应的十毫秒级帧起止位置。这一步纯前向计算极快,两小时录音几秒钟就能把整条时间轴钉得严丝合缝。
当然,要是录音本身只是单人对着领夹麦录制的线上培训课,既没玻璃房混响也没人插话,直接用常规流式切分跑一遍就够干净了,犯不着把声源分离和二次强制对齐全套重武器都挂上去空耗机器。