多模态不是把几个接口接在一起
把语音转成文字,再把文字交给语言模型,看起来已经可以完成一次多模态交互。真正进入会议、质检或资料归档系统后,问题会迅速增加:语音从哪一秒开始,画面中的人是谁,屏幕上的表格对应哪段发言,模型输出能不能追溯到原始音频。
多模态系统的难点不在于展示一个漂亮的演示,而在于让不同来源的数据保持时间关系。音频有采样时钟,视频有帧时间戳,业务系统还有自己的任务时间。只要其中一处漂移,最后生成的记录就可能把一句话挂到错误的画面上。
音频是多模态入口里的硬骨头
语音识别通常先承担转写和时间标记。会议室麦克风、手机录音、电话通道和现场摄像机的音频质量差异很大,系统需要先完成采样率统一、声道处理和语音活动检测。多人抢话时,还要判断文本属于谁,不能把说话人分离当成一个附加标签随手处理。
切片策略会直接影响后面的对齐。片段太短,模型看不到足够上下文;片段太长,首字等待和缓存占用都会增加。比较稳妥的做法是保留一定重叠,并在合并时依据时间戳和文本相似度去重。发生断线重连时,服务端还要识别已经处理过的片段,避免同一句话写入两次。
对齐比生成更容易出错
语音文字、画面帧和业务事件要放到同一条时间轴上,需要先明确时间基准。录音设备的时钟可能比服务器快或慢,视频编码也可能带来缓冲。若只用消息到达时间代替采集时间,网络抖动就会被误认为内容发生时间。
工程上可以为每个音频片段保留采集时间、接收时间、推理完成时间和展示时间,视频则保留帧时间戳。生成报告时使用采集时间做对齐,系统日志使用接收和完成时间做排障。两套时间不能混用。
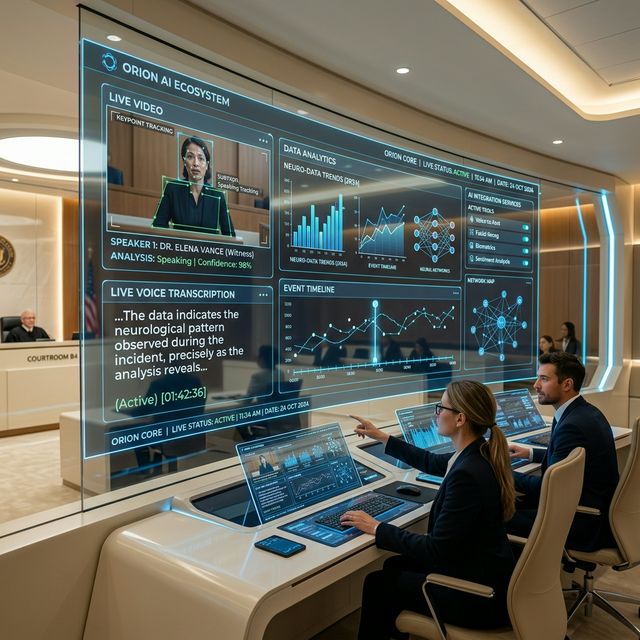
对于医疗影像、庭审记录和金融双录,关键结论还要能回到具体音频和画面。系统应当保存引用位置,而不是只输出一段看似完整的摘要。
本地推理要把资源分给不同任务
语音识别、图像编码、向量检索和语言模型推理可能同时占用同一台服务器。实时转写需要短等待,批量归档可以排队,图像任务有时又会突然产生显存峰值。如果所有请求共用一个队列,任何一项任务的波动都会传到其他环节。
调度层需要知道任务类型、预估资源和允许等待时间。音频接入可以采用小批量聚合,摘要生成则可以在转写完成后异步执行。对于没有公网的机房,还要提前准备模型文件、容器镜像、驱动和回滚包,升级流程不能依赖临时联网。
量化和模型裁剪能降低设备压力,但应当用真实样本复核。音频识别结果出现一个专业词错误,可能会改变后续检索;图像编码精度发生变化,也可能影响跨模态召回。速度和质量要一起验收。
权限要贯穿整条链路
多模态资料常常比单纯文本更敏感。会议录音、视频、截图、转写稿和摘要不能默认使用相同权限。某个用户能查看摘要,不代表他可以下载原音频;能查看一场会议,也不代表他能搜索所有历史资料。
权限控制应当同时存在于前端、接口、对象存储和检索层。删除策略也要一致,原始音频被清理后,向量库和缓存中的相关内容不能继续被检索出来。操作记录需要包含访问者、任务、时间和数据范围,便于事后核查。
多模态系统真正成熟的标志,不是一次回答能覆盖多少种数据,而是每个结果都能说明来自哪里、经过哪些处理、由谁可以查看。语音转写只是入口,时间对齐、资源调度和权限边界才决定它能否进入日常工作。
检索系统还要处理模态之间的差异。用户说出一个设备名称,可能希望找到一段维修录音,也可能是在找一张现场照片。文本索引、音频片段和图像向量的召回结果不能简单混在一起排序,需要保留来源、时间和权限信息,再交给业务规则做二次筛选。
摘要生成则要设置可回听入口。模型提取出的“决定事项”如果没有对应的音频时间点,工作人员很难确认它是否漏掉了限定条件。会议记录可以同时保存原句、说话人、时间戳和摘要,后续修改时也能看出哪一步发生了偏差。
多模态项目适合从单一流程开始,例如先做会议转写和资料检索,再逐步加入图像。每增加一种数据,就重新检查存储、权限和删除规则。一次把所有能力堆上去,演示看起来丰富,出了问题却很难判断是哪条链路出了错。